最近在研究Coding Agent这块,有个事让我挺意外的。
一个叫Pi的项目,GitHub星标数从几百涨到了几万,不到一年。这速度放在今天AI项目满天飞的环境里,也算炸裂了。
但真正让我愣住的不是涨星速度。
是它的官网第一句话。
不是「最强大的编程Agent」,也不是什么「AI编程新纪元」。就一句朴素到有点意外的话。
Pi是一个极简的agent harness。
我当时就寻思,harness是啥?极简又是啥意思?一个能在不到一年里星标涨到几万的项目,凭什么敢说自己是「极简」???
然后我打开了Claude Code的能力清单。
文件读写、Shell执行、Web搜索、MCP协议对接、Skills系统、Hooks钩子、Memory记忆、Plan Mode计划模式、Subagents子智能体、Agent Teams团队协作、Plugins插件、Permission权限系统。Anthropic甚至把Claude Code背后那套agent loop、上下文管理、工具调用的底层能力,直接封装成了Agent SDK,让你照着这个思路自己搭Agent。
= =功能是真多。
按正常的产品逻辑,功能越全,应该越有优势。Agent这种东西本来就要和真实世界打交道,多一个工具、多一层记忆,似乎都能让它更像一个能干活的人。
但Pi反着来。
这篇文章不打算下「Pi比Claude Code强」这种简单判断,那样比较没意义。更准确的说法是,Claude Code代表今天最好用的一类Agent产品,Pi更像是在探索Agent未来应该怎样被组织。标题里「更接近最终形态」,说的是架构思想,不是当前产品的胜负。
真正的问题是,我们是不是把Agent做复杂了?
说到这个,得先聊一个被很多人忽略的概念。
平时讨论Agent,大家很容易混在一起讲。有人说模型强,有人说工具多,有人说上下文长,有人说MCP生态好。但一个Agent真正跑起来,至少分三层。
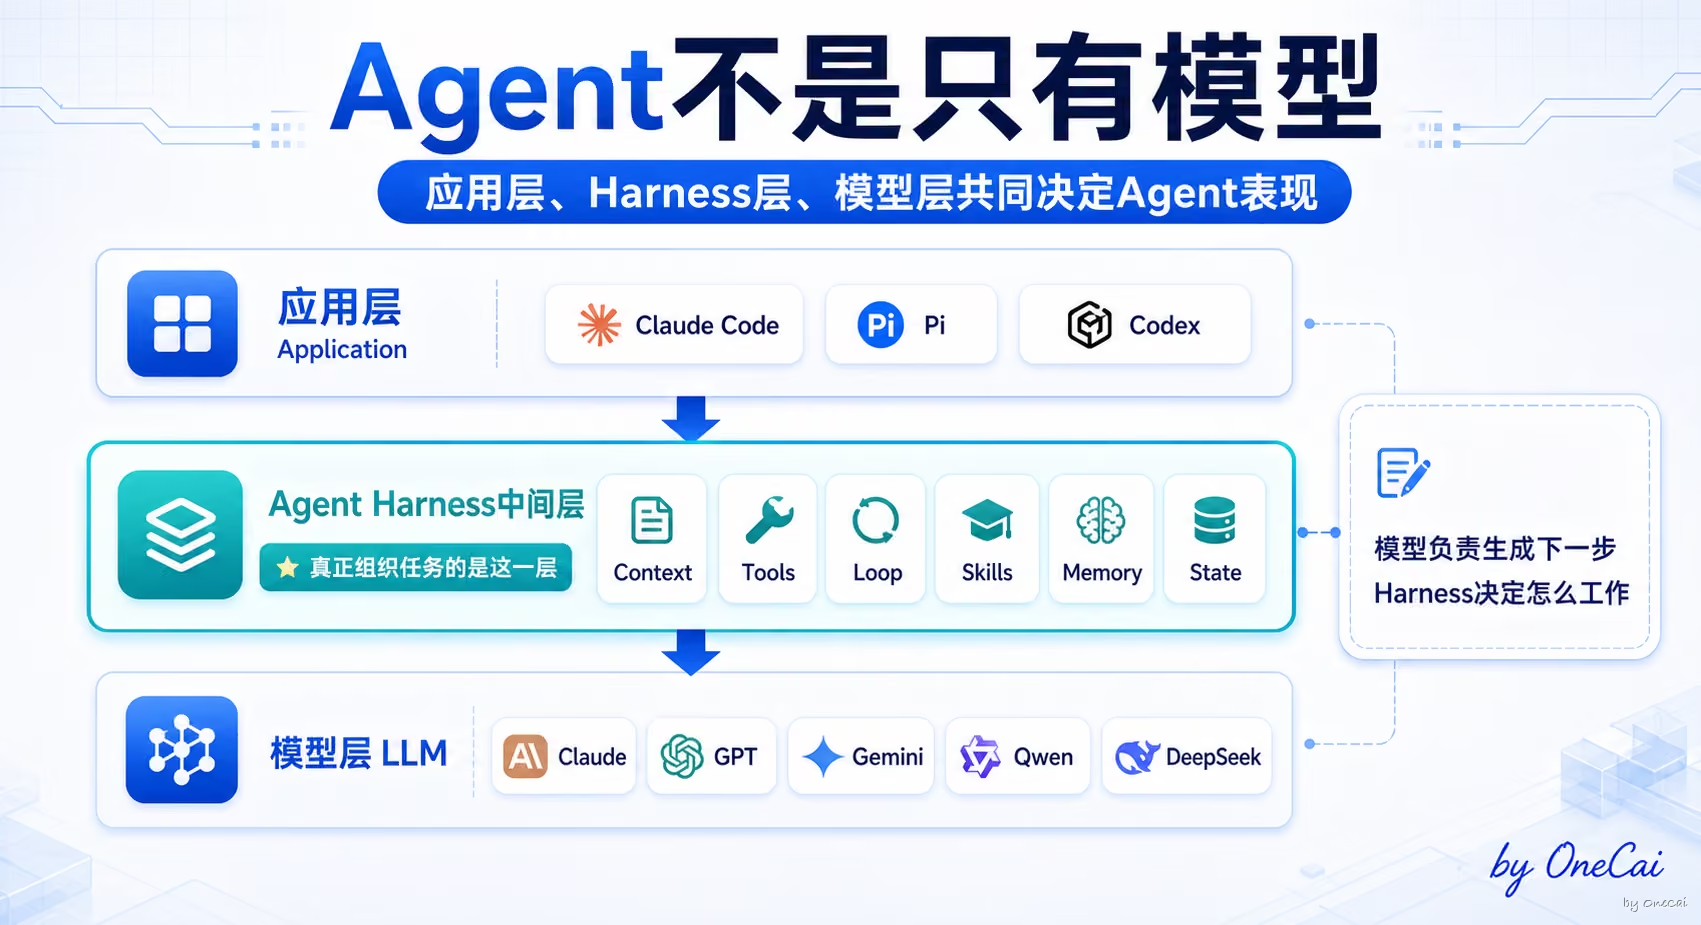
最上面是应用层,就是你我直接用的那个产品入口,比如Claude Code、Pi、Codex。最下面是模型层,Claude、GPT、Gemini、Qwen、DeepSeek,负责生成下一步。中间还有一层,业内叫harness,负责把上下文、工具、循环、Skills、记忆、权限、压缩、模型调用这些东西组织起来。
过去两年,大家讨论AI编程,注意力几乎全堆在最底层。Claude强还是GPT强,谁的代码能力更好。但进了Agent阶段之后,一个越来越明显的事实浮出来了。
模型不是直接干活的。
真正决定模型「怎么干活」的,是中间这一层。模型负责生成下一步,harness决定模型什么时候看见什么、能调用什么、工具结果怎么回到上下文、会话满了怎么压缩、失败了怎么继续。
同一个模型,换一个harness,表现可能完全不同。
到了Agent时代,模型只是发动机,harness才开始决定这辆车怎么开。
理解了harness这个概念,再来看Pi就清晰多了。
Pi的作者叫Mario Zechner,网名badlogic。如果你做过Java游戏开发,可能更早认识他,因为libGDX就是他写的,一个被广泛使用的Java游戏开发框架。2025年8月,他把Pi发布出来,动机很工程师式,就是受够了现有Coding Agent越来越臃肿、越来越黑盒,自己写一个。
Pi自己就是按harness的思路拆的。它不是一个单体产品,而是一组包。pi-ai负责统一多模型接口,pi-agent-core负责工具调用和状态管理,pi-coding-agent是面向用户的交互式CLI,pi-tui负责终端界面渲染。官方仓库现在把整个项目描述为一个AI agent toolkit,而不是单纯的聊天工具。
多数Agent产品的默认路径是,用户要什么就加什么。要联网,加Web工具。要协作,加Subagent。要流程,加Plan Mode。要企业化,加权限系统。要长期任务,加Memory。要接外部系统,加MCP。每一个功能单独看都合理,但堆到最后,Agent越来越像一个小型操作系统。
Pi反过来做。
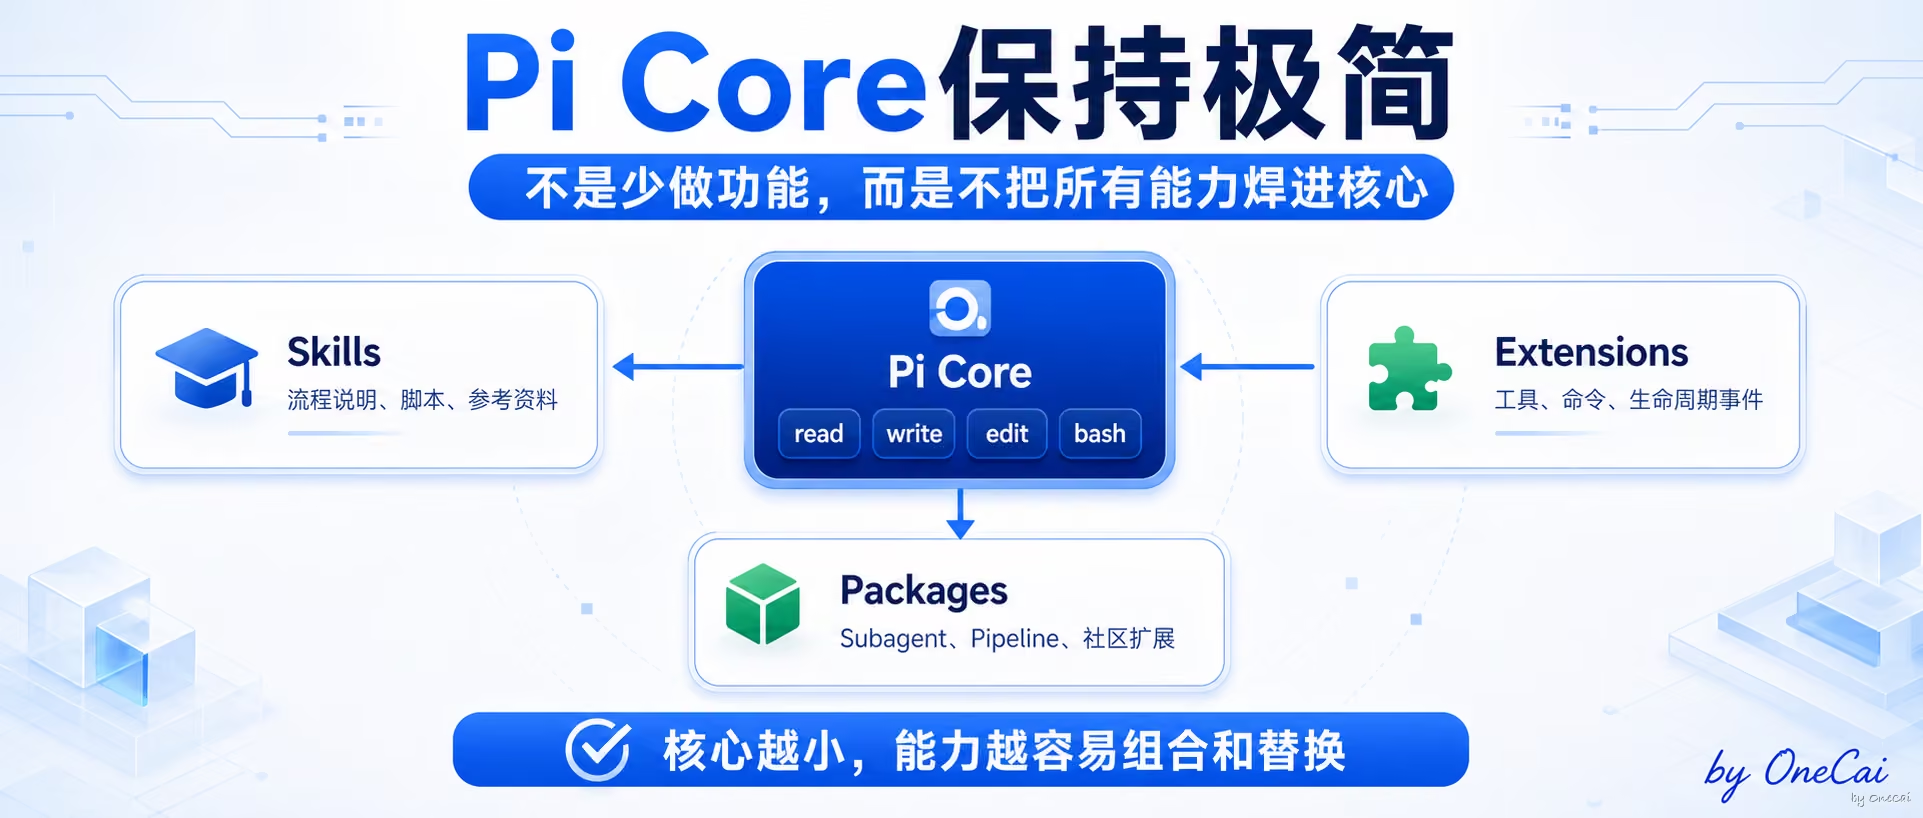
核心压到很小,只保留最基本的本地开发动作。读文件,写文件,编辑文件,跑命令。就4个工具,read、write、edit、bash。其他能力放到外围,用Skills、Extensions、Packages按需加载。Pi官方文档明确说,之所以跳过Sub-Agent、Plan Mode这类功能,是因为用户完全可以通过扩展或Package自己实现,没必要焊死在核心里。
这里有个判断我觉得挺重要的。Pi的「少」,不是做不出来,而是它认为这些能力不应该被全部固化进Agent核心。
你想想看,一旦能力进了核心,它就会变成每次对话都要考虑的东西。文档、工具描述、权限规则、提示词、历史状态,都可能占用上下文,都可能分散模型的注意力。用户感受到的是功能变多了,模型感受到的可能是工作台上堆满了东西。
说到Pi把核心做小,最值得细看的不是它砍了什么,是Skills怎么进入上下文的。
这一块是全文技术含量最高的地方,值得你多花两分钟看。
设想一个功能齐全的Agent,同时挂着30个工具、20个Skills、10个MCP连接、项目级规则、用户级规则、长期Memory、完整对话历史,还有当前正在处理的代码和文档。问题不在于这些功能不好,而在于一个更根本的问题。
模型到底什么时候需要看见这些东西?
如果全部提前一次性塞进Context Window,很容易演变成系统提示词、AGENTS.md、工具schema、MCP schema、Skills说明、Memory、聊天历史、代码全都挤在一起,而真正跟当前任务相关的那一小块内容,占比反而越来越低。
这其实是我之前聊上下文窗口时反复提到的那个老问题,「标称长度」和「有效长度」之间的差距。上下文窗口不是仓库,更像工作台。工作台越大,当然能放更多东西,但把所有扳手、螺丝、旧图纸都堆满桌面,不等于干活更快。
Pi给出的方案在官方文档里有非常具体的描述。Skills被定义为「self-contained capability packages」,独立的能力包,包含工作流程说明、脚本、参考资料,Agent按需加载。启动时,Pi只会把每个Skill的名称和一句简短描述放进系统提示词。只有当前任务真的匹配到某个Skill时,Agent才会用read工具去读取完整的SKILL.md。
官方文档把这个机制直接命名为progressive disclosure,渐进披露。只有描述常驻上下文,完整指令按需加载。
这不是一个小优化。
它背后的问题是,Agent到底应该在什么时候把能力放进上下文。Claude Code也有Skills和Subagents,也在解决类似问题。区别在于Claude Code把很多能力做成了更完整的默认产品体验,而Pi把这件事拆得更裸,让你直接看见harness本身是怎么组织的。
我自己的感受是,Agent的下一场竞争,可能不是谁能接入更多工具,而是谁能更晚、更准地把正确的工具放进Context。
顺着上下文这条线再往深挖,就到了Pi的压缩机制。
长任务跑久了,上下文一定会满,这是所有Agent都绕不开的问题。
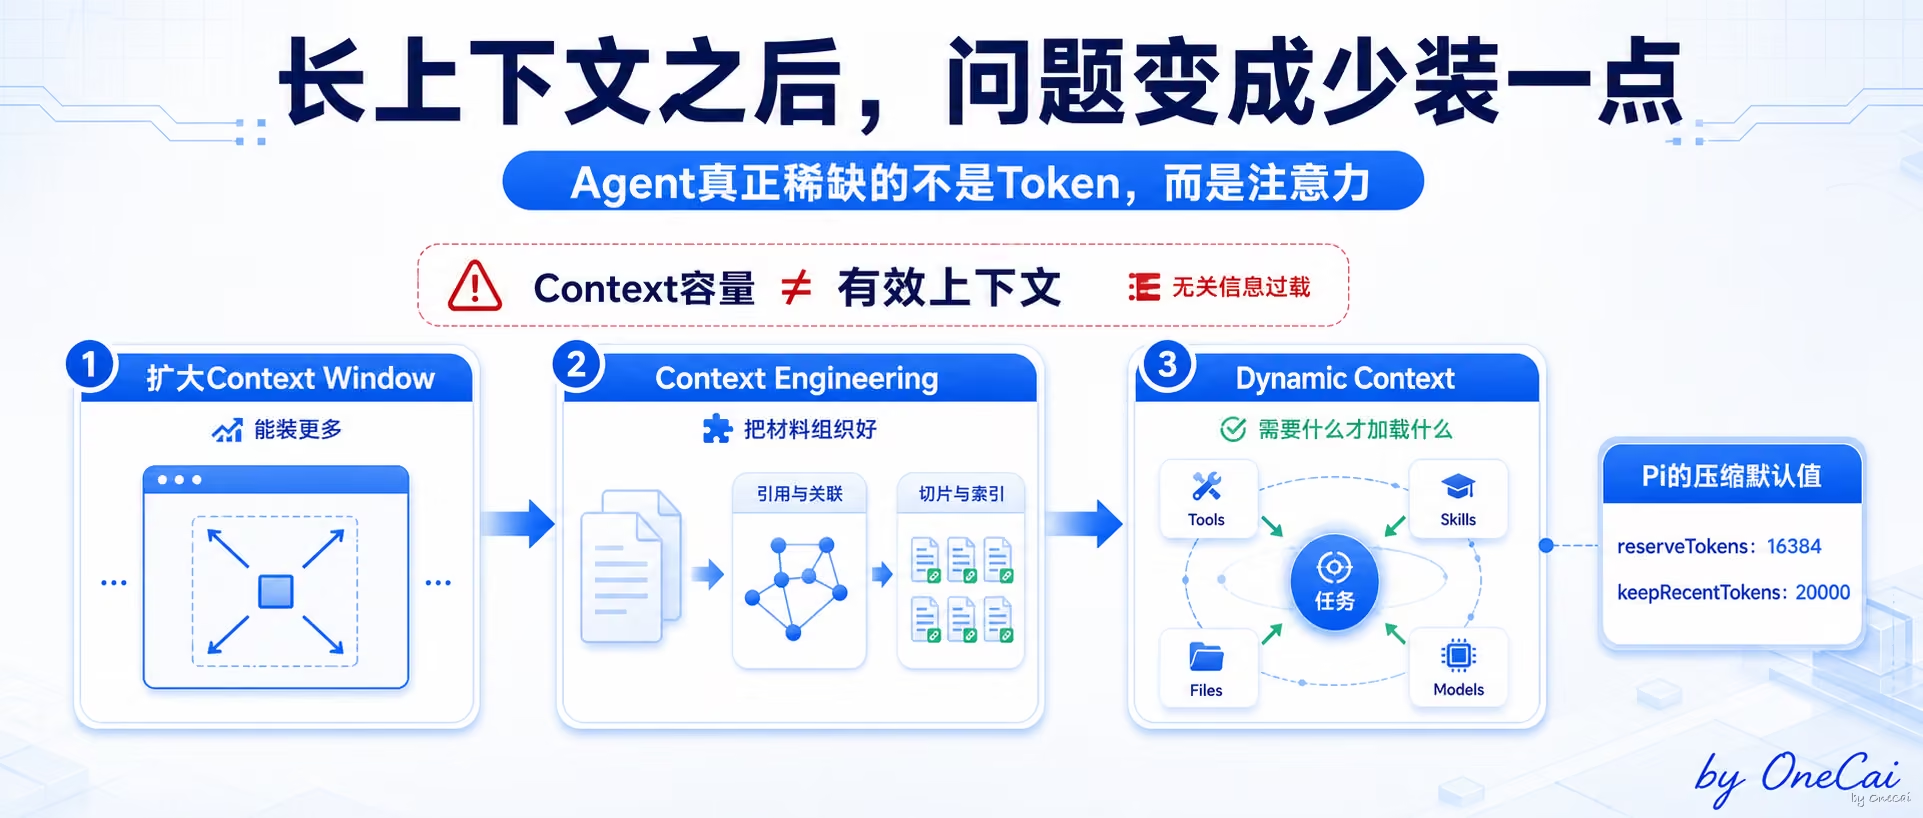
Pi官方文档给出的默认参数是可查证的一手数据。系统在当前Context Token数大于模型上下文窗口减去reserveTokens时触发自动压缩。reserveTokens默认预留16384个token,用来给模型的输出留出空间。keepRecentTokens默认保留20000个token的近期原文历史,作为工作记忆。两个参数都可以在配置文件里手动调整。当对话逼近上限,Pi会把更早的内容摘要压缩,而不是一直往里堆。
这组数字不神秘,但它们把问题讲清楚了。Agent不是简单地把对话越存越长,它必须决定哪些内容保留原文,哪些内容压成摘要,哪些内容该从上下文里彻底消失。
压缩太早,细节会丢。压缩太晚,模型没有足够输出空间。保留近期太少,刚发生的工具结果可能断线索。保留太多,又压不出空间。
一个常见的直觉误区是,既然模型现在能支持百万级Context,那把所有东西都塞进去不就行了吗?Pi自己的压缩机制就是在否定这个直觉。
Context的容量和Context的有效利用率,从来不是一回事。
顺着这条线可以看到一个大致的演进轨迹。第一阶段是拼命扩大Context Window,大家比谁的窗口更长。第二阶段进入Context Engineering,开始有意识地组织进入上下文的内容,怎么切、怎么排、怎么引用、怎么压缩。第三阶段是Dynamic Context,不是把准备好的东西一次性塞进去,而是让Agent根据任务动态加载模型、工具、Skills、文件、历史和验证器。
Pi不是唯一在做这件事的项目,但它把这个方向表达得很直接。
长上下文时代的下一个问题,不是怎么装得更多,而是怎么少装一点。
除了上下文管理,Pi还有另一个特征挺值得说的。
它不把自己绑死在某一个模型上。
pi-ai模块是统一的多Provider接口,官方文档把支持的接入方式分成三类。直连API,Anthropic、OpenAI、Google、xAI、Groq、Cerebras、OpenRouter、Mistral这些。订阅类接入,Claude Pro/Max、ChatGPT Plus/Pro、GitHub Copilot这些。企业级接入,Azure OpenAI、Amazon Bedrock、Google Vertex AI这些。此外也支持通过Ollama或llama.cpp接入本地模型。
这件事表面看是多模型适配,深一层看,是把模型变成了可更换的零件。过去的路径是「Claude Code绑定Claude」。Pi的思路是「任务先交给harness,再由harness决定用哪个模型执行」。简单搜索用便宜模型,代码修改用擅长编程的模型,复杂规划用推理模型,未来甚至可能按任务类型自动路由。
我是真的觉得,如果模型本身还会持续快速迭代,那么真正长期留存的资产,可能不是某一个具体模型,而是你围绕任务搭建起来的harness、Skills和工作流。
这一点还有一个可以直接验证的旁证。Pi的Skills并不锁死在Pi里。官方文档里,你可以在配置文件中把Claude Code或OpenAI Codex的Skills目录直接接进来,比如在settings里加上~/.claude/skills、~/.codex/skills这样的路径,Pi会照常发现并加载这些Skills。反过来,Mario Zechner维护的pi-skills项目也明确说这批Skills兼容Claude Code、Codex CLI、Amp和Droid。
也就是说,你在一个Agent里攒下的能力,理论上可以直接搬到另一个Agent里继续用。用户真正积累的是「能力」本身,而不是被锁定在某一个平台的配置。
聊到这里你可能会想,Pi不是去年8月就发布了吗,为什么现在才火?
说真的,这事不是单一原因能解释的,几层东西叠在一起了。
第一层,大家开始意识到harness本身的重要性。同一个模型,换一个harness跑,表现可能完全不同。模型决定能力上限,harness开始越来越明显地决定这部分能力究竟能发挥出多少。
第二层,Agent功能膨胀开始产生副作用。随着MCP、Skills、Memory、Hooks、Subagents、Agent Teams、Rules这些东西越叠越多,开发者开始面对一个新问题。到底哪些东西应该一直存在于Context里?Pi给出了一个偏极端的答案,尽量不要。
第三层,可能是最被低估的一环,一条可以交叉验证的真实时间线。
2025年8月,Zechner独立发布Pi,仓库挂在他自己名下。
2026年1月31日,Flask和Sentry的作者Armin Ronacher,网名mitsuhiko,在个人博客发表了一篇文章,叫《Pi: The Minimal Agent Within OpenClaw》,公开背书Pi是「OpenClaw内部的极简agent」,也是他「几乎唯一在用」的Coding Agent。
2026年4月8日,Ronacher联合创立的公司Earendil宣布收购Pi,Zechner以核心成员身份加入。Earendil是一家风投背景的公益公司,早期投资方包括Accel、Balderton Capital,以及n8n、OpenClaw、Revolut、Sentry、Slack这几家公司的创始人。
2026年5月7日,官方发文宣布代码仓库正式从Zechner个人名下迁移到earendil-works/pi,npm包作用域也从@mariozechner迁移到@earendil-works。版本号0.74.0是新作用域下的第一个正式发布版本,旧包没有下架,只是标记为废弃。
这条时间线说明,这次「火」不只是产品力本身的自然增长,也叠加了一条「独立项目→行业大佬公开背书→被组织化接手、拿到资本背书」的加速链条。
更值得关注的是生态信号。Pi的官方Package目录里,已经能看到不少第三方维护的能力包。比如pi-sub-agent,是一个专门给Pi补上Subagent能力的扩展,支持单任务、并行、链式三种委派模式。@baryonlabs/pi-agent-harness更进一步,把Pi的极简核心包装成一套「团队架构工厂」,可以用一句话描述生成一整套多智能体协作方案,官方原本是Claude Code的插件,现在被移植成了Pi专用版本。
也就是说,Pi官方没有把Subagent做进核心,但社区在外围把它补了回来。这正好回到Pi的哲学,核心保持小,能力在外面长。
看到这里,可能有人已经开始想,那Pi和Claude Code到底怎么选?
坦率的讲,如果硬要写成一个「Claude Code封闭、Pi开放」的对立,那就太偷懒了。这个说法不准确。
Claude Code本身也有开放生态,Skills、MCP、Hooks、Subagents、Plugins、Agent SDK它都有,也有相对完整的权限体系,不是一个不能扩展的黑盒。对大多数开发者来说,它现在就是更成熟、更省心的选择。
真正的区别在于,两者对同一个问题给出的默认答案不同。
Claude Code的默认体验是开箱即用,内置10个以上工具,覆盖文件、搜索、Shell、Web这些场景,系统提示词在数千token级别。Plan Mode和Subagent都是原生内置的,有分级的Permission Mode,文件修改和Shell执行有不同的确认策略。模型以Claude体系为核心,定价是官方订阅或按量计费。企业采用门槛相对较低,安全能力默认就在那。适合大多数希望立刻把事做完的开发者。
Pi的默认体验是自己组合,核心就4个工具,read、write、edit、bash,系统提示词大约1000token。Plan Mode和Subagent默认不提供,靠扩展或社区Package补。没有内置沙箱,继承启动进程的权限。支持直连、订阅、企业三类接入,多Provider可换。开源免费,只需支付所接入模型的API费用。企业采用门槛相对较高,权限和沙箱需要自行搭建。适合想掌控整个harness的开发者。
Claude Code的逻辑是,由Anthropic先定义好一个优秀Agent应该长什么样,再把扩展空间留给用户。Pi的逻辑是,先给你一个足够小的Core,剩下的由你自己决定它最终变成什么样。
一句话总结,Claude Code是一个Agent,Pi更像是制造Agent的一套积木。
但文章写到这里如果不泼盆冷水,就变成Pi软文了,得把另一面也摆出来。
最重要的反例是权限。
Pi官方安全文档写得很直接。它没有内置沙箱,内置的4个工具会用启动Pi进程本身的账户权限去读文件、写文件、编辑文件、执行Shell命令。扩展也是TypeScript模块,跑的时候用的也是同样的权限。官方给的建议是,如果需要真正的隔离边界,要靠操作系统、虚拟化或容器去补。
这不是纸面上的风险。最近科技社区Linux.do上就出现过一份使用者报告,有开发者在使用Pi时遭遇终端失控输出,模型陷入无休止循环,短时间内耗尽系统资源,尝试Ctrl+C中断无效后,设备出现黑屏、异常蜂鸣,随后多次重启都出现死机,一段时间内无法正常使用。。。
需要说明的是,这是一份用户自述的个案,不是官方确认的普遍性问题。但它足以说明,极简架构在默认状态下,确实存在真实的稳定性和安全边界问题。一个能跑Shell、能改文件、能装包的Agent,如果没有权限边界,出错时影响范围可能不小。
相比之下,Claude Code在这方面明显更产品化。默认有权限提示,有分级的Permission Mode,Plan Mode下可以先只读探索,文件修改和Shell执行也有不同的确认策略。企业里真正要把Agent推给一群开发者用,这些默认边界很值钱。
所以不要把Pi讲成一个更高级的Claude Code替代品。对很多人来说,Claude Code反而是更正确的选择,因为它已经替用户提前解决了安全、权限、交互、规划这一整套问题。Pi把决定权交回给用户的同时,也把责任交回给了用户。
这两者,来自同一个地方。
回到最开始那个问题,我们是不是把Agent做复杂了?
不急着回答「Pi是不是最终形态」这个问题。更准确的说法是,Pi本身未必是最终会留下来的那个产品,但它所代表的架构思路,很可能会留下来。
聊到这里我突然想起了Unix哲学。
Unix有一句核心原则,叫「Do one thing and do it well」,做一件事,把它做好。这个理念影响了整个软件行业几十年,从Unix管道到微服务到Serverless,你都能看到它的影子。一个工具只做一件事,然后通过组合来完成复杂任务。
Agent现在正在经历同样的拐点。
Agent 1.0是Prompt时代,用户提问,模型给答案,核心问题是怎么问得更好。
Agent 2.0是Tools时代,模型开始能调用搜索、文件、Shell、API,核心问题变成怎么让AI真的能行动。
Agent 3.0是Workflow时代,Plan、Tools、Memory、Subagents、MCP拼在一起,核心问题是怎么让复杂任务持续跑完。这基本是今天大多数主流Agent产品所在的阶段。
Agent 4.0可能会是Composable Harness时代。任务驱动一个极小的核心,核心再动态调用模型、Skill、工具,配合Context管理和结果校验完成任务。核心问题变成,当前任务到底需要什么能力?什么时候该加载,什么时候该丢弃?该用哪个模型执行?
这个问题会越来越难回答,因为模型会变,工具会变,MCP会变,Skills会变,任务类型也会变。今天写死在核心里的能力,半年后可能已经不是最佳实践了。一个更小、更可组合的harness,反而更容易跟上变化。
Pi真正值得关注的,可能不是它现在具备哪些功能,而是它在持续追问一个越来越关键的问题。
一个Agent,到底应该内置多少东西?
不需要得出「Pi将取代Claude Code」这种结论,至少今天看,这大概率是错的。
更准确的收束是,Claude Code给出的答案是,把最好的能力尽可能集成起来,做成一个越来越完整的Agent。Pi给出的答案是,把Agent核心尽可能缩小,让能力在真正需要的时候被临时组装出来。
今天看,前一种路线显然更成熟、更容易上手,这也是为什么大多数开发者的默认选择仍然是Claude Code。但如果把时间线拉长,模型还在不断变化,工具还在不断变化,Skills还在不断增加,任务只会越来越复杂,那么一个能长期存在的Agent,最重要的能力可能不是「它自己会多少东西」,而是它能不能在正确的时候,找到正确的能力、正确的模型、正确的上下文,把任务完成。
未来最强的Agent,也许不是那个什么都会的Agent,而是那个知道自己此刻只需要会什么的Agent。
回到那个工作台的比喻。最强的工匠,不是那个把所有工具都摊在桌面上的人,而是那个知道此刻只需要一把锤子的人。
顺便说一下这篇文章的信息来源,分几个层级说一下,做个交代。
一手官方信源。Pi官方仓库Compaction文档,reserveTokens默认16384、keepRecentTokens默认20000,地址是pi.dev/docs/latest/compaction。Pi官方仓库Skills文档,progressive disclosure机制和跨Agent目录加载配置,地址是pi.dev/docs/latest/skills。Pi官方新闻《Pi Has a New Home at Earendil》,pi.dev/news/2026/5/7/pi-has-a-new-home,仓库与npm作用域迁移的一手记录。Armin Ronacher个人博客文章,lucumr.pocoo.org/2026/1/31/pi,1月31日背书文的一手原文。Pi官方Package页面pi-sub-agent与@baryonlabs/pi-agent-harness,用于确认社区生态案例真实存在。
二手技术评测交叉确认。Pi的多Provider分层接入方式和无内置沙箱、继承启动进程权限的安全表述,来自多篇独立技术评测对官方文档的转述,未直接引用官方安全文档原文链接,但内容彼此一致。
用户报告个案,非官方确认。Linux.do社区关于Pi终端失控、系统崩溃的故障报告,属于个别用户自述,不代表普遍性问题,也未见Pi官方或Earendil官方回应。
趋势性描述。GitHub star增长轨迹本文只写「从几百量级到数万量级,不到一年」,不锁定某一天的精确数字,因为不同公开索引的抓取口径本身存在差异。
时效性提醒。Pi生态目前迭代速度很快,npm包命名空间已从@mariozechner迁移至@earendil-works,安装命令、当前star数、Package生态数量等信息时效性较强。安装前请以官方文档pi.dev为准确认最新包名。
| |
以上,既然看到这里了,如果觉得不错,随手点个赞、在看、转发三连吧,如果想第一时间收到推送,也可以给我个星标⭐~ 谢谢你看我的文章,我们,下次再见。