文中数据核对时间:2026年8月26日。能耗披露是一个快速变化的领域,Google、OpenAI、IEA等若发布新版报告,具体数字需以官网当日信息为准。配图待补。
两个真相都对,但说的不是一回事
网上流传最广的说法大概是这样的:问ChatGPT一句话,等于喝掉一瓶矿泉水,或者点亮一盏灯泡十分钟。这类说法每隔一阵就会刷屏一次,通常配着“AI正在偷走地球的电”这样的标题。这两个方向的说法都不算错,但它们说的根本不是同一件事。
一次对话确实便宜到可以忽略——Google在2025年公布的官方实测数据显示,Gemini App一次中位数的文本对话耗电0.24瓦时,大概相当于看电视不到9秒。但与此同时,全球AI数据中心的用电需求正在快速增长——国际能源署(IEA)2026年更新报告显示,2025年全球AI专用数据中心用电量暴涨了50%。
单次便宜,不等于总量便宜。这篇文章要做的,就是把“一次对话”和“全网AI”这两个尺度分开算清楚,再把它们重新拼回一张完整的账本。
一、为什么“一杯水”的说法,既对也不对
“10倍于Google搜索”这句话是怎么来的
要拆穿一个流传的数字,先得找到它的源头。“一次AI问答的成本是一次Google搜索的10倍”,这个说法能追溯到2023年——Alphabet董事长John Hennessy在接受路透社采访时说,与大语言模型的一次交流,运行成本很可能是标准关键词搜索的10倍左右。
要注意,他原话谈的是“成本”(cost),并没有specifically指向“耗电量”。这句话在后续传播中被简化、也被偷换了概念——从“运行成本可能高10倍”,逐渐被转述成“耗电是10倍”,两者并不是一回事:成本里包含硬件折旧、机房建设、人力等大量非电力支出,能耗只是其中一项。这句非正式的口头估算,就这样在传播中“镀了金”:源头模糊、口径被换,却越传越确定。
“一瓶水”说法的真实来源
另一个更具体的类比——“一次提问耗掉一瓶水”——确实有学术论文作为源头,但传播过程中丢掉了一个关键前提。
美国加州大学河滨分校(UC Riverside)团队在2023年发表的论文《Making AI Less “Thirsty”》里指出:GPT-3每生成10到50次中等长度的回复,会消耗约500毫升水(包含数据中心直接冷却用水,以及发电环节消耗的水)。这篇研究本身方法严谨,问题出在被媒体简化传播之后,“10到50次里摊一瓶”这个分母被悄悄丢掉了,变成了“一次提问=一瓶水”。
后来《华盛顿邮报》联合UC Riverside做的一次更具体的实验,倒是给出了一个更接近“一瓶水”量级的数字:用GPT-4写一封100字的邮件,耗水约519毫升,耗电约0.14千瓦时。但要注意,这是“写一封邮件”——通常涉及多轮交互和更长的输出,而不是随口问一句话。
完整数据表:官方、学术、媒体三档并列
把目前能查到的、相对权威的单次对话能耗数字放在一张表里,并标注置信等级:
| 数据源 | 数值(瓦时/次) | 性质 | 置信等级 |
|---|---|---|---|
| Google《Gemini技术报告》(2025年8月) | 0.24 | Gemini App中位数文本对话的生产环境实测,方法论完整公开——注意这不代表所有AI对话,也不是Gemini处理长文档、图片、视频等重任务时的数字 | ★★★★★ 一手,官方 |
| OpenAI CEO Sam Altman博客(2025年6月) | 0.34 | 一手披露,但仅是博文里的一句话,未公开具体测算方法和统计口径 | ★★★ 一手不透明 |
| Epoch AI 独立测算(2025年) | 约0.3(短查询);输入拉长到1万token约2.5瓦时;输入拉长到10万token约40瓦时 | 第三方研究机构,方法公开,同时明确指出长度是决定能耗的最大变量 | ★★★★ 二手,方法透明 |
| Jegham等人学术论文(2025年) | 因模型差异极大:GPT-4.1 nano约0.45瓦时,o3约3.9瓦时,GPT-4.5长文本任务约30瓦时 | 学术测算,覆盖不同模型和任务长度 | ★★★★ 学术 |
| Alex de Vries(2023年)/ EPRI与BestBrokers(2024年) | 约2.9~3 | 早期估算,基于旧硬件和偏长的输入假设,已被Epoch AI等后续研究指出显著偏高 | ★★ 需谨慎引用,仅作历史参照 |
(University of Rhode Island团队针对GPT-5给出的约18.9瓦时一说,目前主要见于媒体转述,未能查到实验室原始报告和完整测算方法,暂不列入本表,仅在后文提及时明确标注为“媒体转述、方法未公开”。)
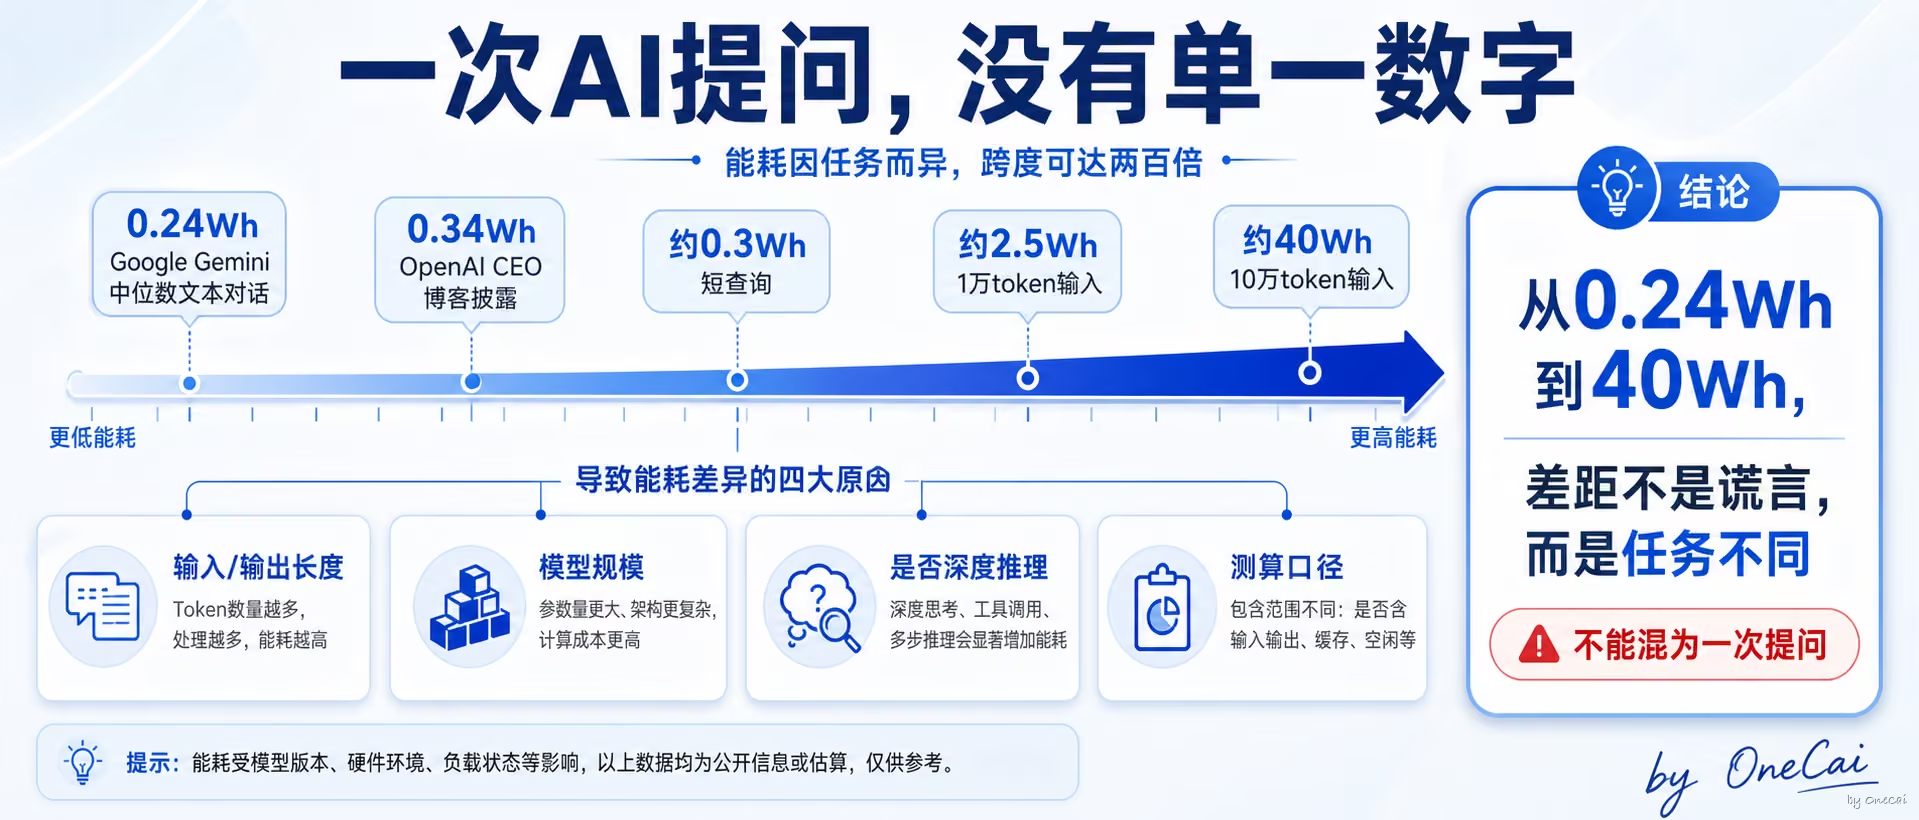
表里最扎眼的是跨度:从0.24瓦时到40瓦时,差了160多倍。这不是谁在说谎,而是至少四个变量在同时起作用:
输入/输出长度。这是目前证据最扎实、跨度最大的变量——Epoch AI的测算里,同一个模型,输入从几百token拉长到10万token,能耗能从零点几瓦时涨到近40瓦时。这也是为什么不存在一个能代表“一次AI提问”的单一数字:一句话问答和一次长文档分析,从物理上就不是同一个量级的任务。
模型规模不同。GPT-4.1 nano这类轻量模型,和GPT-4.5、GPT-5这类旗舰模型,参数规模和计算量本身就不在一个量级,这一点在账号之前拆解token定价时已经反复出现过——同样是生成token,35B模型和70B模型的计算成本可以差出数倍。
是否为推理模型。会“深度思考”的推理模型(如o3、DeepSeek-R1这类),在给出最终答案前会生成大量隐藏的思考过程token,这部分计算同样耗电,却不会显示在你看到的回答里。
测算方法不同。Google的0.24瓦时是生产环境的实测中位数,覆盖了完整的服务链路(GPU/TPU本身、CPU与内存、数据中心运行冗余);而de Vries和EPRI等早期估算,更多是基于硬件理论功耗和公开信息做的建模测算,且假设的输入输出长度偏长,不是从生产系统里直接量出来的数字。这就像账号之前拆过的“1P算力”一样——脱离精度和场景谈算力没有意义,脱离任务长度和模型规模谈能耗,同样没有意义。
一条值得单独一提的暗线:谁在披露,谁在沉默
把目光从数字本身移开,看看“谁愿意公布这些数字”,会发现一个有意思的梯度:
Google是目前唯一一家发布了完整方法论、基于生产环境实测数据的公司;OpenAI给出过一个数字,但只是CEO博文里的一句话,没有公开具体的测算方法;而包括Anthropic在内的多数AI公司,至今没有公布过任何单次查询层面的能耗数据。
这个“透明度梯度”本身可能不是巧合——愿意把数字摊开给你看的公司,往往也是单次成本控制得比较好的公司。这句话不做过度推断,只作为一个值得留意的观察放在这里:当一家公司对某个数字保持沉默,那通常也是一个信号。
二、训练能耗vs推理能耗,差多少
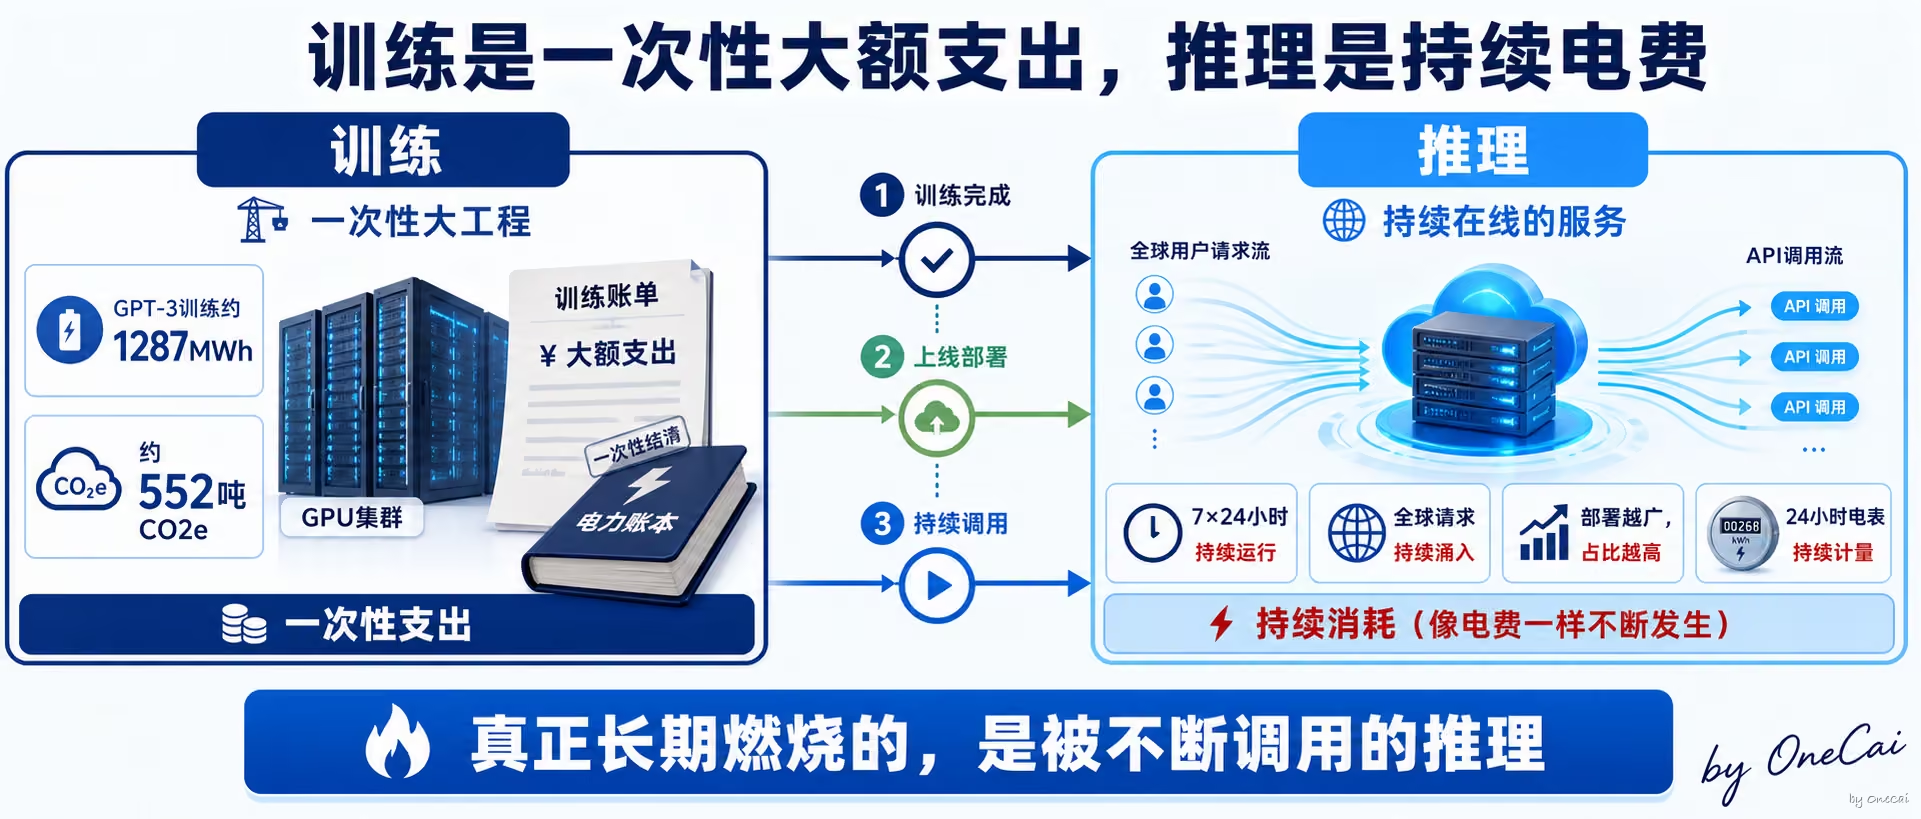
训练:一次性的大额支出
训练一个大模型,能耗账相对清楚的案例是GPT-3。斯坦福和UC伯克利团队在2021年发表的论文《Carbon Emissions and Large Neural Network Training》给出了一个数字:训练GPT-3消耗约1287兆瓦时电力,产生约552吨二氧化碳当量排放。这是公开资料里最常被引用、口径相对清楚的训练能耗案例之一,后续大量研究都在交叉引用这组数字,但它并不是唯一被披露过训练能耗的模型——只是相对其他模型而言,数据来源和测算过程更透明。
用水方面,UC Riverside团队后续测算:GPT-3训练直接冷却耗水约70万升,如果算上发电环节间接消耗的水,总量约540万升。
那GPT-4、GPT-5这类更新的模型,训练能耗是多少?目前没有任何官方数字。媒体上流传的“训练GPT-4消耗超过5万兆瓦时”一类说法,来自第三方媒体基于模型规模做的推算,不是OpenAI官方披露的数据,本文不把它当作确定性事实使用。
推理才是持续燃烧的部分
如果说训练是一次性的大额支出,推理就是设备开机之后,每天都在产生的电费。学术论文《How Hungry is AI?》(arXiv 2505.09598)指出,随着模型被越来越多用户持续调用,在广泛部署之后,推理阶段有可能成为模型全生命周期能耗的大头,该研究给出的估算区间上限在90%左右——这不是一个适用于所有模型的普遍定律,而是取决于具体的部署规模和调用频率,请求量越大,推理在总能耗里的占比通常越高。
原因不难理解:训练只做一次,而推理是7×24小时、面对全球数十亿次请求持续发生的。这和账号之前拆过的“GPU一小时能生成多少token”是同一个逻辑——训练是买设备的一次性投入,推理是设备通电运转的电费,跑得越久、请求量越大,电费在总成本里的占比就越可能反超设备本身的价格。
推理内部也分档:一句话问答vs深度推理
推理耗能本身也不是一个平的数字。非推理模型和会“深度思考”的推理模型之间,耗能可以相差10到70倍——这个跨度和账号在token定价那篇里讨论过的“贵模型该用在哪20%任务上”是同一套判断框架:不是所有任务都需要模型去“想”,很多简单问答用非推理模型就够,硬要用推理模型,费的不只是钱,也是电。
三、数据中心电费,怎么摊到你的每次提问
宏观盘子有多大
单次对话便宜,不代表整体便宜。国际能源署(IEA)2026年4月发布的最新更新报告《Key Questions on Energy and AI》给出的口径是:
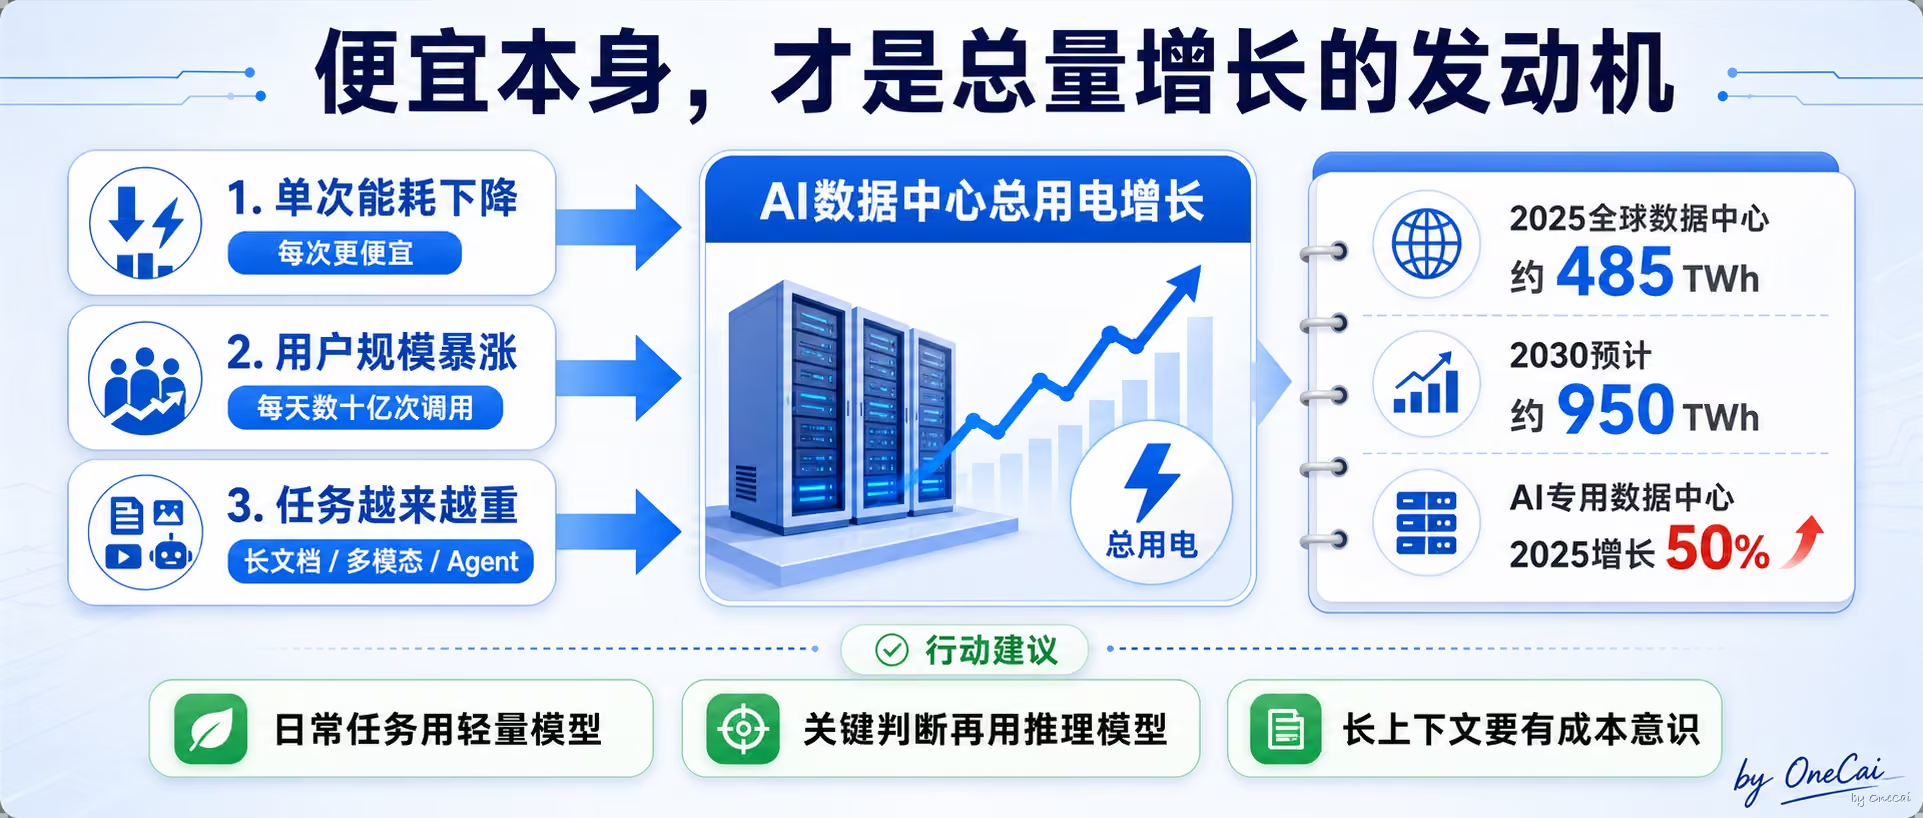
全球数据中心用电量,2025年约485太瓦时(约占全球总用电量1.5%左右),预计到2030年将翻倍至约950太瓦时,占比升至约3%。其中AI专用数据中心在2025年一年用电量暴涨了50%,远超数据中心整体17%的增速,也远远甩开了全球用电总量约3%的增速;到2030年,IEA预计AI专用数据中心的用电量将在此基础上再增长两倍(tripling)。
(提醒一句:IEA在2025年4月发布的初版报告里,用的是2024年约415太瓦时、2030年约945太瓦时这套口径;2026年4月的更新报告把基准年数字上修为2025年约485太瓦时。本文统一采用2026年更新口径,避免新旧数字混用。)
局部数字比全球总量更有实感
全球总量的数字很大,但不够直观。落到具体地区,冲击感会强很多:
爱尔兰中央统计局(CSO)2026年7月发布的最新数据显示,2025年该国数据中心用电量占全国总用电量的23%,比2024年的22%又高了一个百分点,而2015年这个数字还只有5%——十年涨了约4倍多,目前数据中心用电已经接近全国所有家庭用电量的总和。局部地区的数字则更极端:据Oeko-Institute经Carbon Brief转述的分析,美国弗吉尼亚州数据中心用电占比已达26%,爱尔兰首都都柏林更是高达79%——相当于这座城市每用掉5度电,就有4度是数据中心烧掉的。
把宏观数字翻译回你的每一次提问
这一步是“算力账本”最该发挥作用的地方——不是甩出一个950太瓦时吓唬人,而是把它拆解回个体尺度。按Google披露的单次对话0.24瓦时来粗算:如果全球每天发生数十亿次AI对话,单纯这部分对话消耗的电量,量级上大致相当于一座中等规模城市一天的居民用电——这个数字会随着实际用户量和请求量变化,具体测算时需要用发稿当天可查证的最新用户规模数据现算,不能套用旧数字。
这里要指出一个容易被忽略的判断:单次提问的电费便宜到可以忽略不计,但“便宜”本身恰恰是问题的一部分。边际成本足够低,意味着使用量没有天然的刹车——你不会因为担心电费而少问一句AI,正如你不会因为担心电费而少开一次灯。真正驱动数据中心电力紧张的,不是“每次提问都很费电”这个错误归因,而是“每次提问都便宜到没人会节制,加上任务本身越用越重”这个更隐蔽的机制——IEA自己在报告里也把这个现象拆成三股同时发生的力:单次能耗在下降、用户规模在暴涨、任务本身(长文档、多模态、Agent)越来越重,三者叠加,才是总量失控的真正原因。
四、我们自己能做什么
与其在“要不要为了省电少用AI”这个问题上纠结,不如把账本用对地方。
选对档位比省着用更有效。前面提到过,非推理模型和推理模型之间的耗能差距可以到10到70倍,这比“少问几句”管用得多。日常的选题、摘要、简单问答,用便宜档模型就够;只有需要深度推理、复杂代码、关键判断的任务,才值得切换到会“思考”的模型——这和账号在token定价那篇里给出的“80%日常任务用便宜模型,5%关键判断用最贵模型”的分工建议是同一套逻辑,能耗账和价格账在底层往往是一回事。
长上下文和多模态任务是能耗大头。前面第一章的表格已经证明了这一点:同一个模型,输入从几百token拉长到10万token,能耗能差160多倍。这一点在账号之前拆解上下文窗口那篇里也出现过:窗口越长,KV Cache占用的显存越大,本质上是同一笔账的两种记法——一个记在显存上,一个记在电费上。
本地小模型是一个可参照的对比系统。账号在token定价那篇里,此前按本地电价做过一个个人尺度的粗略估算:用Mac Studio跑本地模型,生成一百万token的电费大约在1块钱左右。这个数字只是一个粗算参照,不能直接套用到云端大模型的实际成本上,但它提供了一个直观的对比系统——个人尺度上的AI能耗,原本就不是一个需要焦虑的量级,真正的问题始终在基础设施这一层,不在你我的每一次提问上。
资料边界说明
按可信度从高到低列出本文引用的主要资料来源,供核查与更新:
官方一手数据
- Google《Measuring the environmental impact of AI inference》技术报告,2025年8月:https://cloud.google.com/blog/products/infrastructure/measuring-the-environmental-impact-of-ai-inference
- IEA《Key Questions on Energy and AI》,2026年4月更新:https://www.iea.org/reports/key-questions-on-energy-and-ai/executive-summary
- IEA《Energy and AI》初版报告,2025年4月(仅作历史口径对照):https://www.iea.org/reports/energy-and-ai/energy-demand-from-ai
- 爱尔兰中央统计局(CSO)《Data Centres Metered Electricity Consumption 2025》,2026年7月:https://www.cso.ie/en/releasesandpublications/ep/p-dcmec/datacentresmeteredelectricityconsumption2025/keyfindings/
- Patterson et al., 《Carbon Emissions and Large Neural Network Training》,2021(GPT-3训练能耗数据):https://arxiv.org/pdf/2104.10350
一手但方法论不透明
- Sam Altman博客《The Gentle Singularity》,2025年6月(单次查询0.34瓦时,无方法论披露):https://blog.samaltman.com/the-gentle-singularity
第三方研究与学术论文
- Epoch AI《How much energy does ChatGPT use?》,2025年:https://epoch.ai/gradient-updates/how-much-energy-does-chatgpt-use
- Li et al., 《Making AI Less “Thirsty”》,UC Riverside,2023:https://arxiv.org/pdf/2304.03271
- 《How Hungry is AI? Benchmarking Energy, Water, and Carbon Footprint of LLM Inference》,arXiv 2505.09598:https://arxiv.org/abs/2505.09598
- Jegham et al.,跨模型能耗测算论文,2025
- 弗吉尼亚州/都柏林局部数据,经Carbon Brief转述自Oeko-Institute分析:https://www.carbonbrief.org/ai-five-charts-that-put-data-centre-energy-use-and-emissions-into-context
本文属于「也算技术」系列,与算力经济系列多篇互为参照:算力有效产出见《不同算力卡一小时能干多少活》,模型定价分工见《用AI工具,为什么有人花2块,有人花1300块?》,长上下文与显存账见《上下文窗口:标称1M的token,为什么32K就开始变笨》。