资料核验时间:2026年8月28日。文中涉及的定价、跑分、检查点体积等具体数字,发布前请再核对一遍官方页面,这类数字变化很快。
125B参数,只激活6B,另外还带一个51B的N-gram Embedding。
第一次看到这几个数字摆在一起,很容易怀疑它又是在玩参数量口径:总参数写得很大,实际计算量又很小,最后靠一个漂亮数字讲故事。
但这次查完Qwen官方模型卡、技术报告,以及SGLang、vLLM这些实现侧资料后,结论更接近另一种情况:这不是简单的参数量注水,而是一套把参数拆成不同账本来用的架构组合。 不拆开看,数字确实对不上;拆开看,它的设计意图反而很清楚。
这篇就把这几本账拆开。
三本账:仓库、算力、查表记忆
先把几个数字钉住,后面所有讨论都围绕这张表展开:
| 口径 | 数字 | 怎么理解 |
|---|---|---|
| 主模型参数 | 125B | 模型的主体容量,主要来自一个超稀疏MoE专家池 |
| 激活参数 | 6B/token | 每生成一个token实际参与计算的参数量,更接近推理算力口径 |
| N-gram Embedding | 51B | 低计算量的短语查表记忆,不是MoE专家,也不是外接知识库 |
| 落盘总量 | 约180B | 125B主体、51B N-gram Embedding和约4B MTP模块合在一起的权重规模 |
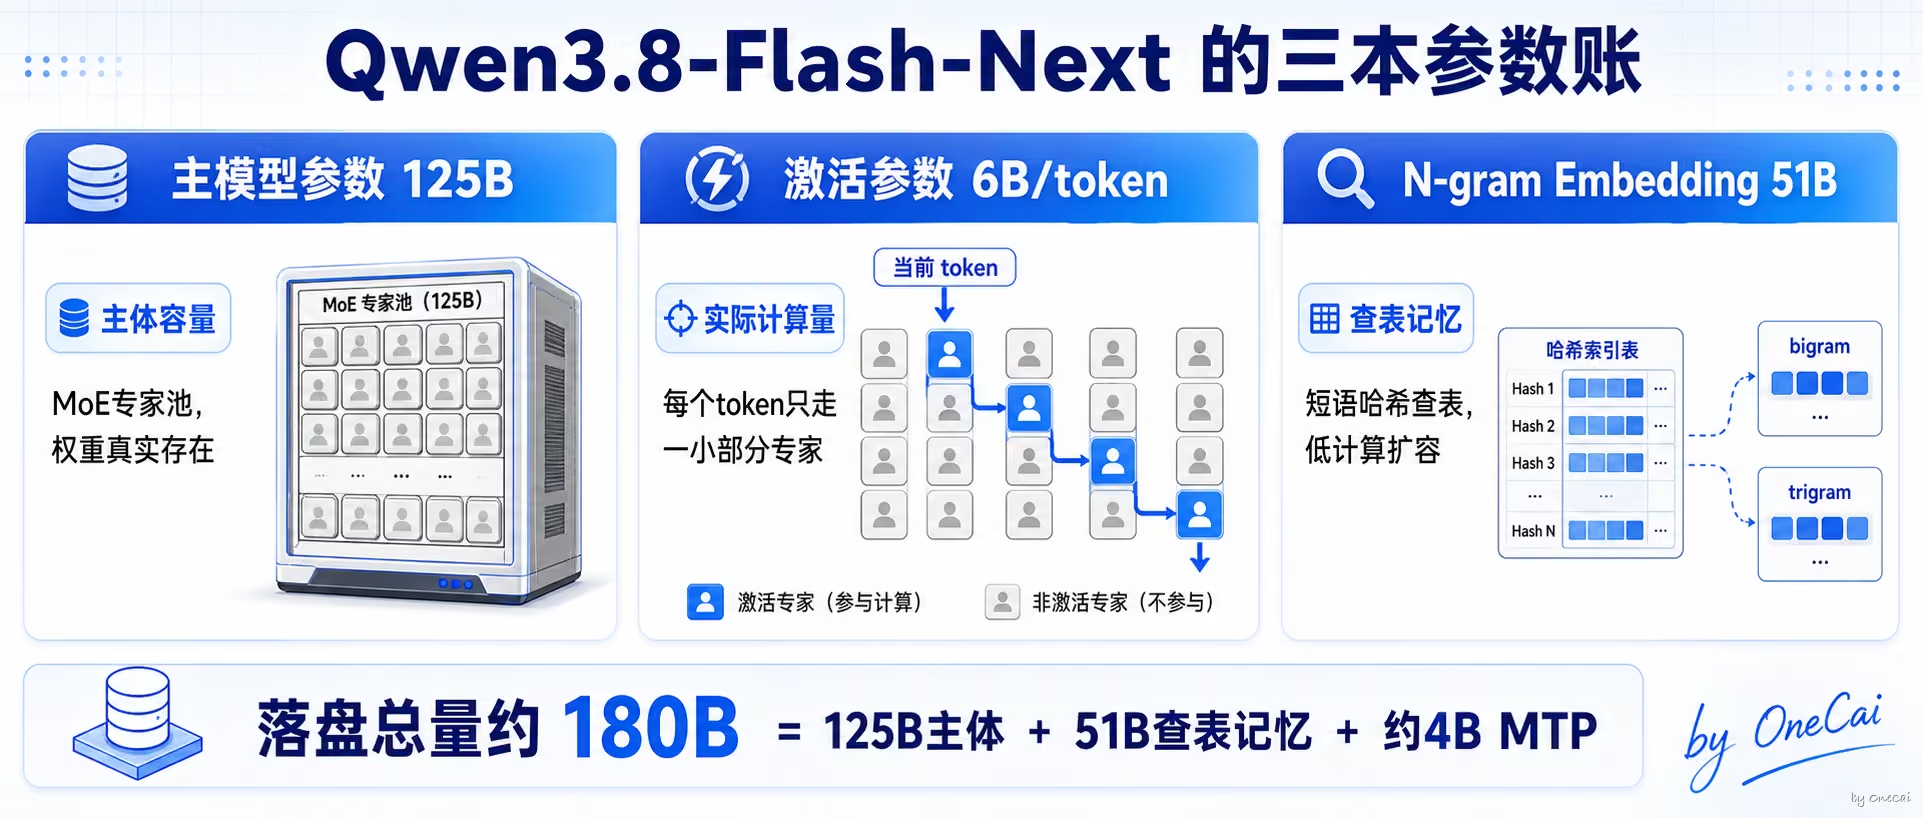
官方把这个模型叫Qwen3.8-Flash-Next,是Alibaba在2026年8月26日发布的开放权重多模态MoE模型,定位是Qwen4架构的早期预览版。Hugging Face模型卡显示,它原生上下文是262,144 tokens,通过YaRN可以扩展到1M。
官方技术报告里,这套架构主要动了四块:GDN+QSA混合注意力、Gated Residual、N-gram Embedding、Muon优化器。本文重点讲GDN+QSA和N-gram Embedding,因为它们直接回答参数量为什么对不上;门控残差和Muon只放在训练稳定性部分简单带过,避免把文章写成技术报告翻译。
125B和6B:MoE解决的是不用全员上场
MoE这部分账号之前已经讲过,这里只看Qwen3.8-Flash-Next自己的数字。
模型卡写得很直接:它的MoE部分有512个专家,每个token激活10个路由专家加1个共享专家。也就是说,125B更像模型可调用的专家池容量,6B才是每一步推理真正要走过的计算量。
一句话记住这个关系:MoE不是让模型本身变小,而是让每个token只用大模型的一小部分。
这和参数量掺水不是一回事。125B主体参数是真实存在、真实训练出来的权重,只是每个token不会把512个专家全部跑一遍。对API调用成本和推理延迟来说,激活参数比总参数更接近算力口径;对本地部署来说,总权重仍然要被存储和调度,不能因为只激活6B就按6B模型准备机器。
51B N-gram Embedding:短语查表记忆,不是专家路由
这一块最容易被误解。
先说它不是什么:它不是MoE专家,不参与运行时专家路由;也不是RAG或外接知识库,因为它是模型内部固定权重,不会临时检索外部文档。
它更像一张基于局部短语的查表记忆。普通token embedding通常是看到一个token,查一个向量。N-gram Embedding看的是当前token和前面一两个token组成的局部片段,再去查对应的向量。
Qwen模型卡给出的公开参数是:N-gram Embedding有20,000,000个bigram/trigram槽位,放在第2层附近。SGLang的实现侧文章进一步解释了落地方式:对当前token,8个二元哈希头查前一个token加当前token,8个三元哈希头查前两个token加当前token,一共取出16行;每行160维,拼起来正好是2560维,和模型隐藏维度对齐。
所以51B不是凭空冒出来的:按实现侧解释,可以理解成2000万哈希槽、16个查表头、每行160维,合起来约51.2B参数。这里更准确的来源分级是:Qwen模型卡确认了参数规模和层位置,SGLang作为实现侧资料解释了这些参数怎样被查表、拼接和offload。SGLang不是第三方独立审计,但它提供了能和模型配置对上的工程细节。
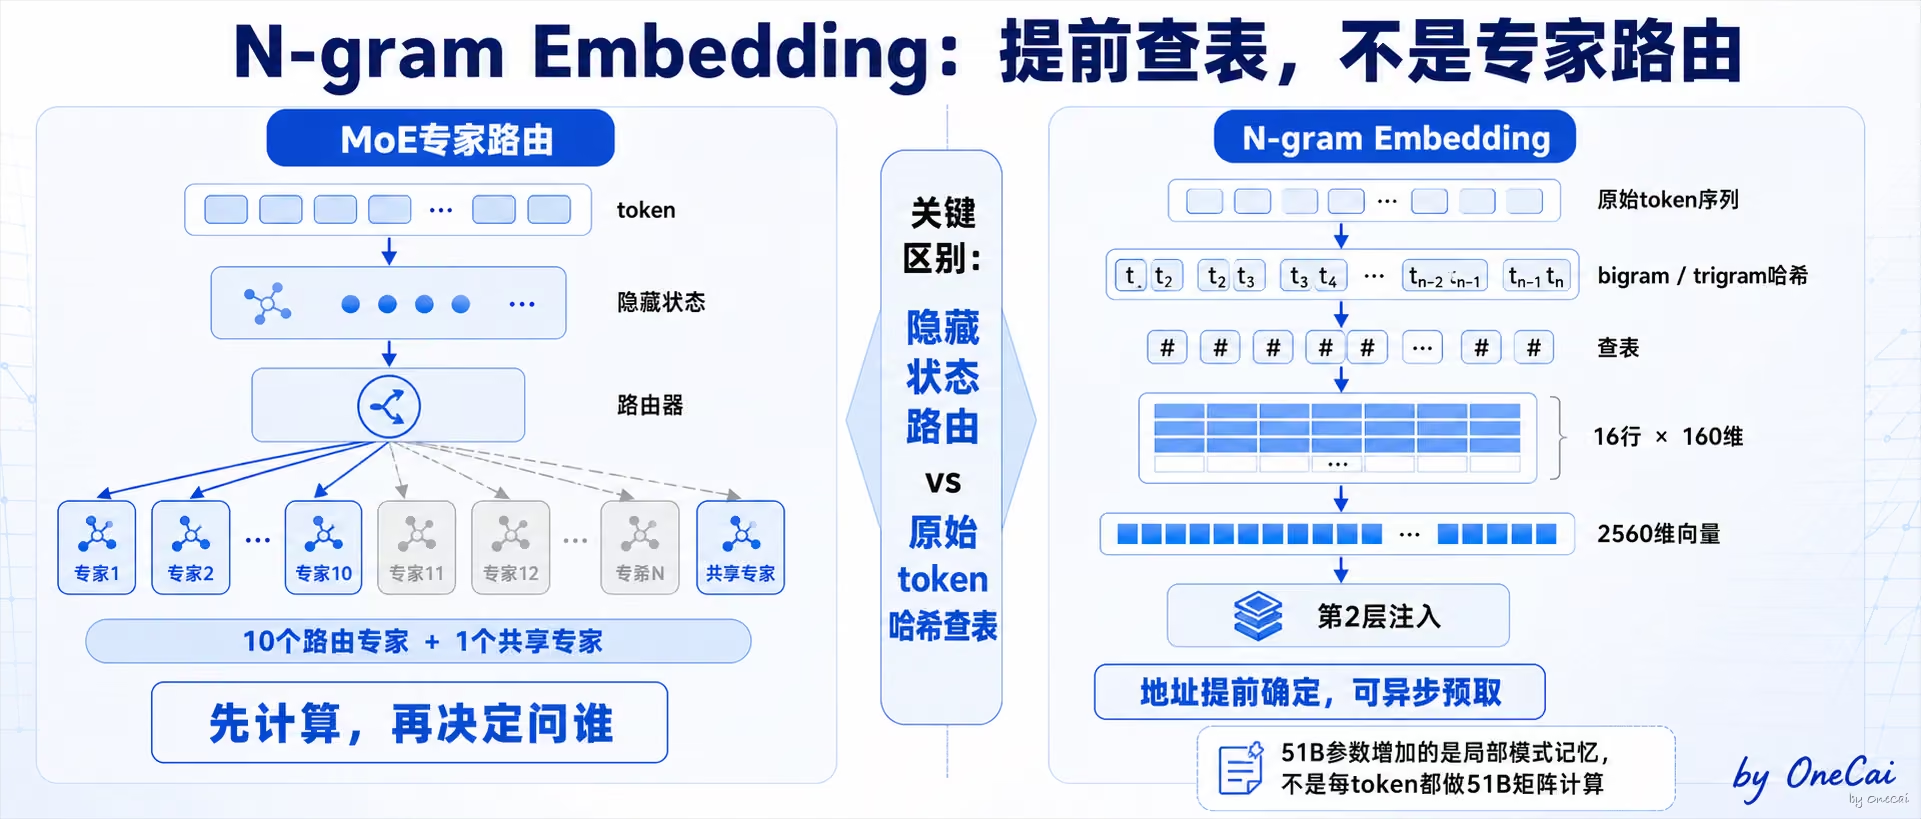
N-gram Embedding和MoE最大的差别,在于查表地址怎么来。
MoE专家路由依赖模型算到某一层时的隐藏状态,模型要先做完前面的计算,才知道这个token该交给哪些专家。N-gram Embedding的查表地址来自原始token序列的哈希,当前token和前几个token确定了,地址也就提前确定了。
这个差异带来的工程后果很重要。因为地址提前可知,这51B参数可以放在主机内存里,由服务框架异步预取到GPU,GPU计算前面层的时候,查表数据可以提前搬运。按Qwen技术报告和SGLang实现侧解释,它增加的是容量,几乎不增加per-token矩阵乘法预算。
不过这里有个边界必须讲清楚:技术报告也说,扩大N-gram表能让训练loss下降,但下游benchmark不一定线性上涨。把51B Embedding写成直接带来智力跃迁,会过度解读。更稳的说法是,它用较低的计算代价,给模型增加了一块局部模式记忆。
GDN+QSA:长文本不是全程硬扫
另一个关键问题是长上下文。262K乃至1M上下文,如果每层都用传统全量注意力硬扫,算力和KV cache都会很重。
Qwen3.8-Flash-Next的排布是48层,其中36层用Gated DeltaNet,12层用Qwen Sparse Attention。模型卡写成一个更紧凑的结构:每4层里3层是GDN,1层是QSA,循环12次。
面向读者可以先这样理解:GDN负责记住大意,QSA负责回头翻重点。
GDN把历史上下文压进一个固定大小的循环状态里。上下文变长时,这部分不需要像全量注意力那样为每一层保存不断增长的KV cache。它牺牲的是逐token全量回看的能力,换来的是长期运行时更稳定的成本。
QSA则保留了精确回看的能力,但不再对所有token一视同仁。它先用轻量索引器把上下文压成micro-block,按block估算重要性,选出最相关的512个block,也就是2048个token左右,再对这些位置做稀疏注意力。
这里有个细节值得写出来:压缩后的key主要用于索引筛选,最后做softmax和取value时,用的仍是原始、未压缩的K/V。也就是说,QSA不是简单把大段上下文压扁后拿压缩结果回答,而是先粗筛,再精读。
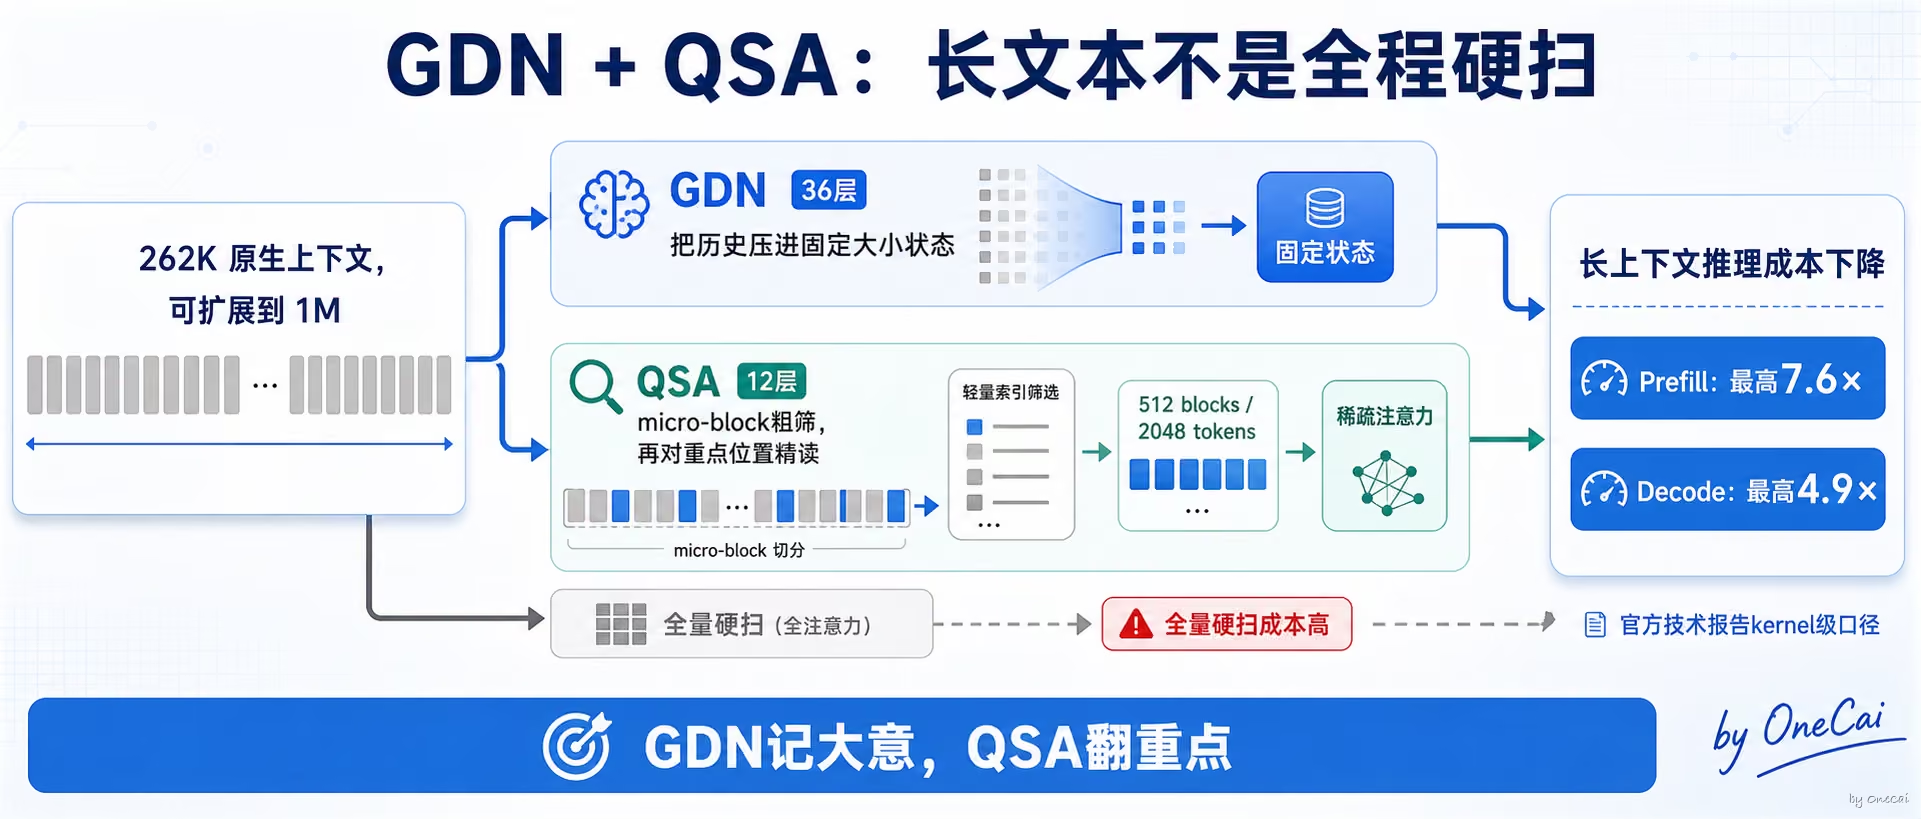
技术报告给出的QSA kernel级速度数字是:在1M上下文下,相比dense attention,prefill最高7.6倍,decode最高4.9倍。vLLM Recipes等实现侧资料里还出现过10.2倍和6.6倍这组更高数字。两组数字的测试口径、硬件和基线不完全一样,不适合混在一起做单点结论。文章里可以写成一个区间判断:官方和生态实现方都声称QSA在超长上下文下有显著加速,但这些仍是厂商和合作方自报数字,发布时不要写成第三方复现结果。
训练FLOPs约1/9:这是官方口径,但不是魔法
训练成本约为Qwen3.7-Plus的1/9,是这次传播最广的一句话。
这不是网络二手推导。Qwen技术报告摘要和表11后面的说明都给出了这个口径:Qwen3.8-Flash-Next-Base相对上一代Qwen3.7-Plus-Base,激活参数约为1/3,训练token约为1/3,对应训练FLOPs大约1/9。
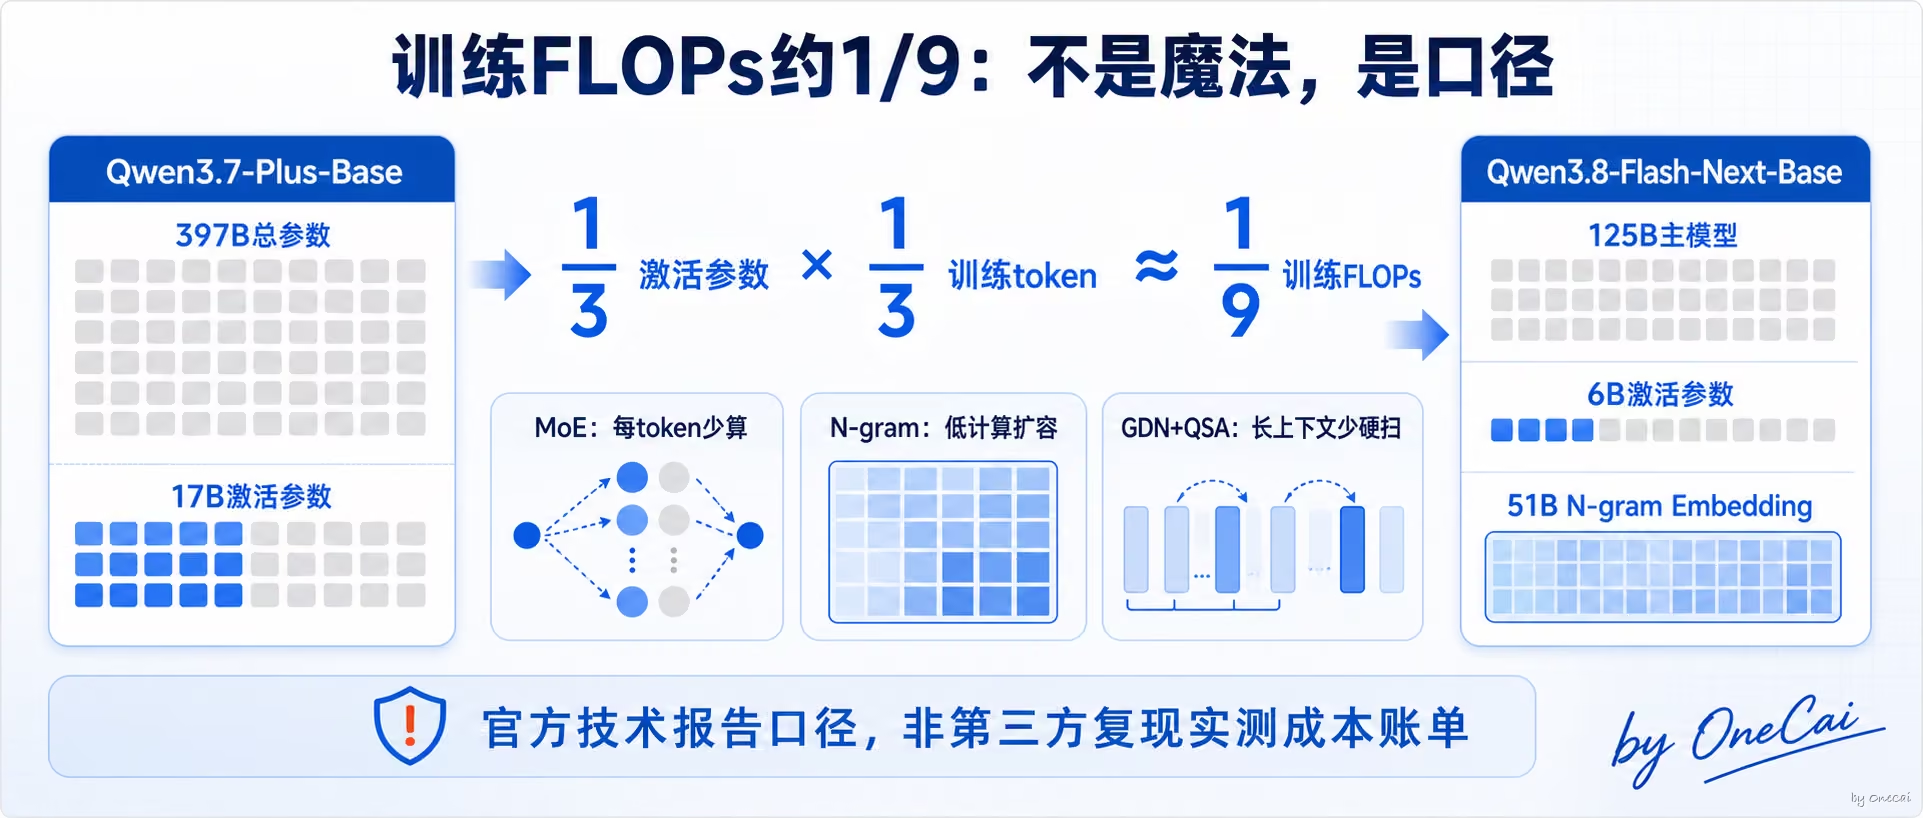
这句话可以写,但要写成官方技术报告的解释口径,而不是已经被外部复现实测的成本账单。
更具体地说,官方对比对象是Qwen3.7-Plus-Base。Qwen3.7-Plus-Base是397B总参数、17B激活参数;Qwen3.8-Flash-Next-Base是125B主模型参数、6B激活参数,另有51B N-gram Embedding。技术报告称Flash-Next-Base在14项基础评测里有8项超过Qwen3.7-Plus-Base,其余项目差距最多2.6分,同时只用了约1/3激活参数、约1/3训练token。
这里需要把因果讲稳:1/9不是某个单一模块省出来的,而是激活参数下降和训练token下降共同形成的FLOPs口径。GDN+QSA、N-gram Embedding、门控残差、Muon优化器这些设计,分别影响长上下文效率、低计算扩容、信息流和训练稳定性,它们共同支撑了这个结果,但公开资料没有给出每个模块各自省了多少成本的拆分账。
Muon优化器也可以简单带一句。技术报告里还有一个细节:在他们的实验里,batch size warmup没有带来更好结果,反而需要多18.8%的优化器步数。所以这一代直接从目标batch size开始训练。这个数字属于训练方法论,不要算进架构模块本身的节省。
性能数据只挑三组
跑分很多,但这篇文章不是榜单汇总,数字只要能支撑三本账这条主线就够。
第一组是参数对比。Qwen3.8-Flash-Next-Base是125B主模型、6B激活、51B N-gram Embedding;Qwen3.8-27B-Base是27B总参数、27B激活;Qwen3.7-Plus-Base是397B总参数、17B激活。这组来自Qwen技术报告表11。
第二组是基础模型评测。技术报告称Flash-Next-Base在14项benchmark中有8项超过Qwen3.7-Plus-Base,并且在剩余项目上保持竞争力。这里适合写结论,不建议把14项表格完整搬进正文。
第三组是长上下文。技术报告表3给了RULER和8-needle MRCR数据:在512K到1M区间,RULER从full attention的90.08提升到QSA的93.00;MRCR在512K从30.66到40.53,在1M从20.71到26.44。这些数字可以用,但要说明它们来自官方技术报告,仍待外部复现。
Agent和编程类跑分也可以点到为止。模型卡列了DeepSWE 1.1为58.7,SWE-bench Pro为62.5,CoWorkBench为73.9,Toolathlon Verified为73.5。注意措辞不要写成全都是Qwen自建框架;模型卡备注显示,部分任务用了Claude Code或mini-SWE-agent harness,CoWorkBench这类才是内部benchmark。更稳的说法是:这些是模型卡自报评测,部分用公开或常见harness,部分为内部benchmark,目前没有看到独立第三方复现。
对普通使用者意味着什么
如果只是调用API,不需要记住125B或180B,真正影响体验和账单的是激活计算量、上下文长度、输出长度和价格。
QwenCloud上线的生产版本叫Qwen3.8-Flash。按2026年8月28日页面显示,它的价格是输入每百万token 0.15美元,输出每百万token 0.47美元;隐式缓存输入和显式缓存读取都是每百万token 0.016美元,显式缓存创建是每百万token0.2美元。页面还列出上下文1M,最大输入991K,最大输出131K,最大reasoning 262K。价格和限额变化快,发布前还要再刷一次官方页面。
如果打算本地部署,6B激活参数不等于6B模型体积。Hugging Face页面显示模型大小约180B参数,vLLM Recipes等实现侧资料给出的检查点体积是FP8约172.78GiB、BF16约335.28GiB。稀疏激活省的是计算,不是把权重变没。
不过N-gram Embedding的offload确实影响显存预算。SGLang文章写到,PLE这块51.2B参数约95.4GiB BF16,可以放在主机内存里,只把每个token选中的少量行搬到GPU;vLLM Recipes也给出了N-gram Embedding offload的部署要求。对支持PLE offload的服务框架来说,这是显存预算上的重要优化,但它不是所有硬件、所有框架都自动享受的好处。
还有一个口径差异值得留意:开放权重的Qwen3.8-Flash-Next模型卡写的是原生262,144 tokens,通过YaRN扩展到1M;QwenCloud产品页对生产版Qwen3.8-Flash的表述是原生支持百万级上下文。官方模型卡也说,Qwen3.8-Flash是基于Qwen3.8-Flash-Next、带有更多生产功能的官方版本。也就是说,云端生产版和开放权重预览版高度相关,但不能在没有官方明示的情况下,把两者当成完全同一个东西。
最后落到一个朴素判断:短问答场景不需要把这套架构想得太神秘,用户也不是每次都在跑176B或180B的全部重量。真正能吃到这套设计红利的,是长文档、代码库、agent任务这类上下文很长、调用很多、计算量能被稀疏化的场景。
本文属于也算技术系列。参数量和算力口径的关系,之前在《模型标着671B参数,消费级显卡真的扛不住吗?》里拆过MoE路由怎么把总参数和激活参数分开算;算力数字本身怎么被稀疏化放大,见《显卡的稀疏算力是怎么把数字吹一倍的?》。这一篇是这两条线在新架构上的延伸,多出来的那本查表记忆账,是前两篇都没遇到过的新记法。
资料边界说明
- 官方一手:Qwen官方博客、GitHub仓库QwenLM/Qwen3.8-Flash-Next、Hugging Face模型卡、Qwen技术报告PDF、QwenCloud产品页与定价页。
- 实现方一手:SGLang/LMSYS day-0支持文章、vLLM Recipes。这些资料解释了QSA、PLE/N-gram Embedding offload和部署细节,但属于生态合作实现资料,不等于独立审计。
- 第三方媒体与聚合页:只用于观察传播口径和部署讨论,不作为核心事实来源。
- 可以采用但要标注边界的数字:训练FLOPs约为Qwen3.7-Plus的1/9、14项基础评测中8项领先、RULER/MRCR长上下文分数、QSA加速倍数、Agent和编程类跑分。这些都有官方或实现方出处,但目前没有看到第三方独立复现。