前几天有个读者在后台丢给我两个数字,问我这俩是不是写错了。
一个是Qwen3.8-27B,权重文件55.6GB。另一个是Qwen3.8-Flash-Next,权重文件360GB。她说,都叫“开源模型”,怎么能差出这么多?是不是后者故意堆参数糊弄人?
我先说结论:没写错,这俩数字都对,而且这个反差比表面看起来还要更反直觉——因为Flash-Next虽然文件是27B模型的六倍还多,但它每处理一个字,实际要算的参数反而比27B模型少得多。
这就是这篇要讲的事。开源、开放权重,这几个词只说明你能拿到权重文件,不说明你的电脑能不能跑,也不说明这个文件到底代表多大的计算量。文件大小、参数总量、实际算力,是三本不同的账,很多人下载模型前根本没意识到自己在算哪本账。
同样叫开源,文件大小先差在存储精度
权重文件说到底就是一堆数字,每个参数用几个比特存,直接决定文件多大。最粗但最好用的公式是:
模型权重体积 ≈ 参数量 × 每个参数占用字节数
常见精度可以这么估,我顺手把10B参数当基准算了一遍,方便对照:
| 格式 | 每个参数大约占用 | 10B参数大约多大 |
|---|---|---|
| FP32 | 4字节 | 40GB |
| FP16/BF16 | 2字节 | 20GB |
| FP8 | 约1字节 | 约10GB |
| GGUFQ8_0 | 约1.0字节(约8.5bit) | 约10~11GB |
| GGUFQ5_K_M | 约0.7字节(约5.7bit) | 约7GB |
| GGUFQ4_K_M | 约0.55 | 约5.5~6GB |
这里需要注意的是,Q4不等于“精确4bit”。GGUF里的K-quant是混合精度,同一个模型里不同张量会用不同位宽,注意力层可能给得比前馈层更高。所以你会看到两个网站对同一个Q4_K_M模型报出来的体积对不上,不一定是谁算错了,很可能是量化配置本身就不完全一样,统计口径也不同。
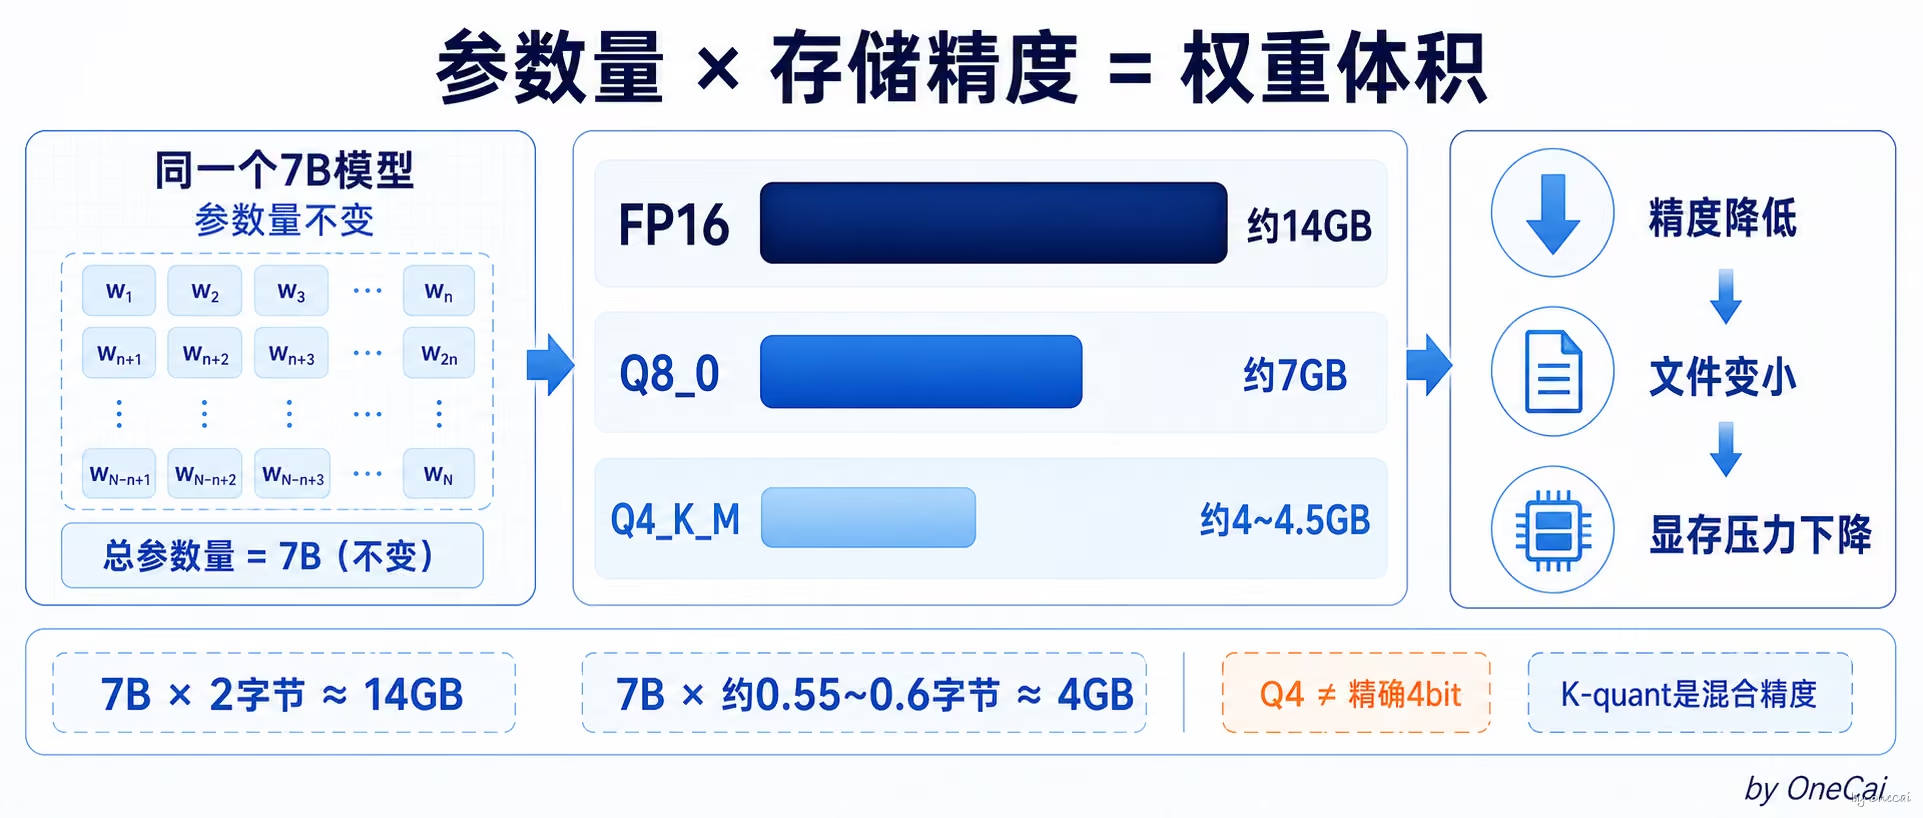
4GB模型从哪来
标题里的4GB不是随便举的例子,它对应的是7B级模型的Q4_K_M量化文件——这一点必须先说清楚,因为它和后面要讲的360GB根本不是同一个模型的两个版本,是两种完全不同规模的模型分别在讲自己的量化区间,读到后面别把这两条线接错了。
拿一个7B模型算:FP16原始权重大约13.5到14GB,Q8_0量化后大约7到7.2GB,Q4_K_M量化后大约4到4.5GB。标题里的4GB,就是这么来的。代入前面那个公式对一下:7B乘以Q4_K_M大约0.55到0.6字节,约等于4GB,数字对得上。
这不是压缩包魔法,是用精度换体积,代价也很实在。量化越狠,文件越小,显存压力越低,但输出质量、长上下文稳定性、工具调用可靠性都可能受影响。聊天、摘要、轻量写作,4bit通常够用;代码、数学、结构化输出、长链路Agent任务,低比特量化的波动会更明显——这条不是绝对规则,但足够作为“要不要用更低量化”的第一道筛选标准。
所以严格说,“4GB的开源模型”这句话本身不太准确——准确的说法是“某个7B模型被量化到Q4_K_M之后是4GB”。模型本身没有一个固定体积,同一个模型换个精度存,体积能差出三倍多。
dense模型的文件大小,就是它的真实计算量
把这套账本套到Qwen3.8-27B上。
官方模型卡显示这是一个27B参数的语言模型,权重用BF16存储,HuggingFace上是18个分片,我直接用HuggingFace的文件列表接口把这18个分片的体积加了一遍,合计约55.6GB——和“27B乘以BF16的2字节约等于54GB”这个估算基本对得上,中间的零点几GB差异来自配置文件和一些非权重的小文件。
Qwen3.8-27B是个dense模型,处理每一个字的时候,27B个参数全都要参与计算。对dense模型,你可以先建立一个简单直觉:文件越大,通常参数越多;参数越多,每个字要算的矩阵乘法也越多;显存、速度、成本,基本是同步往上走的。关于dense和MoE的架构区别,账号之前在《本地模型别只看总参数:稠密和稀疏差别很大》中专门讲过,这里不重复。
这本账简单、直接,也符合大多数人对“模型越大越费资源”的第一直觉。麻烦的是下一节。
MoE模型的体积和计算量会分开
Qwen3.8-Flash-Next就是打破这个直觉的样本,而且打破得相当彻底。
官方口径:125B参数的主模型,另外还有51B的N-gram Embedding,每处理一个字只激活6B参数。这句话在Qwen官方GitHub仓库、官方X账号、LMSYS/SGLang官方技术博客三处表述一致。
架构上再细一层:这个MoE层一共有512个专家,每个token走top-10路由专家再加1个共享专家——这条数字在RadixArk的量化模型卡、LMSYS官方博客、以及第三方技术媒体CometAPI三处相互印证,可以采信。
125B加51B,官方通常说合计176B,但如果你去看HuggingFace模型卡的safetensors文件头,写的是180B。多出来的这4B,是打包进checkpoint里的一个叫MTP(Multi-Token Prediction,多token预测)的小模块,官方对外宣传时一般不把它算进主参数量,但它确实躺在权重文件里,占体积。所以176B和180B两个数字都没错,只是统计口径不一样。
再看体积。按vLLM官方部署文档,Flash-Next的BF16权重合计335.28GiB,FP8官方版本172.78GiB。这里提醒一个坑:GiB是1024进制,GB是1000进制,335.28GiB换算成十进制GB约360GB,你看到335GB和360GB两个说法,讲的是同一件事,不是两个版本,单位没统一而已。
关键在6B这个数字。文件里躺着176B(或180B)个参数,但每处理一个字,真正参与矩阵乘法的只有6B。剩下的参数去哪了?一部分是没被路由选中的“专家”,另一部分是那51B的N-gram Embedding。
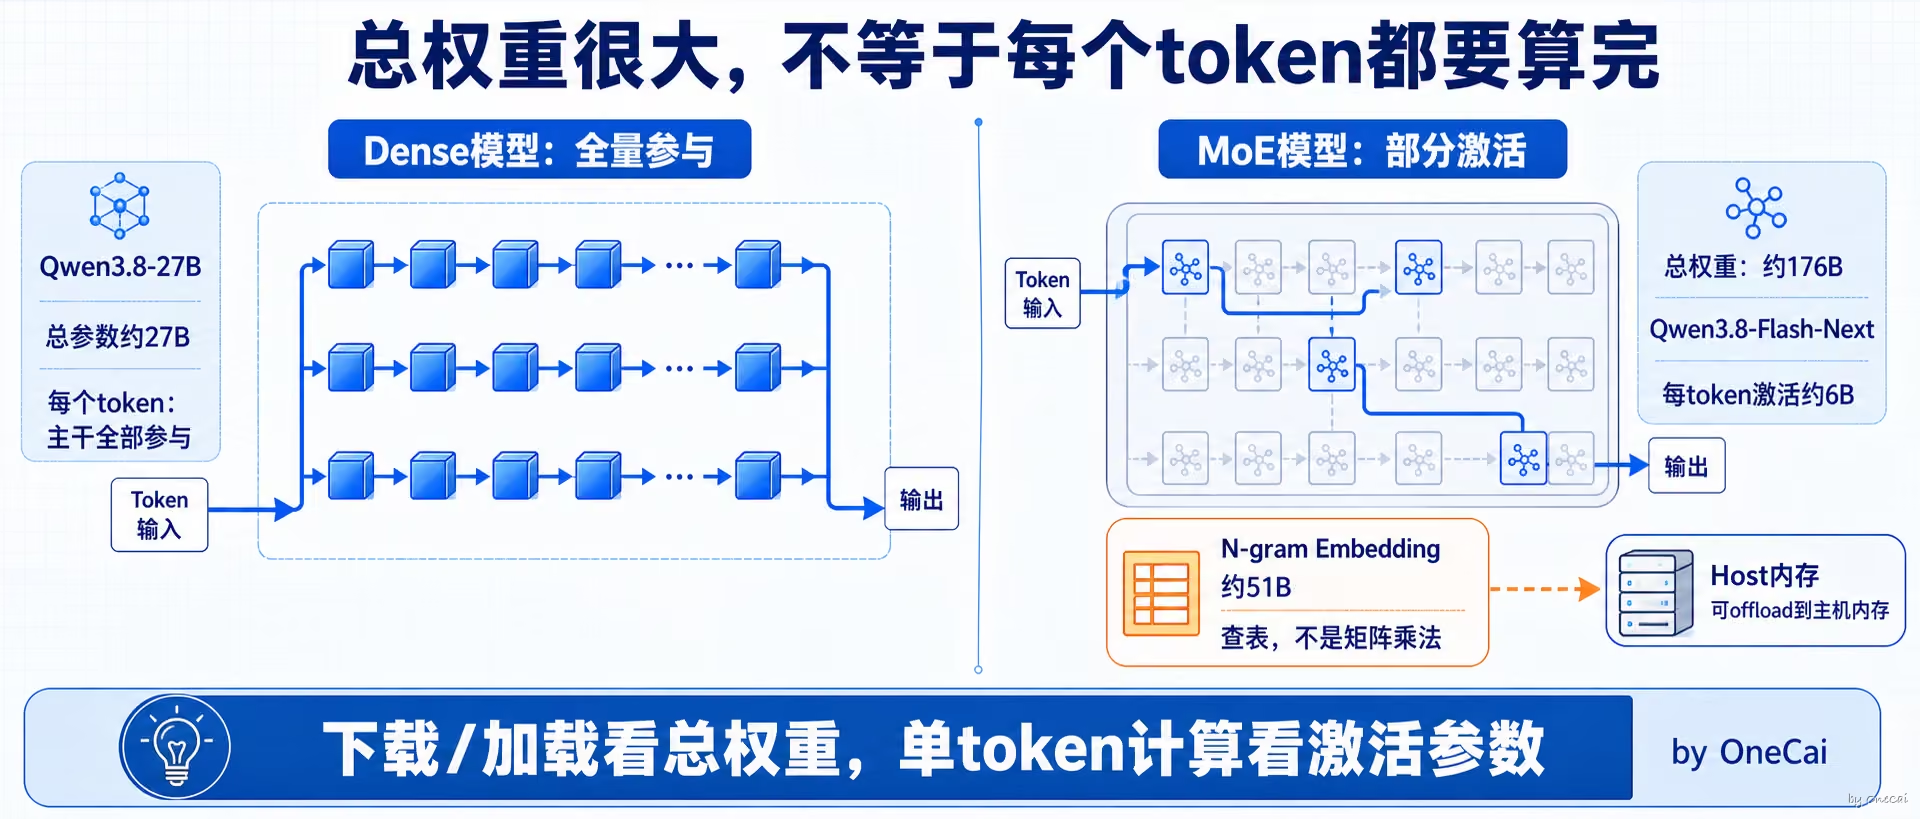
N-gram Embedding本质是一张查表,根据最近几个字做哈希查找,取出预先算好的向量,不涉及矩阵乘法。因为是查表不是计算,官方部署文档明确说这部分可以offload到host内存(也就是普通内存,不是显存),异步预取,并且给出了具体门槛:至少51GB host内存起步,再加运行余量。这个数字和51B参数按BF16存对应的体积基本吻合,也说明官方是把整张表原样放进了内存,不是又做了一轮压缩。这就是体积和算力脱钩的物理原因——它更像仓库里一整排档案柜,柜子占地方,但你查一份文件的时候不用把整排柜子都搬到桌上。
怎么从文件名反推自己的机器够不够
下载模型前,可以先做一个粗判断:
| 看到的格式 | 粗略估算 |
|---|---|
| F16/BF16 | 每10B参数约20GB |
| FP8 | 每10B参数约10GB |
| GGUFQ8_0 | 每10B参数约10~11GB |
| GGUFQ4_K_M | 每10B参数约5.5~6GB |
| MoE模型 | 总权重看下载/加载门槛,激活参数看单token计算量 |
这个表只够做第一眼判断,真正跑起来还有几块开销这张表没算进去。
第一是推理框架。Transformers、vLLM、SGLang、llama.cpp、Ollama支持的格式和优化路径不一样,模型卡上写了“兼容”不等于你的框架和硬件组合能直接跑起来。
第二是KV Cache。上下文越长,KV Cache占的显存越多,短对话不明显,到几十万甚至百万token上下文就会变成真正吃显存的部分。这部分账号之前在《上下文窗口:标称1M的token,为什么32K就开始变笨》中专门写过,这里不展开。
第三是并行和运行余量,MoE模型在这块尤其容易被低估。还是拿Flash-Next举例:官方FP8权重172.78GiB,但按vLLM官方给出的验证配置,GB300上TP2(双卡并行)是官方验证过的最低门槛,TP4是推荐的满配部署;BF16权重在TP2配置下,单张GB300实测占用约190GiB。能把文件加载进显存,不等于跑得舒服——MoE还要算专家并行、通信开销、以及prefill和decode阶段各自的额外显存需求,这些都不在“文件大小”这一个数字里。
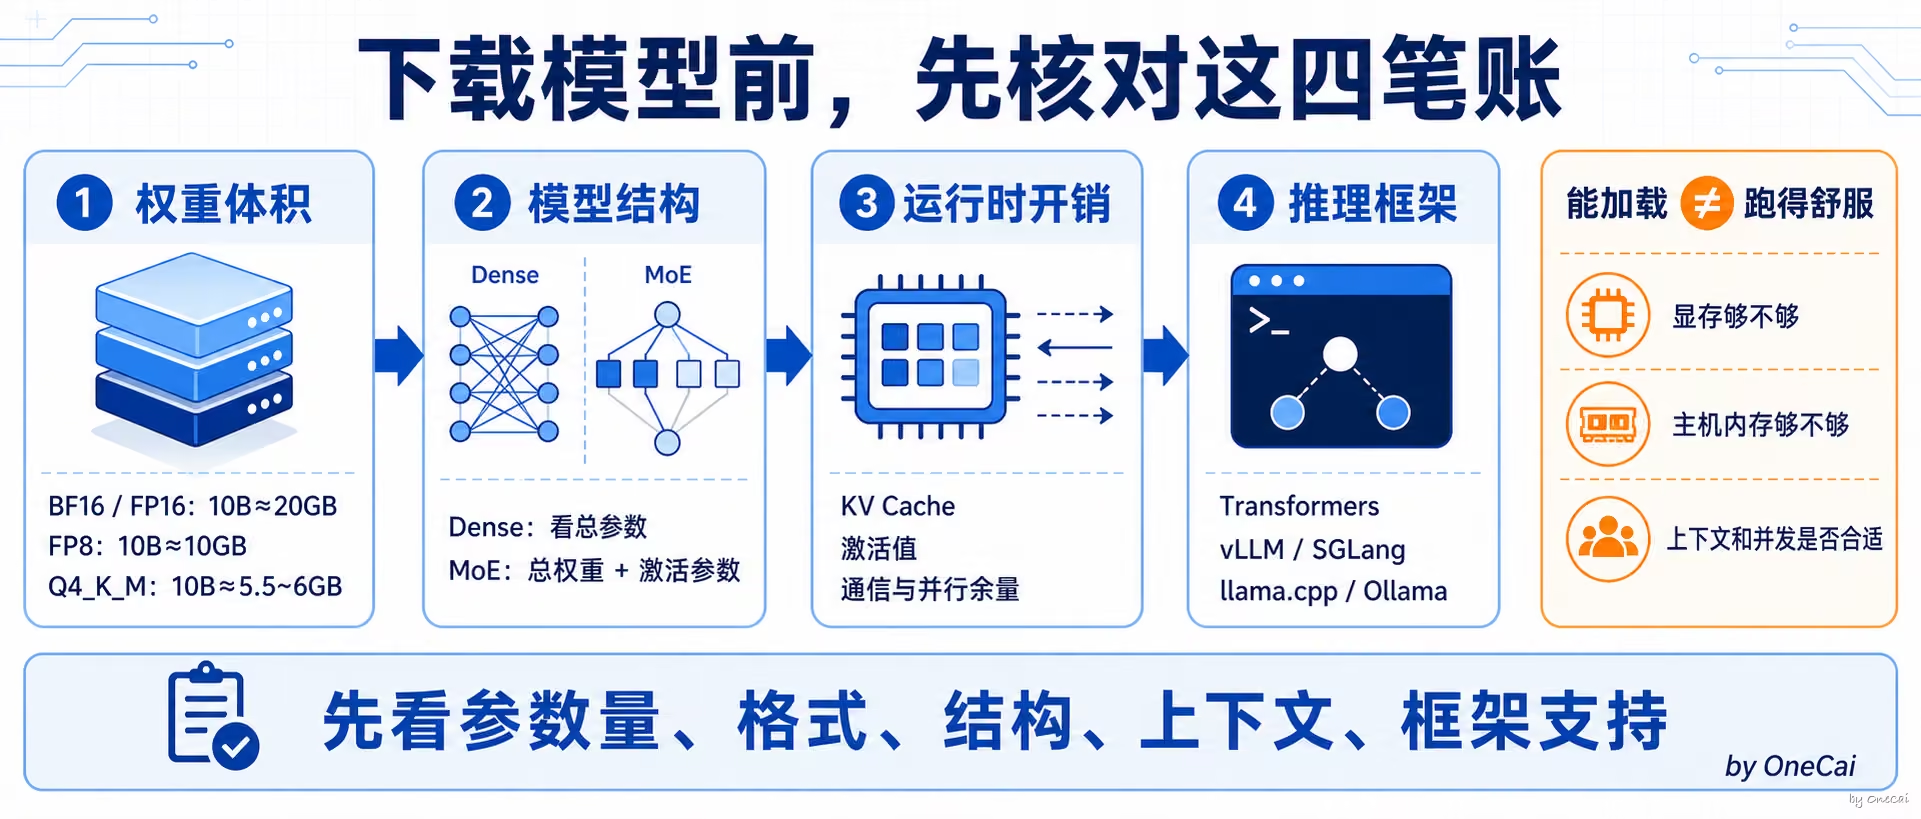
开源模型下载前,看这几行就够了
看参数量——7B、27B、70B、176B完全不是一个量级的东西。
看存储格式——BF16、FP8、Q8、Q4,同一个模型换个格式,体积能差三倍以上,而且要确认有没有你要用的具体量化版本。
看模型结构——dense模型看总参数就基本等于看计算量;MoE模型必须把总参数和激活参数分开看,这是这篇最想讲清楚的一件事。
看上下文长度——上下文开得越大,KV Cache吃的显存越多,这是权重体积之外的另一笔开销。
看推理框架支不支持——同一个量化格式,不同框架的支持程度不一样,下载前先确认能不能跑起来,而不是模型卡写“兼容”就默认能跑。
回到开头那位读者的问题:Qwen3.8-27B和Qwen3.8-Flash-Next这两个数字都没写错,而且这次的样本比账号以前遇到的任何一次都更极端——一个55.6GB的dense模型,一个360GB的开放权重模型,但后者每处理一个字反而只激活6B参数,比前者少得多。参数量不等于算力需求,这次算是把这句话摆到了最夸张的一个案例上。以后再看到“开源模型”这四个字,别急着问能不能跑,先看看这几本账对不对得上。
写在最后
这篇涉及的数字比较多,如果你正好在自己的机器上试过Qwen3.8-27B或者Flash-Next,欢迎在评论区说说实际占用和这篇里的数字对不对得上——不同量化版本、不同推理框架报出来的体积经常会有出入,你的实测数据比我这边查到的任何一个二手数字都更有参考价值。
如果这篇对你有用,点个在看让更多人看到;账号会持续追踪开源模型的算力账,星标一下不容易错过更新;下一篇打算专门讲讲DeepSeekV4和Gemini3.5这两个新模型的上下文窗口设计,感兴趣的话可以留言告诉我。
资料边界说明
一级信源:Qwen官方GitHub仓库(QwenLM/Qwen3.8-Flash-Next)、Qwen官方X账号发布内容、Qwen3.8-27B与Qwen3.8-Flash-Next的HuggingFace官方模型卡、HuggingFace模型文件列表API(用于实算权重分片体积,核实日期2026年9月1日)、vLLM官方Recipes文档(BF16/FP8权重体积、TP2/TP4部署配置、N-gram Embedding host内存需求)。
准一级信源:LMSYS/SGLang官方技术博客关于Qwen3.8-Flash-Next的Day-0支持说明(512专家、top-10路由架构细节)。
二级信源:RadixArk量化模型卡与第三方技术媒体CometAPI,用于交叉印证“512专家+top-10路由+1个共享专家”这一架构细节;llama.cpp量化格式说明文档;多篇独立发布的GGUF量化技术指南(用于Q4_K_M/Q5_K_M/Q8_0的bits-per-weight数据交叉核对,已确认多个信源在Q8_0约8.5bit、Q5_K_M约5.7bit两档上收敛一致,Q4_K_M因统计口径不同存在约4.5~4.9bit的合理波动区间);7B模型在FP16/Q8_0/Q4_K_M三档的实测体积数据(已用四个独立信源交叉验证)。
说明:GiB与GB为不同进制单位,本文中Flash-Next的BF16权重“335.28GiB”与“约360GB”指同一数值,非两个不同版本,特此说明以避免混淆。
参考链接(WeChat正文不支持超链接,发布前请确认以下网址以纯文本形式放在文末): huggingface.co/Qwen/Qwen3.8-27B huggingface.co/Qwen/Qwen3.8-Flash-Next recipes.vllm.ai/Qwen/Qwen3.8-Flash-Next