前面这篇讲开源模型文件大小的时候提过,下一篇打算专门讲讲长上下文这件事——这两天把DeepSeekV4和Gemini3.5两家的官方资料翻了一遍,发现比预想的更有意思:两家都说自己能处理百万token上下文,但你要是想知道这个百万token是怎么算出来的,两家给你的答案完全不是一回事。
一家把压缩算法、参数规模全部摊开给你看;另一家官方文档翻遍了,架构只字未提,能查到的是精确到具体token数的输入输出上限、一套token计数工具,还有一份自己测出来的检索精度评测。两边都亮出了检索精度会随长度下降的数字,但用的不是同一把尺,也不能直接拿来比高低。
这篇不重复讲“标称窗口为什么会变笨”,也不重复讲“长上下文值不值得多付钱”,这两个问题在之前的文章中已经讲透了,也已经算过账。这一篇只问一件事:同样喊出百万token,这两家各自是怎么把这个数字做出来的。
DeepSeekV4:把压缩算法摊开给你看
DeepSeekV4的百万token上下文,是靠一套新的混合注意力架构换来的,官方模型卡把这套架构的名字、压缩比、代价都写清楚了。
V4系列有两个版本。V4-Pro总参数1.6万亿(1.6T),每个token激活49B;V4-Flash总参数284B,每个token激活13B。两个版本都支持100万token上下文。参数总量和激活参数量分开看这件事,V4能把百万token这件事扛下来,靠的不是激活参数堆得多,而是下面这套新注意力机制。
V3.2版本用的是多头潜在注意力(MLA)。V4把这套机制换成了两种压缩注意力交替使用的混合架构:
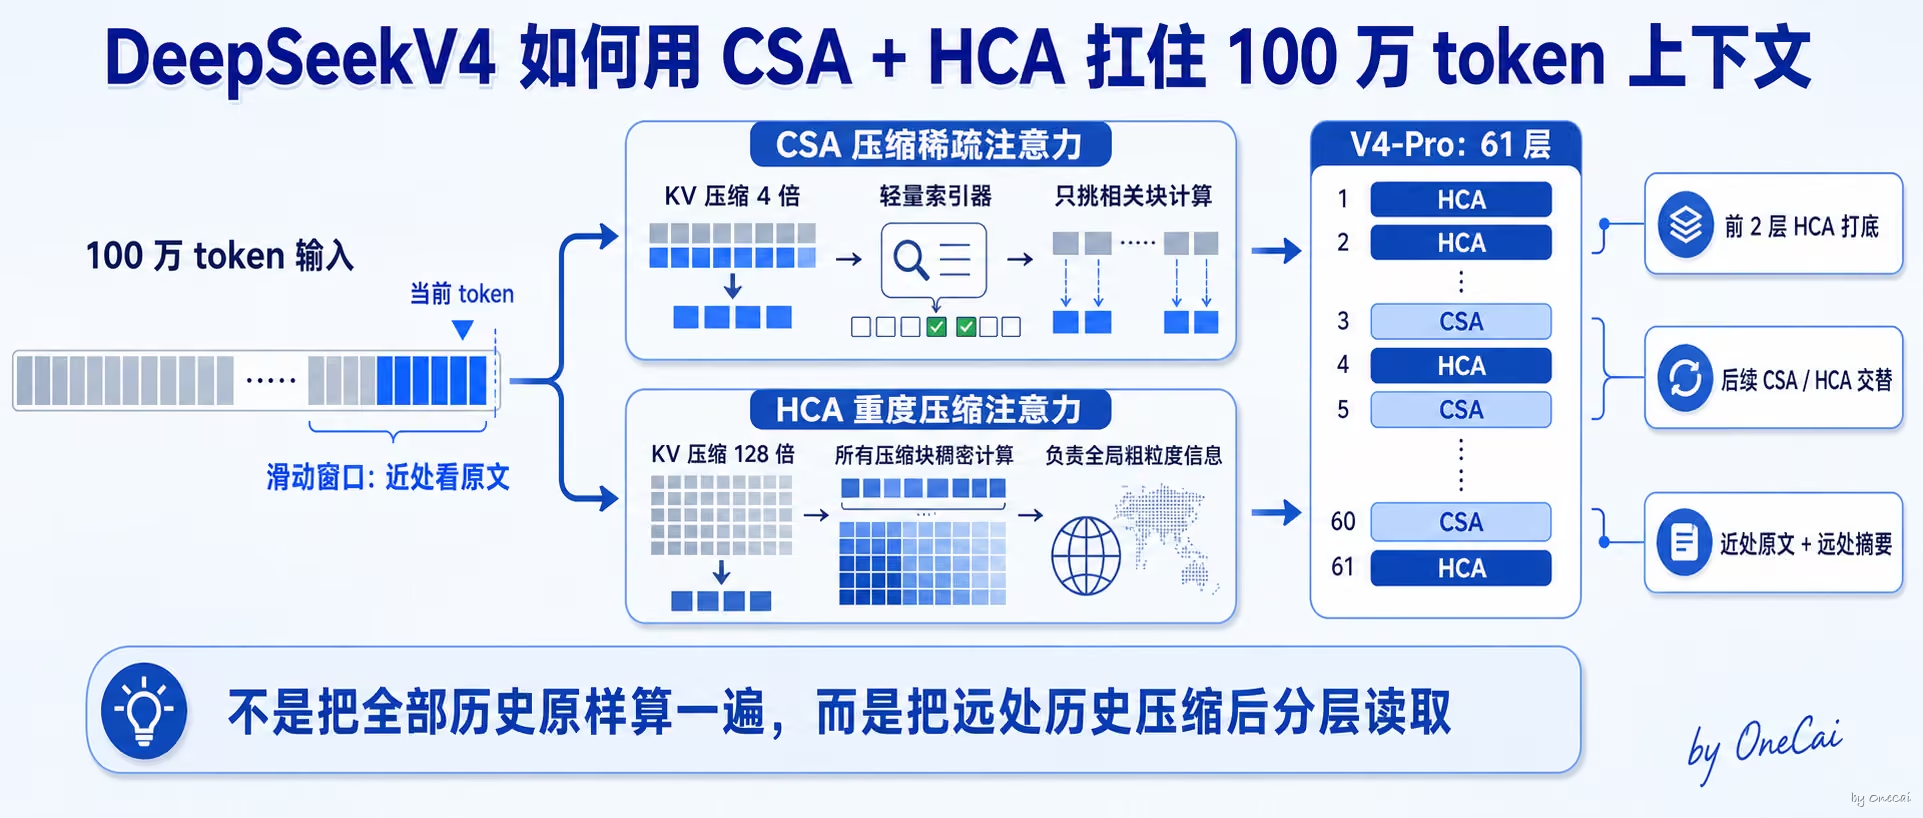
压缩稀疏注意力(CSA):把KV条目压缩4倍,再配一个轻量级索引器,从压缩后的块里挑出跟当前token最相关的那部分去算,不是每块都算。
重度压缩注意力(HCA):压缩比拉到128倍,但对所有压缩块做稠密计算,不做筛选,负责打底、抓全局粗粒度信息。
V4-Pro一共61层,前两层用HCA打底,后面的层里CSA和HCA交替搭配。两种机制都单独保留一个滑动窗口分支,专门处理最近几十到上百个未压缩的token,确保离得近的字不会被压缩糊掉——说白了就是“近的东西看原文,远的东西看压缩摘要,且摘要本身还分粗读和细读两档”。
存储精度上也做了配合:大部分KV条目用FP8存,RoPE维度保留BF16精度,CSA里那个轻量索引器则跑在FP4精度上。压缩比和存储精度这两层叠加,才换来了官方给出的这组数字:跟V3.2比,V4-Pro单token推理FLOPs降到27%,KV Cache占用降到10%;V4-Flash的FLOPs降到10%,KV Cache降到7%。跟标准的8头分组查询注意力(GQA)比,V4所需的KV Cache大约只有2%。KV Cache这笔账具体是怎么吃显存的,《KV Cache:每读1个token,就要交一笔“显存税”》讲过原理,这里的2%就是这套压缩架构交出的成绩单。
压缩换来的代价:官方自己给出的检索精度衰减
这套账最难得的地方,是DeepSeek没有只报喜不报忧。官方用MRCR(一种在长文本里埋入多条语义相近的目标,测试模型能不能把每一条都分别精准检索出来,而不是随便捞中一条就算过关的测试)做了8-needle检索测试:256K token时,精度维持在0.82以上;到了100万token,精度降到0.59。
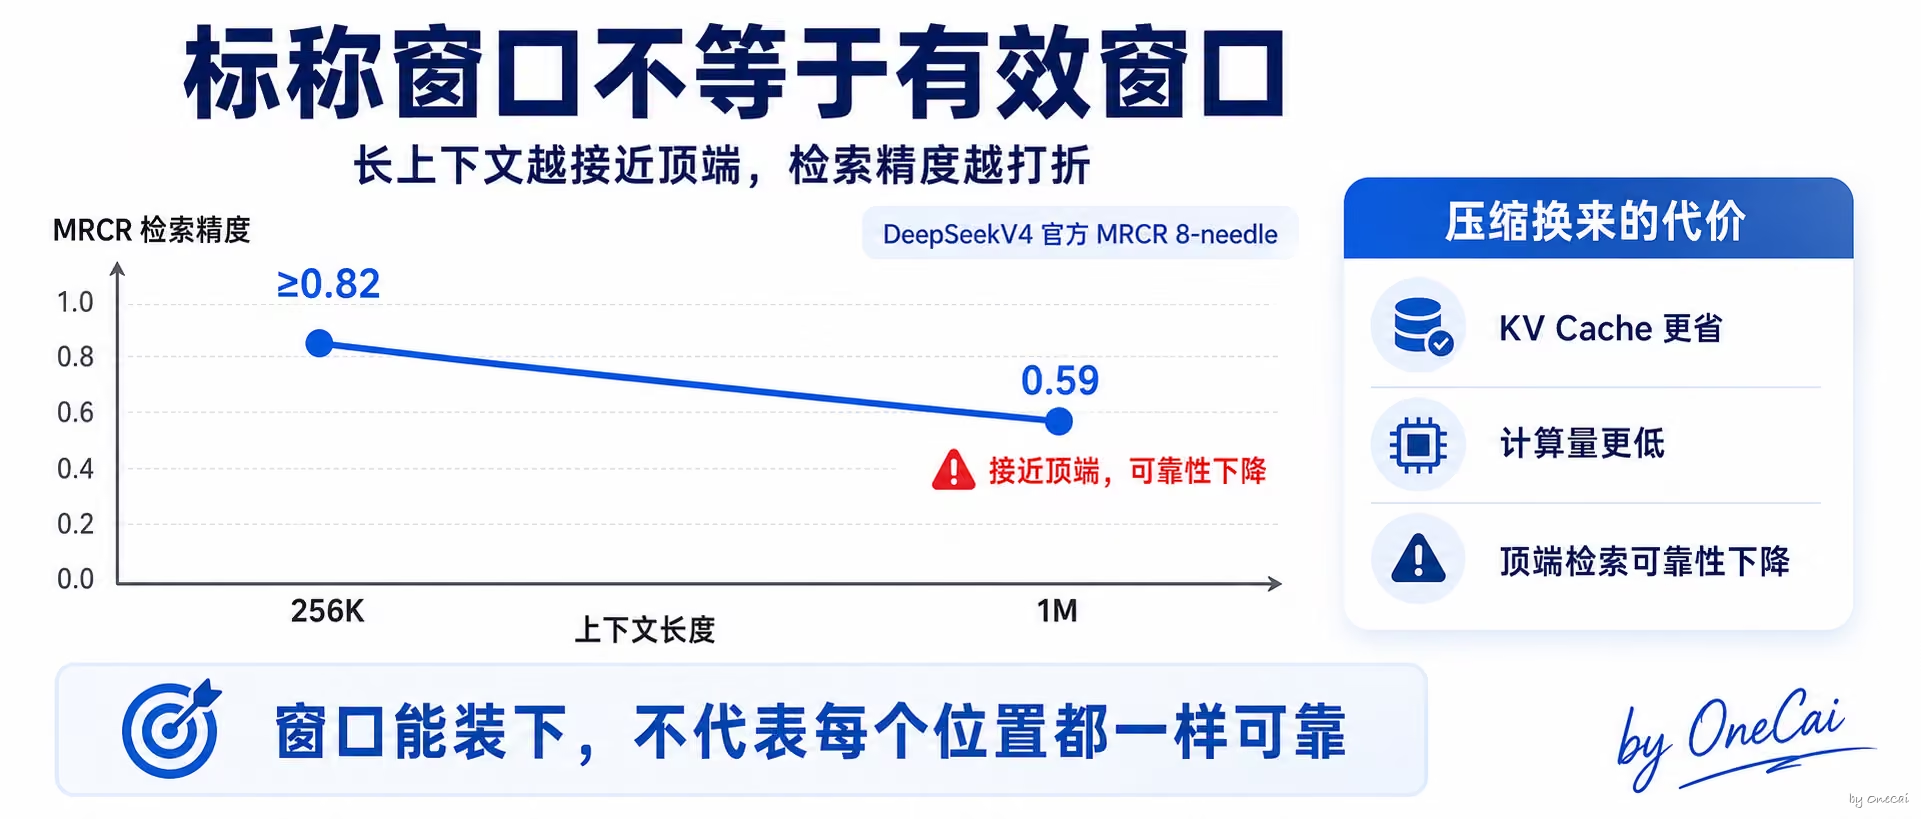
这组数字很关键。它等于官方自己承认:标称窗口是100万,但窗口用到顶端的时候,检索能力是打了折扣的。这跟036讲的“标称窗口≠有效窗口”是同一类现象,只是这次不用靠第三方跑测试去发现,DeepSeek自己把这条曲线画出来了。换句话说,V4的百万token上下文,压缩换来的不只是显存省了,检索精度这笔代价也是明码标价的。
V4的这套架构还专门为Agent场景做了优化:多轮工具调用的对话里,会保留完整的推理历史,覆盖所有轮次;工具调用用专门的|DSML|特殊token加XML格式,减少解析出错的概率。这两条跟长上下文架构关系不大,但能看出官方设计这套压缩机制时,心里装的场景就是长链路Agent任务,不是单纯的一次性长文档问答。
Gemini3.5:数字给得很精确,机制一个字不说
翻Gemini3.5这边的资料,画风完全不一样——不是不给数字,是给的数字层级不一样。
先说确定的数字:Gemini3.5 Flash于2026年5月19日发布,输入上限1,048,576token,输出上限65,536token,知识截止到2026年1月。这两个数字不是随便凑的整数:1,048,576正好是2的20次方(也就是二进制里常说的1Mi),65,536是2的16次方。DeepSeekV4这边官方口径是1M输入、384K最大输出,写法上更接近产品宣传的“整数口径”。同样叫百万token,一个精确到二进制位,一个四舍五入到人类好记的整数——这本身就是两种“怎么算出来”的写法差异,字面意义上的。
架构层面,我把Google官方的模型列表页、模型卡、长上下文说明文档都翻了一遍,没有一处提到参数规模、dense还是MoE、用的什么注意力机制。这一点和DeepSeek形成明显反差。
但Gemini不是什么都不给。官方发布了一份专门的模型评测文档,里面用MRCR v2(同样是多针检索类测试,测的是模型能不能在长文本里把多条语义相近的目标分别精准找出来)测过长上下文检索能力:128K区间平均得分77.3%,扩展到1M token时,得分掉到26.6%。这个数字和DeepSeek自己报的“1M时0.59”用的不是同一套测试协议,样本、评分方式都不同,不能直接拿来比谁的模型更强,但能确认一件事:两家官方都承认,标称窗口用到顶端时,检索能力会明显打折,只是Google选择用自家的评测集把这个折扣量化出来,没有解释背后是什么机制导致的衰减。
Google官方还提供了一套token计数工具:调用前可以用countTokens先算出输入会占多少token;调用后返回的usage_metadata里,输入、输出、缓存内容、“思考”过程各自消耗了多少token都分开列出,连thinking token都单独计费统计。这套工具解决的是“我这次请求到底用了多少配额”,跟DeepSeekV4那套CSA/HCA混合注意力要解决的“这么长的历史怎么用更少的算力处理”,压根不是一回事——前者是计量工具,后者是压缩机制。Gemini的透明度,停在了计量这一层,没有再往下一层的机制说明。
context caching(上下文缓存)也在Gemini这边,标准档位下缓存写入每百万token 0.15美元,存储费每百万token每小时1美元;标准输入输出价格是每百万token 1.5美元和9美元。但这不是Gemini独有的招数——DeepSeek自己也有前缀缓存,V4-Flash缓存命中价是标准输入价的1/50 。所以“靠缓存省钱”不是两家的差异点,两家都有;真正的差异点,还是回到架构披露本身:DeepSeek解释了压缩机制怎么把计算量降下来,Gemini没有解释。
值得一提的是,Google不是从来不披露架构。2024年的Gemini1.5技术报告里,官方白纸黑字写过:1.5 Pro是稀疏MoE架构,top-2路由;1.5 Flash是从Pro蒸馏出来的稠密(dense)模型。这份报告是公开的一级信源,说明这类细节Google不是说不出来,只是3.x这一代选择不说了。至于Gemini3.5 Pro,目前官方模型列表里还查不到它的条目,第三方渠道流出的“200万token上下文+Deep Think模式”等说法,没有官方定价或规格页佐证,只能算未经证实的预览信息,不纳入这篇的确定性结论。
两本“怎么算出来”的账,对比着看
| 维度 | DeepSeekV4 | Gemini3.5 Flash |
|---|---|---|
| 标称输入上限 | 100万token(官方口径,整数) | 1,048,576 token(2的20次方) |
| 最大输出 | 384K token | 65,536 token(2的16次方) |
| 注意力机制是否披露 | 披露:CSA+HCA混合注意力,替代V3.2的MLA | 未披露 |
| 参数规模是否披露 | 披露:Pro 1.6万亿(49B激活)/ Flash 284B(13B激活) | 未披露 |
| KV Cache占用是否披露 | 披露:较V3.2降至7%~10%,较标准GQA约2% | 未披露 |
| 长上下文检索精度评测 | 官方MRCR 8-needle:256K时≥0.82,1M时0.59 | 官方MRCR v2:128K时77.3%,1M时26.6%(协议不同,不可直接对比) |
| 前缀/上下文缓存 | 有,V4-Flash缓存命中价为标准输入价的1/50 | 有,标准档缓存写入0.15美元/百万token+按小时存储费 |
| Token计数工具 | 官方tokenizer,英文字符约0.3token、中文字符约0.6token | 官方countTokens接口+usage_metadata,输入/输出/缓存/思考token分开计 |
这对实际使用意味着什么
如果你要自建部署或者拿这两个数字去反推硬件门槛,两边能验证的东西不一样。
DeepSeekV4这边,压缩比和KV Cache占用都是公开数字,可以按照076讲过的“从文件名反推机器够不够”那套方法去估算显存门槛。但一定要把0.59这个检索精度数字也算进去——如果你的场景是要在接近100万token的位置精确检索某条信息,官方自己给出的数字已经告诉你,这个位置的可靠性不如256K的位置,标称窗口和能放心用的窗口,中间还是有落差,这一点跟036是同一类提醒。
Gemini3.5这边,你拿不到架构数字去做类似的反推——没有参数量、没有压缩比、没有KV Cache占用,26.6%这个数字告诉你“到1M会掉多少”,但不告诉你“为什么会掉”。能算的账只有两类:一类是066讲过的场景付费逻辑,同一份长文档被反复问,context caching能把成本压下来,一次性扔新文档进去问一次,缓存帮不上忙;另一类是拿countTokens把每次请求的真实token占用算清楚,避免被系统提示词、历史对话、工具调用记录这些隐性内容偷偷吃掉窗口——这几类内容会不会占用token预算,041也提醒过要看清楚。Google没有告诉你它是怎么把长上下文算得更快的,只告诉你窗口用到多少、掉了多少、花了多少钱。
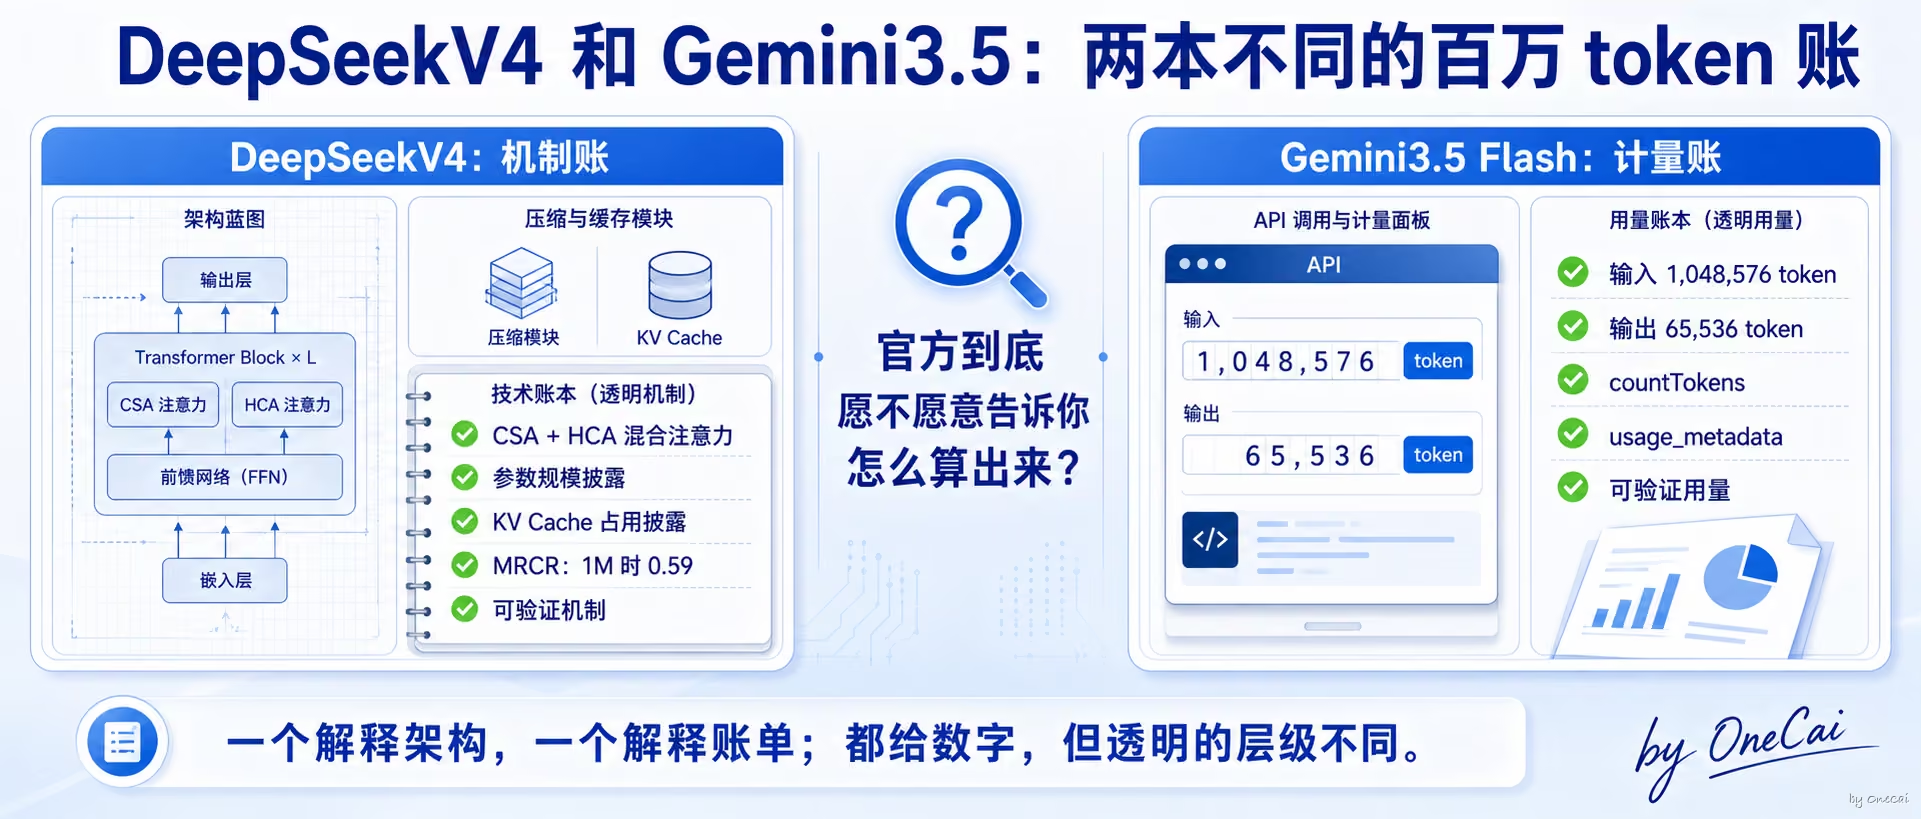
同样喊百万token,一家把压缩算法、参数规模、检索精度曲线全摊开;另一家把输入输出上限精确到二进制位、把每次请求的token去向算得清清楚楚、把检索精度的衰减曲线也测了出来,唯独不说这一切是靠什么架构撑起来的。两家给的都是“能验证的数字”,只是验证的对象不一样——一个能让你验证机制,一个只能让你验证账单。下次再看到“百万token上下文”这几个字,值得多问一句:这个数字背后,官方到底愿不愿意告诉你它是怎么算出来的。
资料边界说明
一级信源:DeepSeek官方Transparency Center发布的V4模型技术文档、DeepSeek官方HuggingFace博客(huggingface.co/blog/deepseekv4,混合注意力机制细节、FLOPs与KV Cache对比数据、MRCR 8-needle检索精度)、DeepSeek官方API定价与Token用量文档(384K最大输出、缓存命中定价、中英文字符与token换算比例)、Google Gemini API官方文档(长上下文说明页、定价页、模型列表页、Token计数文档,核实日期2026年9月)、Google DeepMind官方模型卡与模型评测文档(Gemini3.5 Flash的精确输入输出上限、MRCR v2评测结果)、Google DeepMind官方X账号关于Gemini3.5发布的表述、Gemini1.5官方技术报告(arXiv 2403.05530,用于说明Google历史上曾披露过稀疏MoE架构细节,仅作历史对照,不代表3.5代架构)。
二级信源:第三方技术分析文章(关于DeepSeekV4混合注意力架构的独立解读,及HuggingFace Transformers官方实现文档对CSA/HCA压缩比的复述)、第三方模型规格与评测聚合站点、第三方API价格聚合站点。Gemini3.5 Pro的“200万token上下文”等说法来自未经官方证实的预览/流出信息,本文未将其作为确定性结论使用。
参考链接:
- huggingface.co/blog/deepseekv4
- ai.google.dev/gemini-api/docs/long-context
- ai.google.dev/gemini-api/docs/pricing
- ai.google.dev/gemini-api/docs/tokens
- deepmind.google/models/model-cards/gemini-3-5-flash/