本文是「术语解构」系列之一。上一篇拆了KV Cache,这一篇换个模态,拆视频模型的计量单位:视频token。
文中价格与参数查证时间:2026年9月10日。视频模型定价变动频繁,请以火山方舟官网当日信息为准。
20帧/秒,字节也开始做实时视频了
据彭博援引知情人士报道,字节跳动正在准备一款基于Seedance路线的实时空间视频生成模型,目标约20帧/秒、约50毫秒延迟,面向直播、短剧、游戏和Pico头显,最快下个月发布。
基于这则消息推测:
第一,这不是正式发布的产品。没有公开演示,没有技术报告,也没有分辨率、GPU配置和价格。
第二,20帧/秒和50毫秒很可能是同一件事的两种说法。1÷20刚好等于0.05秒,也就是每50毫秒出一帧。它是帧间隔,还是你转头到画面变化的完整延迟,报道没说。
第三,实时不是新门槛。Google的Genie 3在2025年8月就做到了720p、24帧/秒的实时可交互世界;字节自己的Seaweed APT2在2025年6月也展示过24帧/秒的流式生成——8B模型在单张H100上跑736×416,升到1280×720要用8张H100。这次的新意,是字节把这条路线接到了Seedance和云端视频业务上。
那这条消息为什么还值得聊?
因为视频一旦从“生成完再播放”变成“边生成边交互”,算力账就变了。
新闻里没有价格,但字节已经公开了视频怎么收钱:Seedance 2.0纯文生视频,720p大约1元1秒。同一家公司的文本模型,写一千字不到一分钱。
视频到底贵在哪?是每个token都贵得离谱,还是token太多?
相对于单价和数量来说,单价只差几倍,数量差了几百倍。
一、一个视频token,等于1024个像素
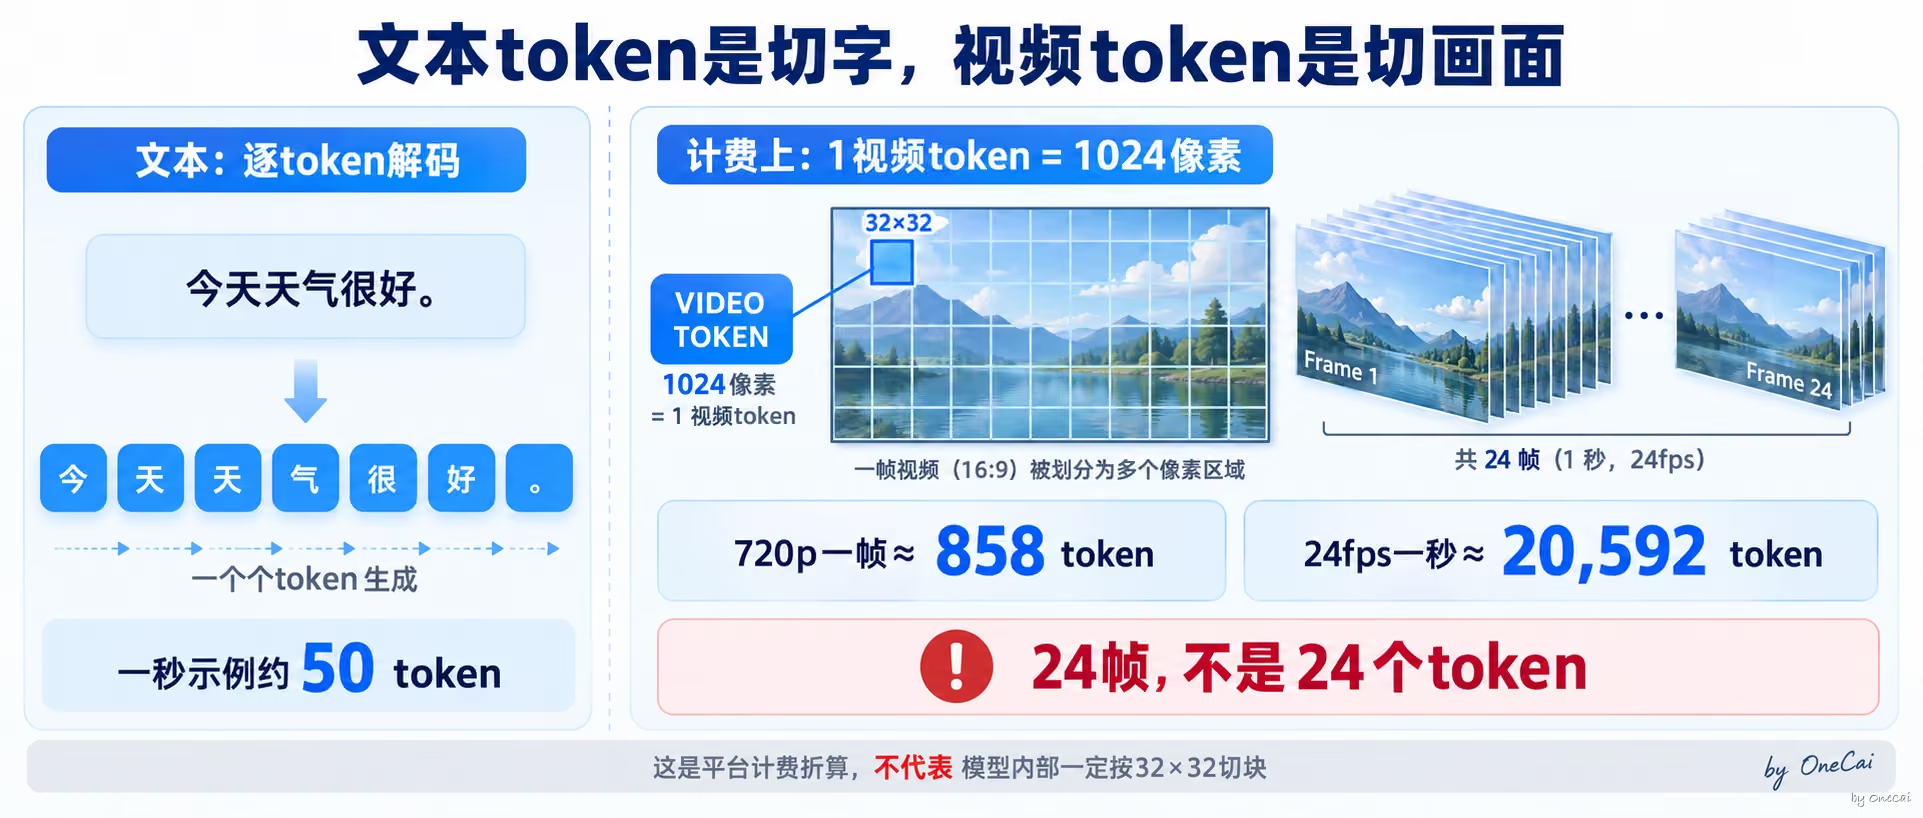
《token是什么》那篇讲过,文本模型的token大致对应一个字、半个词或一小段字符。视频模型的计费token不是这种语言单位。
火山方舟给出的估算公式是:
| |
这个估算公式的意思是,把每一帧画面切成一个个1024像素的小方块,一块算一个token——你可以把它想成一块32×32的小拼图。
文本token是切字,视频token是切图。
先划一条边界:这是计费上的折算关系,不代表Seedance内部真的把画面切成32×32的小块送进模型。模型内部还有视频编码器、潜空间压缩、patch划分这些环节,官方计费公式没有透露实现细节。顺便说明一下,本文后面所有token数字,说的都是计费口径。
拿Seedance 2.0的官方示例算一遍。生成一条15秒、720p、24帧/秒的视频,火山方舟的720p实际按1248×704计算:
| |
拆到更小的单位:
- 一帧:1248×704÷1024≈858个token
- 一秒(24帧):858×24≈20,592个token
- 换成传闻里的20帧/秒:858×20≈17,160个token
这就是视频成本的起点——文本模型一次吐一个token,视频模型每秒要持续更新两万块画面。
有一点要先说明白:视频token是平台定的计费单位,一个视频token和一个文本token承载的信息完全不是一回事,不能拿两者比“信息量”。但计费单位既然定了,就可以比价格。
二、贵的不是单价,是数量
先看单价(查证于2026年9月10日,火山方舟价格页):
| 模型 | 计费模式 | 单价 |
|---|---|---|
| Seedance 2.0 | 纯生成(不含视频输入) | 46元/百万token |
| Seedance 2.0 | 视频编辑(含视频输入) | 28元/百万token |
| Seedance 2.0 Fast | 纯生成 | 37元/百万token |
| Seedance 2.0 Mini | 纯生成 | 23元/百万token(720p约0.5元/秒) |
| DeepSeek V4 Pro(文本,平时时段) | 输出 | 6元/百万token |
Seedance 2.5的70元和42元目前只查到媒体对火山引擎公告的转述,没在价格页直接核到,所以后面的计算全部以Seedance 2.0为准。
只看单价,Seedance 2.0的视频token是DeepSeek文本token的7.7倍。贵,但不到一个数量级,真正拉开差距的,是一次任务要消耗多少token。
| 比较口径 | 视频(Seedance 2.0纯生成) | 文本(DeepSeek V4 Pro输出) | 价格差 |
|---|---|---|---|
| 按百万token单价 | 46元 | 6元 | 约8倍 |
| 按1秒输出内容 | 约1元,消耗约2万token | 约0.0003元,输出约50token | 3000倍以上 |
| 按一次常见任务 | 15秒720p约14.21元 | 3000字文章分析约0.02元 | 约700倍 |
从上面表格看来,三个不同口径,三个答案。
所以“视频比文字贵10倍”这种说法太粗。比token单价,不到10倍;比一次任务,几百倍起步。视频贵,贵在同样一秒钟的内容,它要吃掉几百倍的token。
这也解释了一个现象:文本模型的定价页只写“每百万token多少钱”,视频模型的定价页一定会附一句“每秒多少钱”。因为对视频用户来说,百万token这个数字没有体感,一秒一块钱才有。
注:表中50token/秒只是一个便于理解的示例速度,不同模型、不同负载差异很大;3000字分析按上一篇峰谷定价文章里的4000输入、1500输出估算。
三、空间账:每一帧都是一张要生成的图
那为什么一帧画面要这么多token?先算第一笔账:空间。
对于文字来说,一段文字不需要给每个字安排颜色、位置、光照和透视关系。而对于视频来说,视频的每一帧,都是一张完整的二维画面,每个位置都要有内容。
分辨率从720p提到1440p,宽和高各翻一倍,像素数变成4倍,按火山方舟的公式,计费token也是4倍。
模型内部还有一层放大。《上下文窗口》那篇讲过注意力机制的计算量随序列长度平方增长。如果某个空间注意力模块让一帧里所有画面token两两关联,token数×4,这一环节的理论计算量就接近×16。
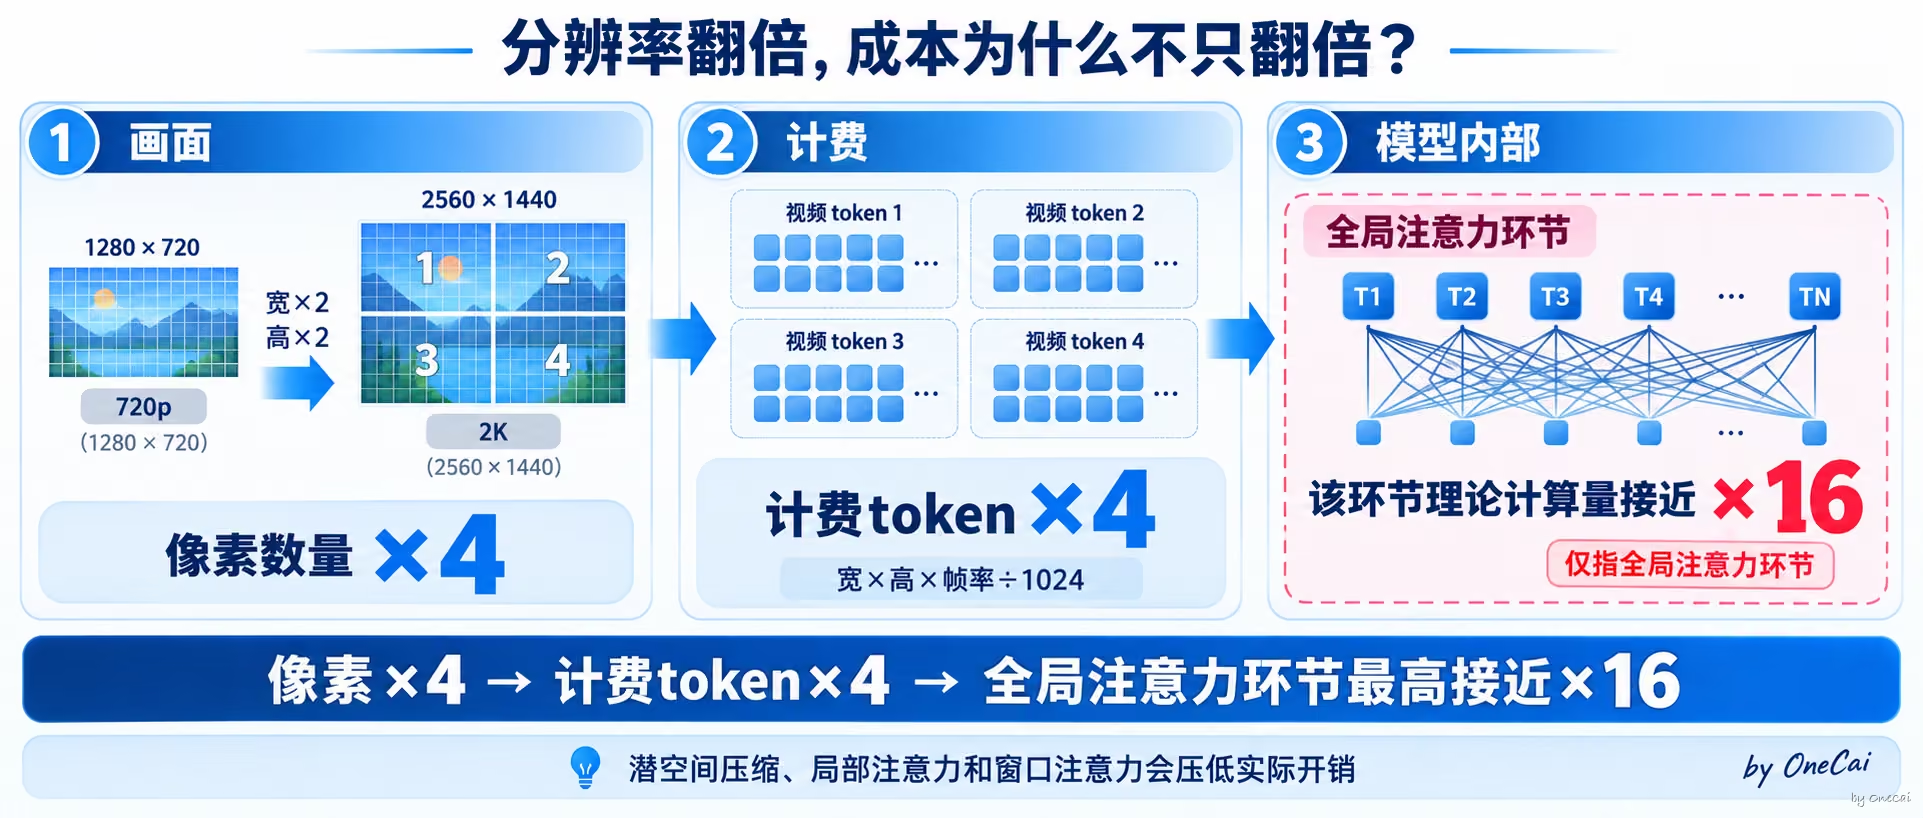
这里必须收着说:16倍只描述全局注意力这一个环节,不能写成“分辨率翻倍,整台服务器成本翻16倍”。视频模型普遍会先把画面压进潜空间再处理,还会用局部注意力、窗口注意力等手段把这笔账压下来。但方向是确定的:画面越大,成本增长得比画面本身更快。
四、时间账:视频不能只生成一张好看的图
对于一段完整视频,单帧画面对了还远远不够。
人物走到下一帧,衣服不能突然变色;汽车开过路口,不能下一秒又回到原位;镜头转过去再转回来,刚才那栋楼还得在原地。
20帧/秒的意思是,模型每秒要生成20个新的画面状态,还要让这20个状态在人物、物体、光照、动作和镜头位置上保持连续。
离线生成可以一次处理一段时间范围,让多帧互相参考,前后对齐。实时生成做不到——它不知道你下一秒往左走、往右走,还是突然要求下雨,只能一边接收输入,一边往下续写这个世界。
Google DeepMind介绍Genie 3时提过一句:模型生成每一个新画面时,都要参考不断增长的历史轨迹。你一分钟后走回原来的位置,场景还要尽量和刚才一样。这笔成本不只来自新的一帧,还来自模型对“过去发生过什么”的记忆。
而记忆本身也是两难:历史一直攒着,计算和显存越来越重;只留最近几帧,模型又会忘掉更早的建筑、人物和你做过的交互。实时世界模型要在“记得住”和“算得动”之间反复取舍。
五、修正与记忆账:一帧出来之前,模型可能已经算了好几遍
第三笔账藏在生成过程里。很多视频模型走的是扩散路线:从一团噪声开始,一轮一轮修正,直到画面成形。离线模型可以用几十步慢慢去噪,实时模型没有这个时间。
现有的实时方案大致两条路。
第一条,把去噪压短。用蒸馏、少步采样或流水线并行,把几十步压到1到4步。StreamDiffusionV2就是这条路:支持1到4个去噪步骤,14B模型在4张H100上跑到58.28帧/秒,首帧时间控制在0.5秒以内。
第二条,按帧自回归,把历史放进缓存。每生成一帧,就把它的状态存下来,下一帧接着算。LongLive采用帧级自回归和短窗口注意力,1.3B模型在单张H100上达到20.7帧/秒。字节自己的Seaweed APT2走得更远:一次生成一个潜在帧,每个潜在帧只做一次网络前向,然后靠KV Cache和滑动窗口让推理成本不随视频时长无限增长——8B模型在单张H100上跑到736×416、24帧/秒,延迟0.16秒;1280×720、24帧/秒则要8张H100。
这里有个容易写错的地方:Seaweed APT2说的是每个潜在帧一次前向,而一个潜在帧对应4个最终视频帧,不能写成“每个视频帧一次前向”。
这条路的代价,老读者应该有条件反射了:历史状态要占显存,和文本模型的KV Cache是同一个逻辑,只是缓存里存的从文字变成了连续的画面状态,规模和更新方式都要重新算。
这些案例只能说明实时视频有哪些技术路线,不能反推字节新模型用了几步去噪、几张卡、什么缓存结构。这些信息字节还没有公开。
六、实时服务税:最贵的不是多算,而是不能等
前三笔账,离线视频和实时视频都要付。第四笔,只有实时要付。
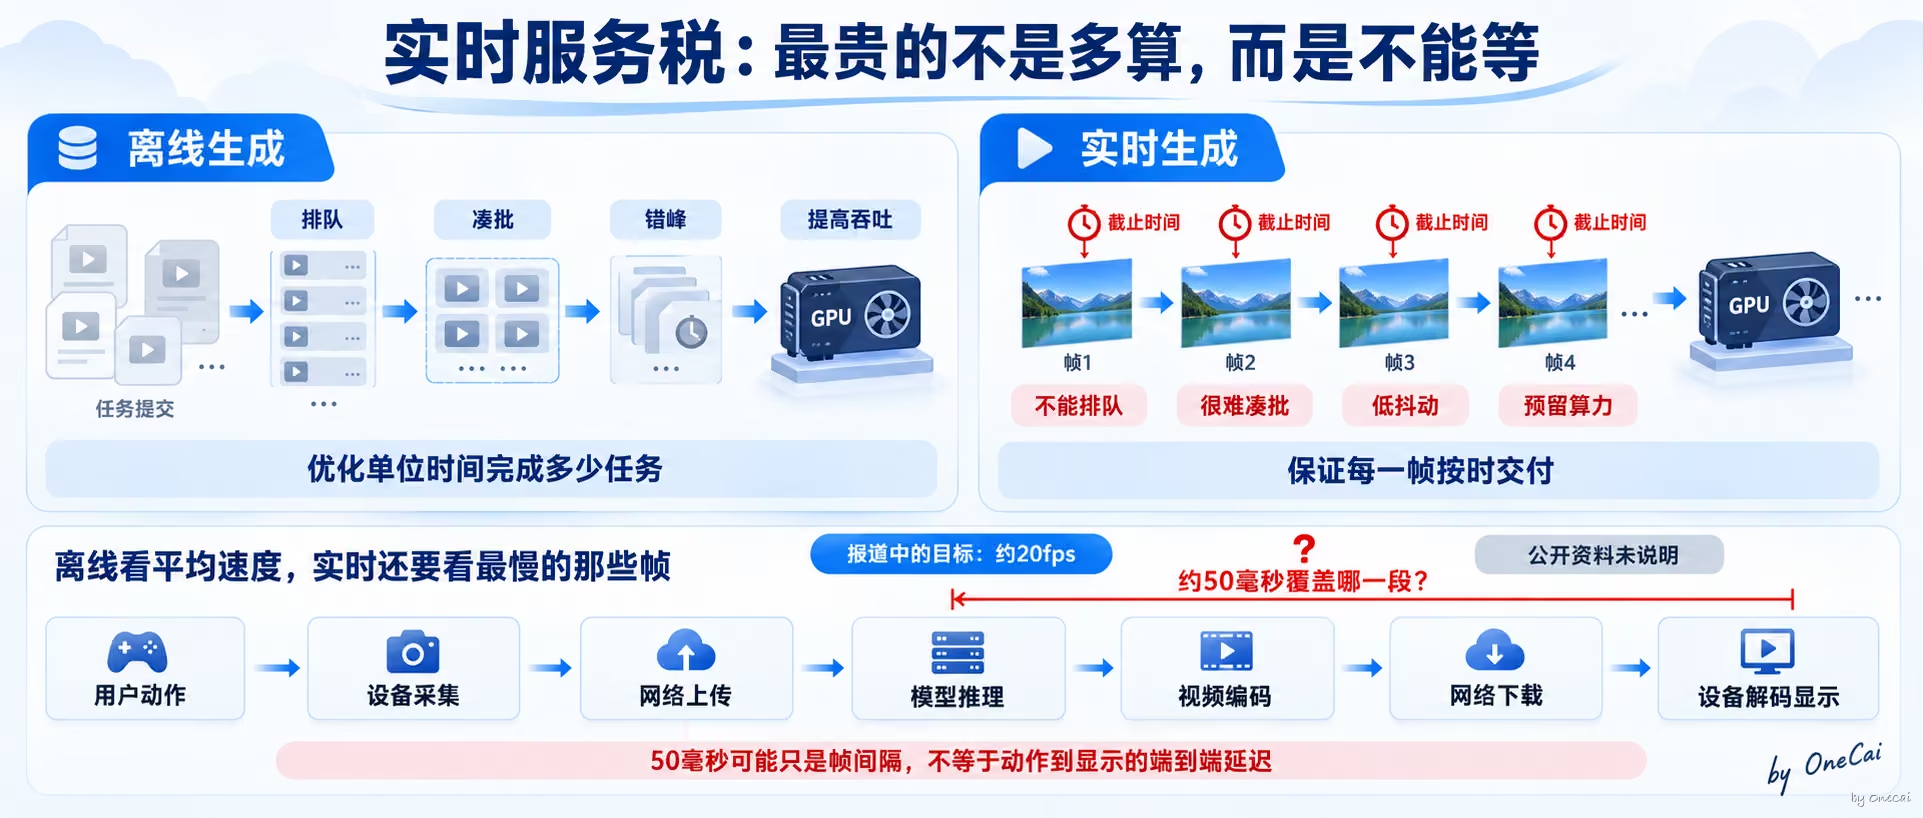
离线生成像工厂接单。任务可以排队,可以凑成批次,可以等GPU空闲时集中处理。平台优化的是“单位时间一共完成多少段视频”,这和文本模型的批处理、错峰是一个思路。
实时生成像视频通话。你转了头,下一帧必须按时出现。它不能排队,不能错峰,也很难为了提高GPU利用率去等别的请求凑齐一批。
StreamDiffusionV2的作者把这个区别说得很直白:离线系统靠批处理大负载来优化吞吐,实时直播要满足严格的SLO——首帧时间要短,每一帧都有截止期限,抖动要低。
具体到工程上,实时视频要同时盯住这些东西:
- 首帧等待时间;
- 每一帧的交付期限;
- 帧与帧之间的抖动;
- 用户输入进入模型的响应速度;
- 云端编码、网络传输和设备端解码;
- 突发负载下预留的备用算力。
举个例子。假设某个系统平均每帧要40毫秒,看起来已经满足50毫秒的帧间隔。但只要少数复杂画面突然花了80毫秒,你看到的就是卡顿。服务器不能只看平均值,还要压住慢帧出现的频率,这通常意味着预留更多算力余量。
再看一个更直观的对比。Seaweed APT2要跑720p、24帧/秒的实时流,用了8张H100——这8张卡在那一分钟里只服务这一路视频。而一张H100跑文本模型,可以同时服务几十上百个用户的对话,靠的就是把大家的请求凑成批次。实时视频把这个凑批的空间几乎压没了。
于是出现了一个反直觉的结论:实时化不一定增加同一段视频的理论计算量,却会限制批处理、提高预留容量、压低GPU的平均利用率。同样的GPU,能卖出去的有效算力变少了,账单自然往上走。模型算得再快,调度跟不上,直播照样掉帧。
这和DeepSeek峰谷定价那篇讲的是同一个道理。文本任务可以排队、错峰、批处理,所以闲时token更便宜;实时视频把这些降成本的空间压到了最小。它是“必须实时任务”的极端形态:每一帧都是高峰时段的价格。
七、20帧/秒离真正的云端交互还有多远
最后回到文章开头说到的那条新闻。字节把生成放在云端,降低的是头显本地芯片的负担。但算力没有消失,只是从设备搬进了数据中心,上一节那笔实时服务税,也全部留在了云端。
一次交互从头到尾要经过这些环节:
| |
50毫秒覆盖的是哪一段,目前没有公开答案。如果它只是服务器输出一帧的间隔,网络和显示延迟要另外算;如果它是从动作到画面的完整延迟,那技术含义完全不同。
报道也没有给出测试距离、网络条件、分辨率、首帧时间和延迟百分位。所以现在只能把20帧/秒当成一个研发目标,不能写成已经验证的云端VR体验。
能说的只有一句刻度尺:按现有Seedance 2.0的公式,20帧/秒、720p的一秒画面约1.7万个视频token。这个数字只说明输出规模。实时模型可能因为蒸馏和更高压缩率把计算压下来,也可能因为低延迟服务、交互输入和算力预留把成本抬上去——没有正式价格和测试条件,两个方向都不能下结论。
写在最后
回到标题:一个视频token等于1024个像素,为什么一秒视频要1块钱?
三句话收束:
- 视频token是切画面,不是切字。一帧720p约858个token,一秒约两万个。
- 单价和文本在同一量级,数量差了几百倍。贵的不是每个token,是同样一秒内容要吃掉多少token。
- 实时再加一层服务税。离线模型可以让你等几十秒——Seedance 1.0技术报告披露过L20上生成5秒1080p需41.4秒,靠的是低步数蒸馏、轻量VAE解码器、量化和混合并行;实时模型每50毫秒就要交一次作业,而且不能排队、不能错峰、不能凑批,优化目标完全是另一套。
这个系列反复讲“参数量不等于算力”,今天可以再加一句:token单价不等于内容成本。
往后看,视频模型还会降价,但降价不会只靠单次前向变快。更高的潜空间压缩率、更少的去噪步骤、更短的历史窗口、更有效的缓存、更高的实时GPU利用率——这五个杠杆,决定“一秒一块钱”还能往下走多远。
下一篇顺着第五节那条路往下:视频模型的KV Cache怎么算,一分钟的历史帧要占多少显存。
资料边界说明
按信源可信度分四档,越靠前越可靠:
一手官方
- 火山方舟「模型价格」页:视频token估算公式、Seedance 2.0/2.5单价、720p示例(查证于2026年9月XX日)
- Google DeepMind博客《Genie 3: A new frontier for world models》:720p、24帧/秒、参考历史轨迹的描述
- StreamDiffusionV2论文(arXiv 2511.07399,MLSys 2026):1到4步去噪、14B模型4张H100达58.28FPS、首帧0.5秒内、离线批处理与实时SLO的对比
- Seaweed APT2论文(arXiv 2506.09350)及项目页:8B模型、每潜在帧一次前向、一个潜在帧对应4个视频帧、单张H100跑736×416、8张H100跑1280×720、24帧/秒、延迟0.16秒
二手工程/媒体
- IT之家等对Seedance 2.0定价的转述(15秒约30.888万token、约1元1秒),已与官方公式交叉核对
- 彭博关于字节实时空间视频模型的报道:全部信息来自匿名知情人士,字节未确认,本文只作研发目标引用
- Seedance 2.5的70元/42元:仅见媒体对火山引擎公告的转述,未用于正文计算
- Seedance 2.0 Mini约0.5元/秒:第三方按官方单价折算
说明
- 文中所有“文本对视频”的价格对比只比计费口径,不比信息量
- 50token/秒为示例值;3000字分析的token估算沿用峰谷定价文章
- 16倍仅指全局注意力环节的理论变化,不代表整体推理成本