本文属于「算力账本」系列。上一篇算的是峰谷差价,这一篇看同一张价目表上的三条线为什么没有一起动。
9月10日中午12点,DeepSeek Flash系列的新价格生效,媒体标题清一色是“最高降价60%”。
这个数字没有错。缓存命中的闲时价,从每百万Token 5分钱降回2分钱,正好60%。但打开完整价目表,另外两条线降得远没有这么多:缓存未命中输入从1.5元降到1元,降了三分之一;输出从4.5元降到4元,只降了一成出头。而在8月17日之前,输出价是2元。
输入价退回了原点,输出价至今仍是原来的两倍。
如果只是算力整体便宜了,三条线为什么会走出60%、33%和11%三种幅度?如果只是竞争压力,降价的同时为什么还保留峰谷计费?答案不在GPU价格里,而在一次推理的三个阶段里。三条价格线各降各的,等于把一次推理中哪段最贵、哪段最便宜,直接写在了账单上。
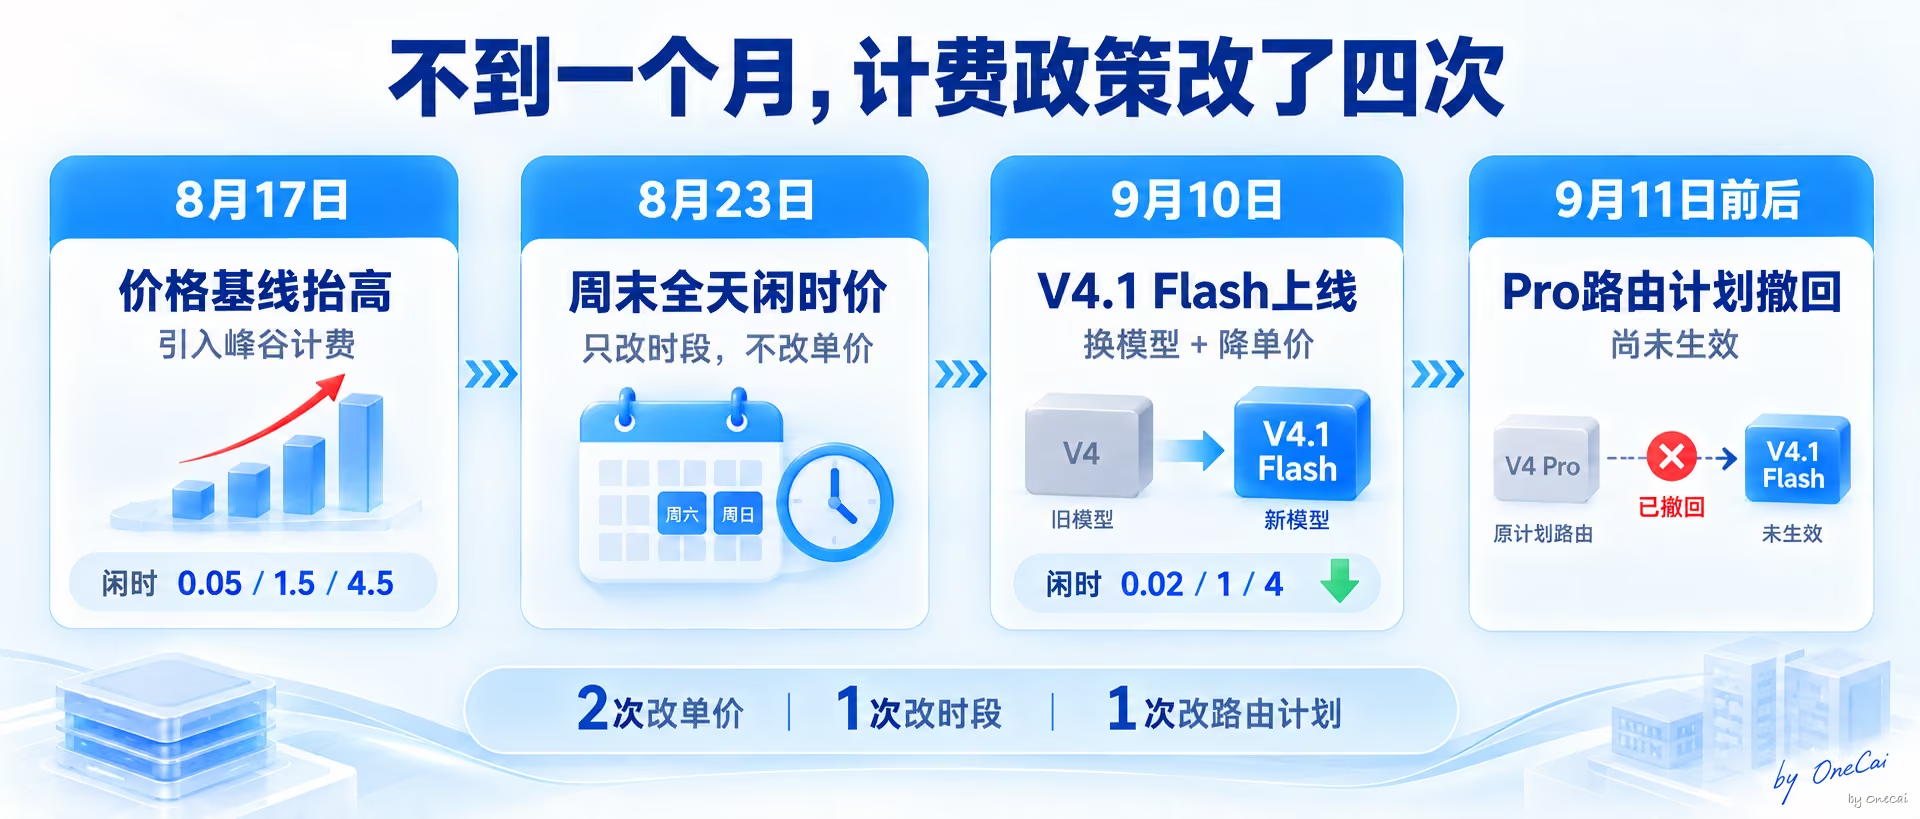
一、不到一个月,计费政策改了四次
先把时间线摆正,这不是“同一个模型两个月内涨了又降”。
| 时间 | 调整内容 | 性质 |
|---|---|---|
| 8月17日 | Flash闲时价调为0.05/1.5/4.5元,高峰翻倍 | 抬高基线,引入峰谷计费 |
| 8月23日 | 周六、周日全天按闲时价 | 只改计费时段,不改单价 |
| 9月10日 | V4.1 Flash发布,闲时价调为0.02/1/4元;V4 Flash下线 | 换模型,同时降单价 |
| 9月11日前后 | 撤回“9月14日起V4 Pro请求路由到Flash”的计划,V4 Pro继续提供,计费不变 | 改路由,没生效就撤了 |
三组数字依次对应缓存命中输入、缓存未命中输入、缓存未命中输出,单位都是元/百万Token。
四次调整里,只有两次动了单价。更关键的是9月10日代码里的模型名可以一个字不改,后面的模型已经换了。V4 Flash和V4 Flash Vision Exp已经下线,deepseek-v4-flash等旧名称只是被临时路由到V4.1 Flash,按Flash价格计费。
第四次调整发生得更快。9月10日的发布稿原本宣布,9月14日12点后deepseek-v4-pro的请求将全部路由到V4.1 Flash并按Flash计费;但截至9月12日,API价格页已经加了一条说明:应用户需求,9月14日后继续提供V4 Pro,计费方式不变。一个路由计划在生效前就被撤回了。
这个插曲本身就是一个提醒:模型路由、服务期限和价格,现在都属于动态配置。接入之后,得继续盯着。
顺带说一句,8月17日那次涨价,官方公告没有解释原因。“算力紧张、要集中资源训新模型”的说法来自官方小助手的回复和媒体转述,属二手口径,本文不把它当结论用。
二、三条价格线,对应推理链上的三笔账
把三个时期的Flash价格放在一起:
| 计费项 | 8月17日前 | 8月17日起(闲时/高峰) | 9月10日起(闲时/高峰) | 闲时降幅 |
|---|---|---|---|---|
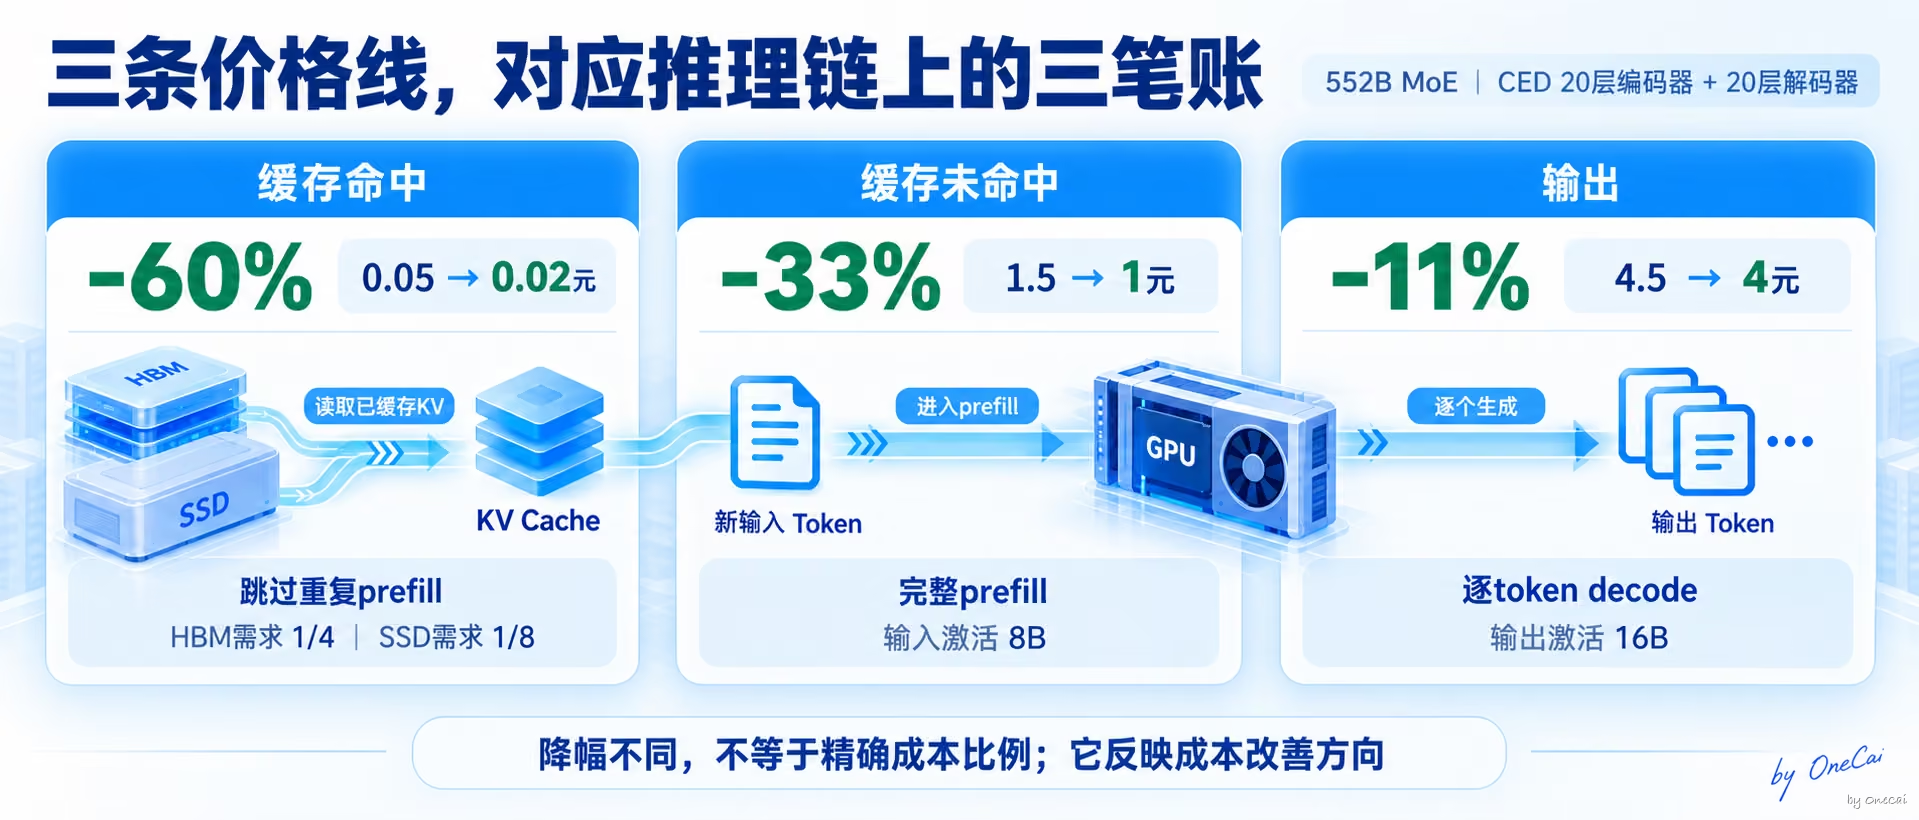
| 缓存命中输入 | 0.02元 | 0.05 / 0.10元 | 0.02 / 0.04元 | 60% |
| 缓存未命中输入 | 1元 | 1.5 / 3元 | 1 / 2元 | 33% |
| 输出 | 2元 | 4.5 / 9元 | 4 / 8元 | 11% |
先说清楚“最高降价60%”的口径:比较的是9月10日前后的闲时缓存命中价。如果拿原来的高峰价0.1元和现在的闲时价0.02元比,能得到80%,但那同时换了计费时段和价格版本,不是同口径。以后看降价新闻,先问一句:跟哪个价比的?
三条线降幅不同,和V4.1 Flash的结构变化正好对得上。
DeepSeek在发布说明里把降价原因说得很直接:新架构能以更低的成本服务更多用户。DeepSeek官方给了四个数字:模型总参数552B,输入激活8B,输出激活16B;KV Cache对HBM的需求降到上一代的1/4,对SSD的需求降到1/8,相对初代模型累计缩小437倍。
这里先插一句本号的老话:参数量不等于算力。上一代V4 Flash总参数284B、每Token激活13B;V4.1 Flash总参数翻了近一倍到552B,激活参数却降到8B(输入)和16B(输出)。模型变大了,跑起来反而更便宜。这四个数字拆开看,正好对应三条价格线。
缓存命中:降60%
命中缓存时,重复的前缀不用重新算,平台主要承担的是把之前存下来的KV Cache从SSD或HBM里读出来、再接着往下算。这段成本的大头是存储,不是计算。
V4.1 Flash变化最大的恰好就是缓存。技术报告的架构叫Causal Encoder-Decoder,40层被拆成20层因果编码器和20层解码器,解码器的全局KV Cache不再由每一层自己算,而是从编码器最后一层的隐状态投影出来;再配合一个叫SWA Bounded Replay的设计,滑动窗口注意力的缓存不再持久化到SSD,只在需要时回放最近的窗口重建。两件事叠起来,需要长期保存的KV Cache缩到了上一代的大约1/8。
缓存体积缩得最狠,缓存命中价降得最多,方向一致。发布说明还专门提到,Agent场景中缓存命中的费用往往占比较高——这条线是明着降给Agent用户的。
不过有一个边界要划清:这个方向有官方材料支撑,但不能把资源比例直接换算成利润表。DeepSeek没有公布每百万Token的真实运营成本,HBM降到1/4,不等于缓存价格必须降到1/4。
缓存未命中:降33%
没命中,输入就要完整过一遍prefill。V4.1的输入激活从13B降到8B,而且在这个结构里,提示词Token只需要走完编码器那20层,不必再过解码器,prefill的计算量大致砍了一半。但这段计算是跳不掉的——省得少,降得也少。
输出:只降11%
输出进入decode阶段,模型逐个生成Token,每生成一个都要再读一遍参数和已有缓存。V4.1在这一阶段激活16B参数,是输入阶段的两倍。“非对称”这三个字的设计意图,就是把算力省在输入端、留给输出端。
输出价从4.5元降到4元,只回撤了一小步。和8月17日前相比,闲时输出价仍是两倍,高峰价是四倍。这说明decode仍然是整条推理链上最难压的一段。
哪条价格线降得最多,就说明哪部分成本改善得最明显。三条线不是一份精确的内部成本表,但比“最高降价60%”更接近你最终要付的钱。
三、模型价格的三个开关
之前在本号中峰谷定价的文章说过,AI价格正在从一个固定数字变成一套调度规则。这次三条线的差异化变化,可以把这套规则拆成三个开关。
开关一:一次请求吃掉多少资源
prefill计算、KV Cache占用的HBM和SSD、decode持续的时间、并发时的调度效率,都会进入服务成本,而模型架构直接决定这些量。V4.1的四个官方数字描述的就是这一层。从目前的一手资料看,新架构是这次降价最有力的直接解释。
开关二:算力在什么时间被占用
峰谷价解决的是集群利用率问题。工作日白天接近满载时,多一个请求可能意味着排队或扩容;夜间和周末有空闲容量时,多处理一批任务的新增成本很低。GPU的买入价没变,利用率变了,平台愿意接受的价格就会变。
8月23日把周末全天划成闲时,就是对着真实负载曲线在调规则——周末请求少,没必要用高峰价把人赶走。而这次降价之后,峰谷机制被保留了下来,工作日9:00至12:00、14:00至18:00仍按高峰价计费。这本身是一个信号:吞吐压力没有因为换了模型就消失。
开关三:平台想让流量去哪里
Flash承接高频、规模化、价格敏感的请求,Pro面向复杂任务。价格除了回收成本,还在决定用户把流量送到哪个模型。
这次只动Flash,Pro的价格没改;旧Flash下线但保留调用别名,是一次平滑迁移;原计划把Pro请求也导向Flash,随后又撤回。动作串起来看,产品分流的方向很清楚——把绝大多数调用推到新Flash上——但分流的节奏还在调整。
竞争压力也放在这个开关里。8月涨价之后,有第三方比价认为在普通短上下文场景下,Flash已经不是最便宜的选择,这可能影响了DeepSeek愿意把多少成本下降让出来。但官方没有把这次降价归因于竞品,竞争只能作为市场背景。
四、谁是这次的主开关
把候选原因和证据放在一张表里:
| 候选原因 | 能解释什么 | 解释不了什么 | 证据强度 |
|---|---|---|---|
| V4.1架构效率提升 | 三条线降幅不同 | 峰谷规则为何保留 | 强,官方明确说明 |
| 高峰吞吐压力 | 峰谷保留、周末豁免、输出不退 | 三条线的差异化降幅 | 中强,规则可观察,利用率未公开 |
| 新旧模型迁移 | 旧模型下线、别名路由、Pro路由计划 | 具体降价幅度 | 中强,官方可核实 |
| 竞品价格压力 | Flash的市场定位 | 无官方因果说明 | 中弱,市场推断 |
| GPU采购或租赁成本下降 | 整体成本 | 三条线降幅不同 | 弱,无直接证据 |
我的判断是:这次调价最直接的开关,是新架构带来的单位服务成本下降,尤其是KV Cache的压缩;峰谷价被保留,说明吞吐问题还在;竞争决定DeepSeek愿意让出多少,但现有公开资料不足以给它定权重。
一句话概括:
成本决定能不能降,吞吐决定哪个时段不能降,产品定位决定降给哪个模型、哪类Token。
五、下一个该退的,是输出价
前面拆DSpark那篇讲过,推测解码是专门用来提升decode吞吐的技术,V4 Flash 0731也带着DSpark模块。这次输入价已经明显回落,输出价只退了一小步,正好给了一个可以持续观察的指标:
Flash的闲时输出价什么时候回到2元,就是decode那一段成本真正松了的信号。
但这个信号不能替代吞吐测试。输出价格还会受竞争、产品分层和高峰利用率影响,不能因为单价降了,就反推decode性能一定提高了多少。
六、你的账单到底能降多少
公式很简单:
| |
跨了峰谷时段,就分两段各算一遍。下面三个场景全部按闲时价计算,单位是元。
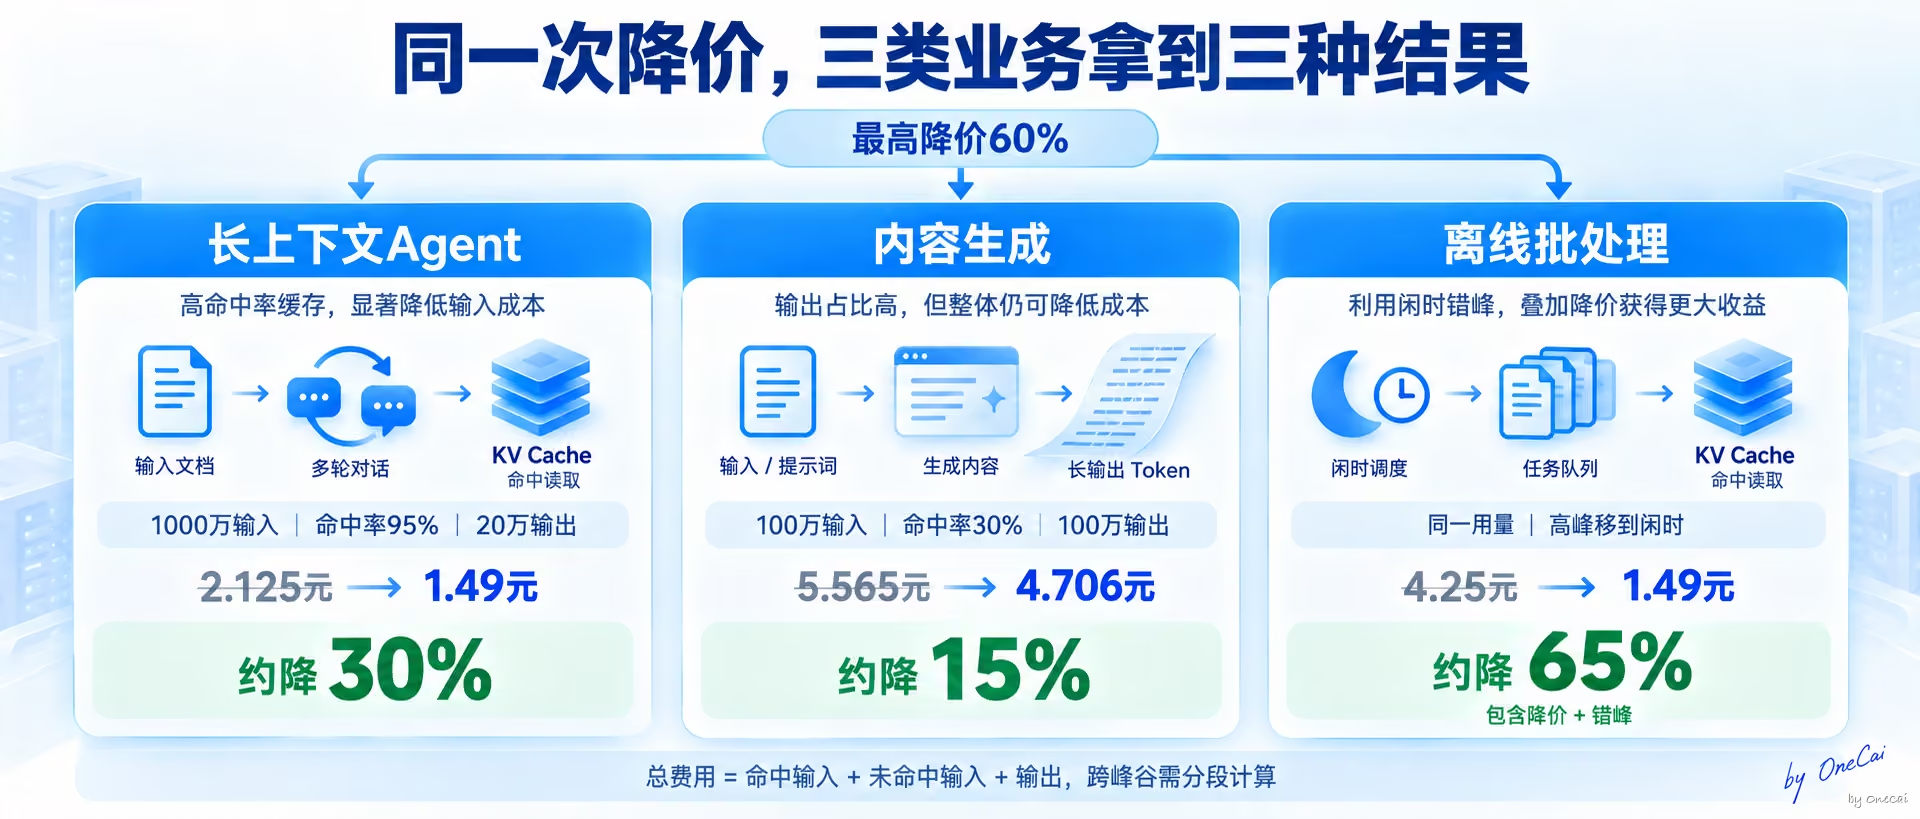
场景一:长上下文Agent,降约30%
假设每天1000万Token输入,命中率95%,输出20万Token。
| |
命中率已经95%,实际降幅仍远低于60%——因为账单里的大头从来不是命中的那部分,而是没命中的和输出的。
场景二:内容生成,降约15%
假设100万Token输入,命中率30%,输出100万Token。
| |
输出越多,整体降幅越接近输出价那条11%的线。
场景三:离线批处理,降约65%
沿用场景一的用量,但之前跑在工作日高峰,现在挪到夜里或周末:
| |
这是唯一能超过60%的情况——降价和错峰叠在一起。这里比的已经不只是单价,还包含从高峰切到闲时的折扣。
一份真实Token结构,重算三版价格
再贴一份实测。我有一个每天定时跑的A股分析Agent,用DeepSeek Flash做分析。之前写缓存计费那篇时,贴过6月14日的后台拆解:命中1667万Token,未命中45万,输出10.9万,当天花了约1元。
下面把同一组用量分别套入三个时期的闲时价,只为隔离单价变化的影响,不冒充9月10日前后的两张实付账单:
| |
8月那轮涨价会让同样的调用结构从1元变成2元,这次回落到1.22——比涨价前多出的那0.22元,几乎全部来自输出。97%的命中率,也不等于整张账单能降60%。命中率、输入输出比例和请求时段,必须放在一起算。
七、开发者现在该做的四件事
一,单独维护一张带生效日期的价格表。一个月改四次的东西,不要写死在代码或年度预算里;历史账单也要按调用发生时的价格算。
二,日志里把三类Token分开记。只有一个总Token数,既还原不了费用,也看不出优化该落在哪一段。
三,可延迟任务排到闲时和周末。场景三已经算过了,这是唯一能拿到60%以上降幅的办法,而且不改模型能力。
四,比较任务总成本,不只比每百万Token报价。任务成功率、输出长度、响应时间、失败重试次数、缓存命中率,哪一项都可能把单价差抹平。
最后补一条容易被忽略的风险:模型名还能调,不代表后面还是那个模型。旧Flash模型名已经指向V4.1 Flash,Pro的路由计划宣布了又撤。对结果稳定性有要求的业务,需要记录实际模型版本,路由或模型更新后重跑一遍回归测试。
写在最后
不到一个月四次计费调整,把大模型API定价背后的几笔账摊开了。
新架构改变一次请求需要多少计算和缓存,峰谷规则改变请求在什么时间进入集群,产品定位决定流量被送到哪个模型。GPU价格只是成本背景之一,解释不了缓存命中降60%、未命中降33%、输出只降11%这组不对称的变化。
上一篇说价格表正在变成一套调度规则。这一篇可以再加一句:它也正在变成一块仪表盘,指针指向的是后台那些你看不见的HBM、SSD和GPU时间。
下一次价格变化发生时,可以先看究竟动了哪条线。没有跟着一起变的那条,往往更有信息量。
顺便预告一下,V4.1 Flash那个“输入激活8B、输出激活16B”的非对称结构,够单独拆一篇「术语解构」。
如果这篇对你有帮助,点个「在看」,把公众号设为星标,或者在评论区聊聊你的账单在9月10日前后变了多少。
资料边界说明
文中价格与产品状态核对于2026年9月12日,发稿前请再次核对DeepSeek API价格页。按来源可信度分层如下:
一手来源(官方)
- DeepSeek官网《DeepSeek V4.1 Flash:更强、更快、更普惠》,2026年9月10日:deepseek.com/news/deepseek-v4-1-flash/
- DeepSeek API价格页(含V4 Pro继续提供的说明):api-docs.deepseek.com/zh-cn/quick_start/pricing
- DeepSeek开放平台公告:8月17日调价、8月23日周末规则、9月10日调价
- DeepSeek-V4.1-Flash模型卡与技术报告:huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash
- DeepSeek-V4-Flash模型卡(284B/13B、DSpark模块):huggingface.co/deepseek-ai/DeepSeek-V4-Flash
实现方与工程博客
- vLLM Recipes对DeepSeek-V4-Flash和DSpark的说明:recipes.vllm.ai
第三方媒体
- 观察者网,2026年8月17日,DeepSeek涨价报道两篇
- 新浪科技,2026年9月9日,《DeepSeek官宣flash系列模型降价 最高直降60%》
- MarkTechPost,2026年9月10日,V4.1 Flash架构解读(“prefill计算量大致减半”出自此处)
二手口径与社区(不作为结论依据)
- 8月17日涨价原因“算力紧张、集中研发新模型”:官方小助手回复经媒体转述
- 涨价后的竞品比价:devtk.ai第三方分析
- 用户讨论:知乎、B站、LINUX DO
本账号已发文章
- 《同一个问题,上午9点问比凌晨贵一倍:DeepSeek峰谷定价的算力账》
- 提示词缓存计费篇,《同一份材料,为什么第二次交给AI只收1/10?缓存计费拆解》
- KV Cache篇,《KV Cache:每读1个token,就要交一笔“显存税”》
- DSpark推测解码篇 ,《DeepSeek新出的DSpark,不是让模型更聪明,而是让它说话更快》