这一篇是***「算力账本」系列***文章。
2026年9月10日,OpenAI把GPT-Live-1放进了API,定价是每分钟0.05美元。按这个数字算,一通5分钟的客服电话,语音层只收0.25美元。
很多人看到这里,已经开始拿它和人工客服的工资比了。
对于付费用户来说,这0.25美元买到的不是一名完整的AI客服。它买到的是一个实时听、实时说、能处理插话和停顿的语音前台。查订单、判规则、联网搜索、翻知识库、处理复杂投诉,这些活它可以委托给后端模型和工具去做——而后端模型和工具,是另外几张账单。
同一通5分钟电话,后端接最便宜的Luna模型,和接最贵的Astra模型,总价相差接近一倍。0.05美元到底是大头还是零头,价目表本身给不出答案。
这篇就从这通电话开始,一层一层算。
一、0.05美元买到的是语音前台
先说清楚GPT-Live-1和过去的语音客服有什么不一样。
传统的语音Agent,是三段服务串起来的:
| |
用户说一句,先转成文字,喂给模型,模型吐出文字,再合成语音播出去。每一次交接都会增加延迟,也可能带来状态丢失和链路失败。用户中途插一句话,三段链要决定是打断、忽略还是重来,这部分逻辑全靠开发者自己写。
GPT-Live-1把“听”和“说”放进了同一个模型里,术语叫全双工:它一边说话一边还在听,用户插话、停顿、附和一声“嗯”,它都能当场处理,不用等一轮结束。OpenAI发布稿里引了一个客户案例:换成GPT-Live-1之后,代码库缩减了80%,删掉了2.3万行代码——删掉的就是那些“用户打断了怎么办”的胶水逻辑。
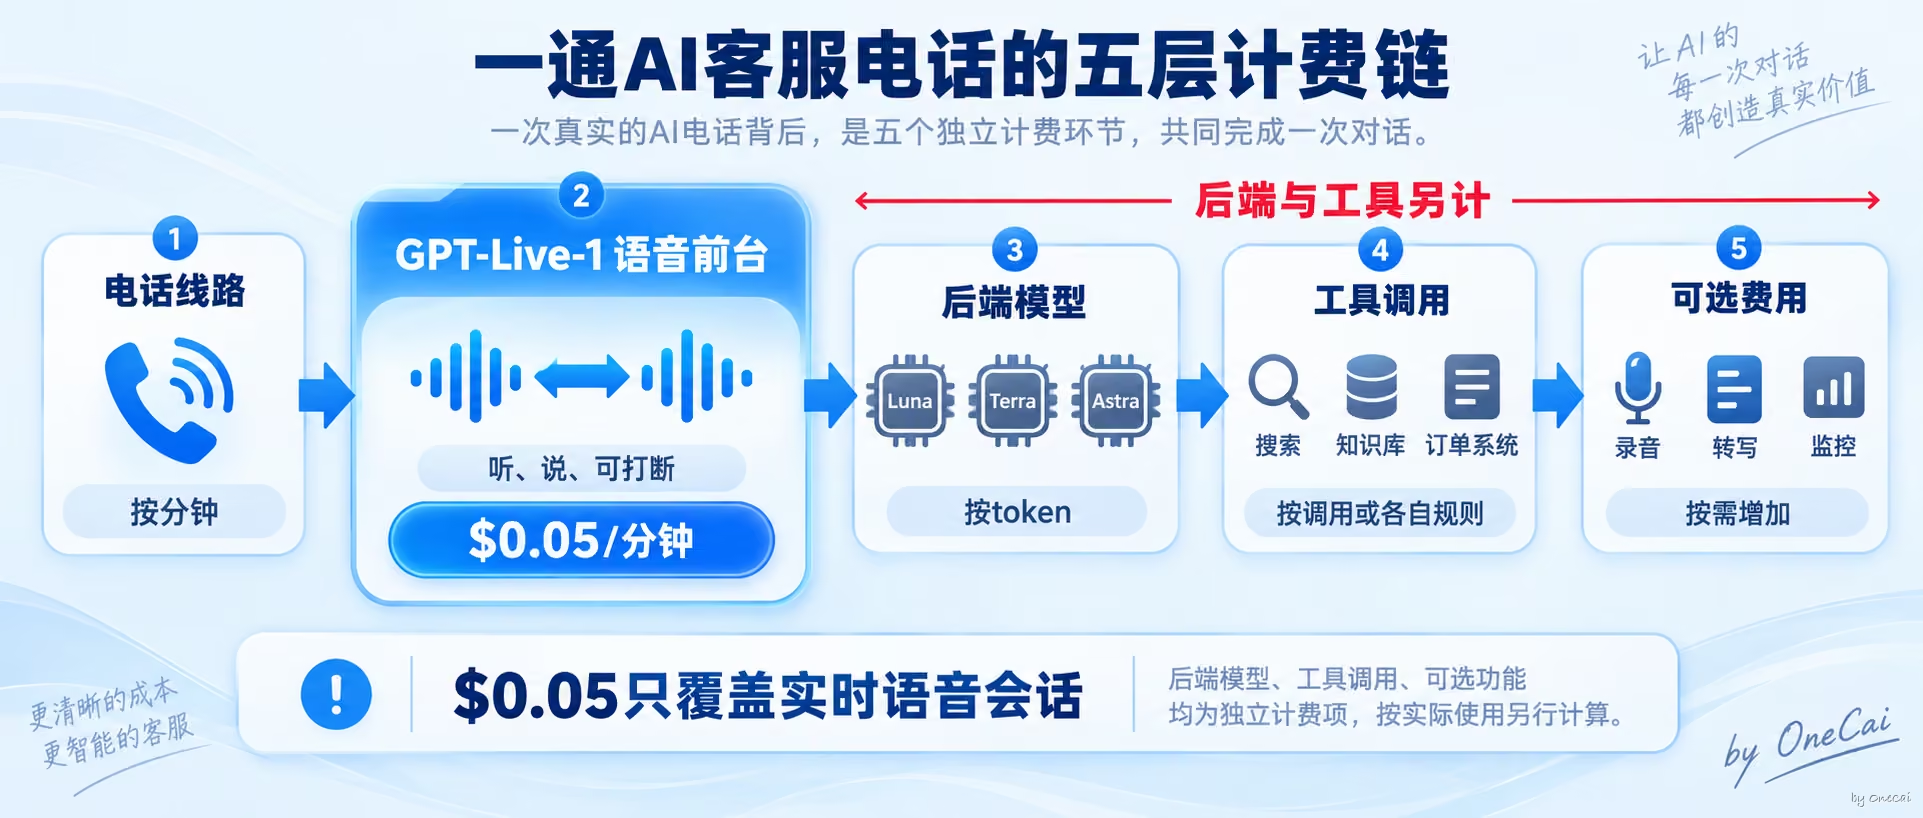
但全双工模型不负责把所有事都想明白。官方的设计是,它可以把更深的推理和工具调用委托给后端的文本模型,比如GPT-6 Astra,或者第三方模型。发布稿给出的建议是高频简单任务(订单更新、预约)配Luna,复杂问题配Astra。
于是新的调用链变成了这样:
| |
对应这条链,OpenAI定价页上关于GPT-Live-1只有一行:每分钟0.05美元,按秒结算、不向上取整;后端模型和工具用量另计。换算一下,5分钟是0.25美元,1000小时通话是3000美元——而这3000美元花出去的时候,后端模型还没读过一个token。
需要注意到的一点是,GPT-Live-1原生提供语音识别转写和回复文本,这一点后面算账时会用到。
所以这次变化,不只是语音模型换了一代。OpenAI同时重新划分了账单的边界:实时交互按在线时长收费,复杂工作回到后端模型和工具的账单里。你付的是“在线时间”,不是“回答问题”。
二、一通5分钟电话,会出现哪些费用
从电话接通到问题处理完,除了那0.25美元,还有哪些钱?先给公式:
| |
为了让后面几张表能互相比较,全文用同一通电话做示意,假设固定如下:
- 通话5分钟,10轮对话;
- 后端模型累计输入1.5万token(已经包含系统提示词、对话历史和工具返回的内容),累计输出2000token;
- 调用1次网页搜索、2次文件搜索;
- 电话线路按Twilio美国本地号码入站计;
- 后端分别接Luna、Terra、Astra,都按标准短上下文价格算;
- 不计税费、汇率、企业折扣、第三方业务接口费和人工接管。
这是我设定的示意场景,不是OpenAI的官方案例,也不是谁的实测账单。
第一层:语音会话费
| |
这是整张账单里最确定的一笔。计费公式不直接看用户问了什么,也不看后端消耗了多少token;如果等待后端处理使会话保持得更久,语音层的计费时长仍会增加。
第二层:后端模型费
三档后端模型的标准价(每百万token):
| 模型 | 输入 | 缓存输入 | 输出 |
|---|---|---|---|
| Luna | $0.20 | $0.02 | $1.20 |
| Terra | $2.00 | $0.20 | $12.00 |
| Astra | $10.00 | $1.00 | $50.00 |
这里有个容易算错的地方:10轮对话不是只付一次1.5万token。每一轮委托,后端都要重新读一遍系统提示词和之前的对话,所以本文假设的1.5万,指的是10轮累积下来的计费输入总量。
第三层:工具费
网页搜索每千次10美元,文件搜索每千次2.50美元。本例1次网页搜索加2次文件搜索,固定调用费合计0.015美元。
但工具费可不止这一笔。定价页脚注写得清楚:网页搜索返回的内容会进入模型上下文,按所选模型的输入价另外收费。在本文这组调用假设下,这笔钱在Luna方案里占比较小,配Astra时却可能超过0.01美元的固定调用费。本文已经把这部分算进1.5万输入token里,不再重复相加。
另外两点提醒:文件搜索还有存储费(每GB每天0.10美元,1GB免费);至于查订单、查物流、改地址这些第三方业务接口收不收费,要看各家产品,不能统一算成OpenAI的工具费。
第四层:电话线路
以Twilio美国本地号码入站为例:
| |
号码另有月租1.15美元。不同国家、号码类型、呼入呼出方向和企业协议价差异很大,这个数字只是一个可以复核的线路示例,不代表国内的电话成本。
第五层:录音、转写和监控(可选项)
这几项不进基础账单,单独列出来:
- 录音:0.0025美元/分钟;
- 录音存储:0.0005美元/分钟/月;
- Twilio通话转写:0.05美元/分钟;
- Voice Insights高级监控:0.0024美元/分钟。
两个顺手的对照值得记一下。第一,5分钟Twilio转写要0.25美元,和GPT-Live-1语音层同价——一个只把话转成字,一个能听能说能被打断。第二,Twilio自家的语音AI编排层Conversation Relay定价是0.07美元/分钟,比GPT-Live-1的语音层还贵四成。不过两者覆盖的产品边界不同,不能据此说谁更便宜——它只能说明一件事:语音AI市场上的“每分钟价格”,经常包含着不同的技术层。
还有一点:GPT-Live-1已经原生提供转写,所以Twilio转写不应该出现在所有方案的基础成本里。只有企业为了录音归档、合规审查或者另一套分析流程要再转一遍时,才会产生这笔重复费用。
三、同一通电话,接三个后端会算出三张账单
把前四层加起来,同一通5分钟电话,后端接三个不同模型:
| 费用 | Luna | Terra | Astra |
|---|---|---|---|
| GPT-Live-1语音层 | $0.2500 | $0.2500 | $0.2500 |
| 后端输入 | $0.0030 | $0.0300 | $0.1500 |
| 后端输出 | $0.0024 | $0.0240 | $0.1000 |
| 工具固定调用费 | $0.0150 | $0.0150 | $0.0150 |
| 电话线路 | $0.0425 | $0.0425 | $0.0425 |
| 合计 | $0.3129 | $0.3615 | $0.5575 |
| 语音层占比 | 约80% | 约69% | 约45% |
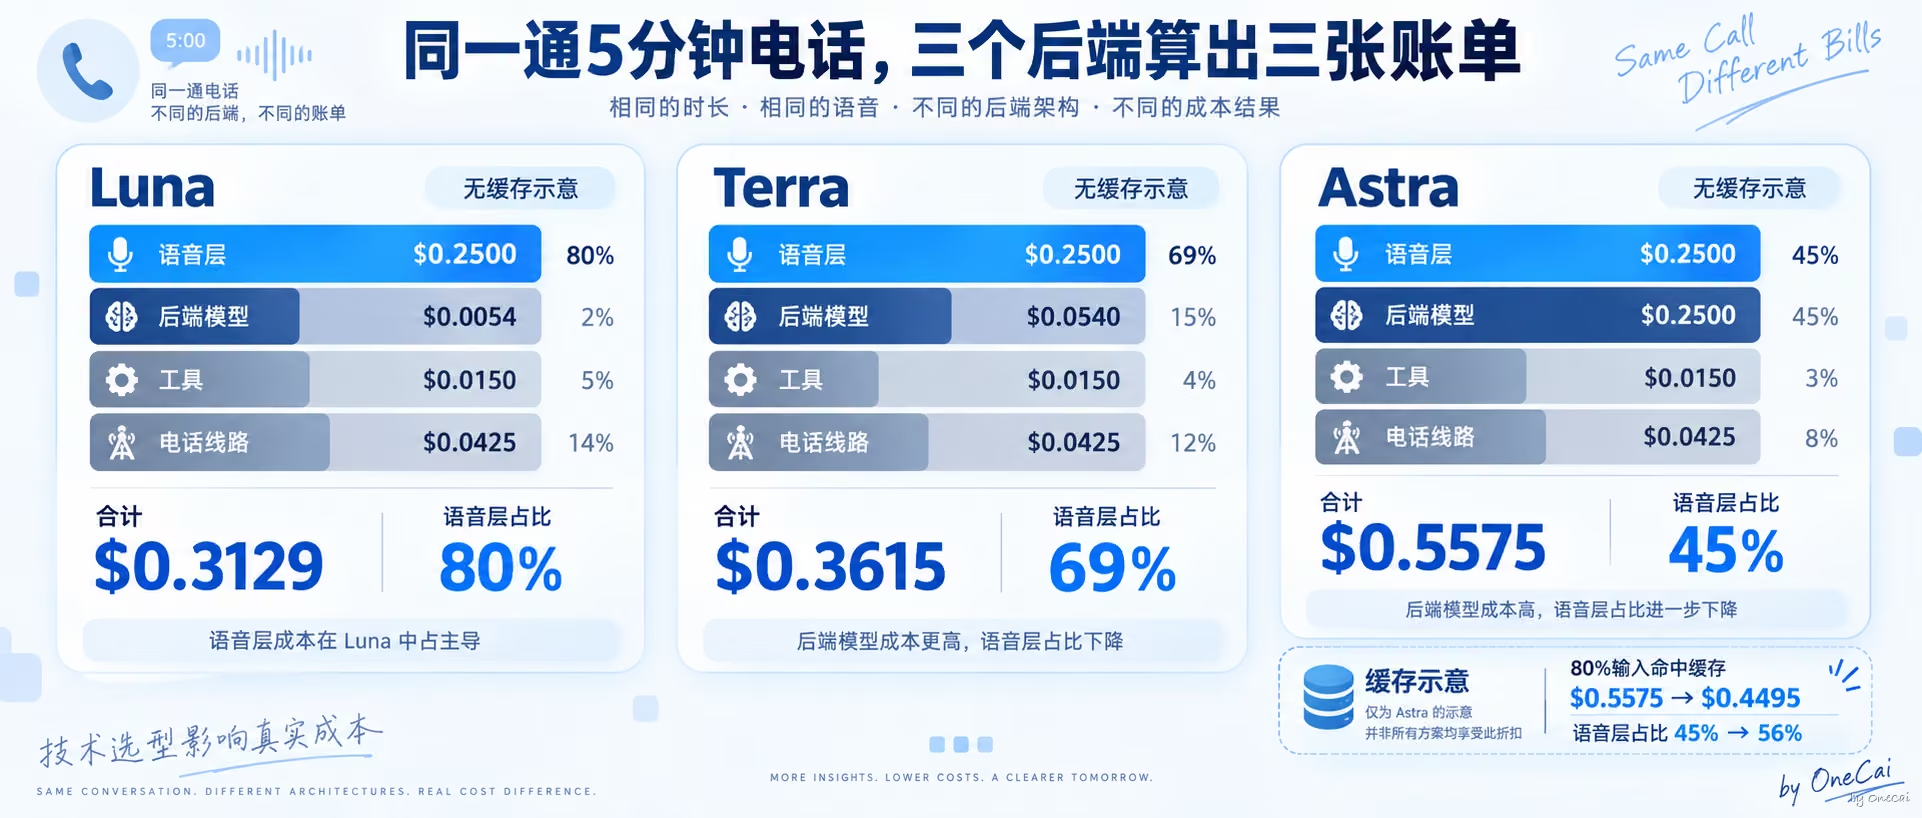
通过上表可以看出下面三点:
Luna方案里,语音层是绝对的大头。简单的订单查询,后端只要少量推理,模型输入和输出合计0.0054美元,约0.54美分,语音层占了八成。这种场景下如果有人跟你说“0.05美元只是入场费”,那是在夸大后端的成本。
Astra方案里,后端才追平语音层。输入0.15加输出0.10,后端刚好也是0.25美元,和语音层打平;再加上工具和线路,语音层占比降到45%。而且别忘了,OpenAI公布的Tau3语音Agent跑分第一名,是GPT-Live-1配Astra中等推理强度跑出来的——你为那个跑分买单的时候,买的就是右边这一列。
模型选择不能只看单价。便宜模型如果频繁理解错、反复调工具、最后还是转了人工,总成本未必更低。这里先只算API账单,任务成功率的问题放到第七节。
所以同一份语音价目表背后,可以跑着三个成本完全不同的客服。语音层是不是大头,取决于后端把每个问题交给了谁。
四、加上缓存,账单会变成什么样
第三节的表还漏了一个变量:缓存。
语音客服的每一轮委托,后端都要重读系统提示词、客服规则、产品说明和工具定义,这些内容在10轮对话里可能一个字都不变。第63篇讲提示词缓存计费的文章里提过一个重要原则:稳的放前面、变的放后面。语音客服很适合这样组织上下文,但真正拿到缓存折扣,还要满足可复用前缀、缓存断点、缓存键和有效期等条件。
三档模型的缓存输入价都是标准价的十分之一:Luna 0.02、Terra 0.20、Astra 1.00美元每百万token。假设1.5万输入里有80%命中缓存,也就是1.2万缓存输入、3000未缓存输入,输出仍是2000token。以Astra为例:
| |
三档一起重算:
| Luna | Terra | Astra | |
|---|---|---|---|
| 后端模型费 | $0.0032 | $0.0324 | $0.1420 |
| 整通电话 | $0.3107 | $0.3399 | $0.4495 |
| 语音层占比 | 约80% | 约74% | 约56% |
Astra方案的后端费从0.25美元压到0.142美元,整通电话从0.5575降到0.4495,语音层占比从45%回到56%。也就是说,即使配最贵的Astra,只要缓存做对了,语音层仍然是账单里最大的单项。
要吃到这个折扣,上下文的组织顺序大致是:
| |
前两块每通电话都一样,放最前面;用户是谁、这轮说了什么、刚查回来的订单状态,放后面。动态内容出现得越早,可复用的公共前缀通常越短,缓存收益也越低。
几条口径上的限制要说明。56%是这个示意场景的结果,不是GPT-Live-1的固定比例。表格描述的是重复调用进入稳定状态后的单通成本,没有算首次写入缓存的钱。Astra的缓存写入价是每百万token 12.50美元,1.2万token首次写入要0.15美元,比按标准价直接读一遍的0.12美元还贵。这段稳定前缀如果只用一次,缓存反而不划算。假设100通电话在缓存有效期内共享相同的可缓存前缀和缓存配置,首次写入费摊到每通才会降到0.0015美元。
缓存不会减少0.05美元的语音时长费,也不会降低输出token的价格。为了命中缓存硬往前缀里塞无关内容,只会增加费用,还可能影响回答质量。
语音层的价格由OpenAI定,后端选型和上下文怎么组织由开发者定,而后两项足以改变语音层在整张账单里的占比。后端账单可以通过模型路由和缓存压缩;语音层按连接时长计费,要降低这部分费用,就得缩短会话保持的时间。
五、GPT-Live-1和上一代不能只比单价
GPT-Live-1最容易被拿来比较的,是现有的GPT-Realtime-2.1。很自然的问题是:新的比旧的便宜吗?
先把官方价格列出来:
| 模型 | 音频输入 | 缓存音频 | 音频输出 | 文本输入 | 缓存文本 | 文本输出 |
|---|---|---|---|---|---|---|
| GPT-Realtime-2.1 | $32/M | $0.40/M | $64/M | $4/M | $0.40/M | $24/M |
| GPT-Realtime-2.1 mini | $10/M | $0.30/M | $20/M | $0.60/M | $0.06/M | $2.40/M |
| GPT-Live-1 | 按会话时长$0.05/分钟,后端另计 |
Realtime-2.1是“处理了多少、生成了多少,就付多少”,音频token和文本token都按同一个实时模型的价格表结算;GPT-Live-1是语音会话按在线时长计费,再叠加后端模型和工具费用。两行价格不在一个坐标系里,差异至少有四层:
- 计费单位不同:音频token和会话秒数之间没有官方公布的稳定换算;
- 费用边界不同:Realtime-2.1的音频和文本处理采用同一套模型计价表,GPT-Live-1则把实时语音层与后端Responses模型明确拆开;外部工具是否收费,仍取决于具体工具;
- 能力不同:GPT-Live-1支持全双工,但目前不支持图像和视频输入,而Realtime-2.1支持图像;
- 会话结构不同:只要GPT-Live会话仍保持连接,用户停顿、等待工具和后台任务运行的时间都会延长按时长计费的部分;按token计费的方案主要看实际输入输出量。
看价格变化的方法,和拆DeepSeek峰谷定价那篇用的一样:先别急着比数字,先问三件事——模型变没变、计费单位变没变、费用有没有被搬到另一层。这次三个答案都是“变了”。
所以有几个结论是不能写的:不能凭0.05美元判断GPT-Live-1更便宜;不能把Realtime-2.1的音频token价换算成一个确定的每分钟价,除非官方给出可验证的换算口径;不能把Full Duplex Bench提升30个百分点说成成本下降30%。
这不是同一个公式里的普通降价,而是费用重新分层。开发者拿到了更多后端选择,也要自己承担选型和成本控制。
最后留一个问题:按秒计费意味着用户沉默、犹豫、后台跑工具的时候,秒表都在走。这段时间由谁买单?这是下一篇要拆的事。
六、国内同行怎么计费:按token,但给了换算尺子
看完OpenAI,再看国内。全双工语音模型国内也有,路线相同,计费方式却走了另一条路。
字节的豆包实时语音模型3.0(Seeduplex)今年6月18日在火山引擎开放邀测,官方描述是“边听边说边办事”,能在对话中直接调用工具——技术路线和GPT-Live-1一样是全双工。阿里的Qwen3.5-Omni-Realtime系列已经在百炼上线,支持函数调用和联网搜索。
计费上,国内两家都没有走“按分钟”,而是按token:音频输入一个价,音频输出一个价,文本输入另算。以百炼定价页(2026年9月核对)为例:
| 模型 | 音频输入 | 文本输入 | 输出(文本+音频) |
|---|---|---|---|
| qwen3.5-omni-plus-realtime | 80元/M | 10元/M | 300元/M |
| qwen3.5-omni-flash-realtime | 27元/M | 3.3元/M | 107元/M |
单看这张表,和OpenAI上一代Realtime-2.1一样,没法直接和“每分钟0.05美元”比。但百炼定价页多给了一条规则,是OpenAI从来没给过的:每一秒钟的音频对应25个token。
有了这把尺子,就能把token价折成每分钟价:1分钟音频等于1500个token。还是那通5分钟电话,假设用户说了2.5分钟、AI说了2.5分钟,各3750个音频token:
| |
GPT-Live-1的语音层5分钟是0.25美元,按发稿日汇率折合约1.8元。三个数放在一起:Qwen plus约1.43元,GPT-Live-1语音层约1.8元,Qwen flash约0.50元。看上去国内更便宜——但这里有一个比价格更重要的差别:Qwen Omni-Realtime是端到端模型,听、想、说在同一个模型里完成,这1.43元已经包含推理;GPT-Live-1的1.8元只买了听和说,想是另外付的。要公平比较,GPT-Live-1那边得加上后端:配Luna是第三节表里的0.3129美元(约2.3元),配Astra是0.5575美元(约4.0元)。
所以两条路线的真实差别不在单价,而在账单结构:
- 国内的端到端路线:一张账单,按说了多少算。用户沉默时如果客户端不推流,理论上不产生音频token;但每一轮的对话历史是否重复计费、缓存怎么算,各家规则不同,要看具体文档;
- OpenAI的分层路线:两张账单,语音层按在线时长算,思考按token算。沉默也计费,但后端可以换、可以缓存、可以按问题难度路由。
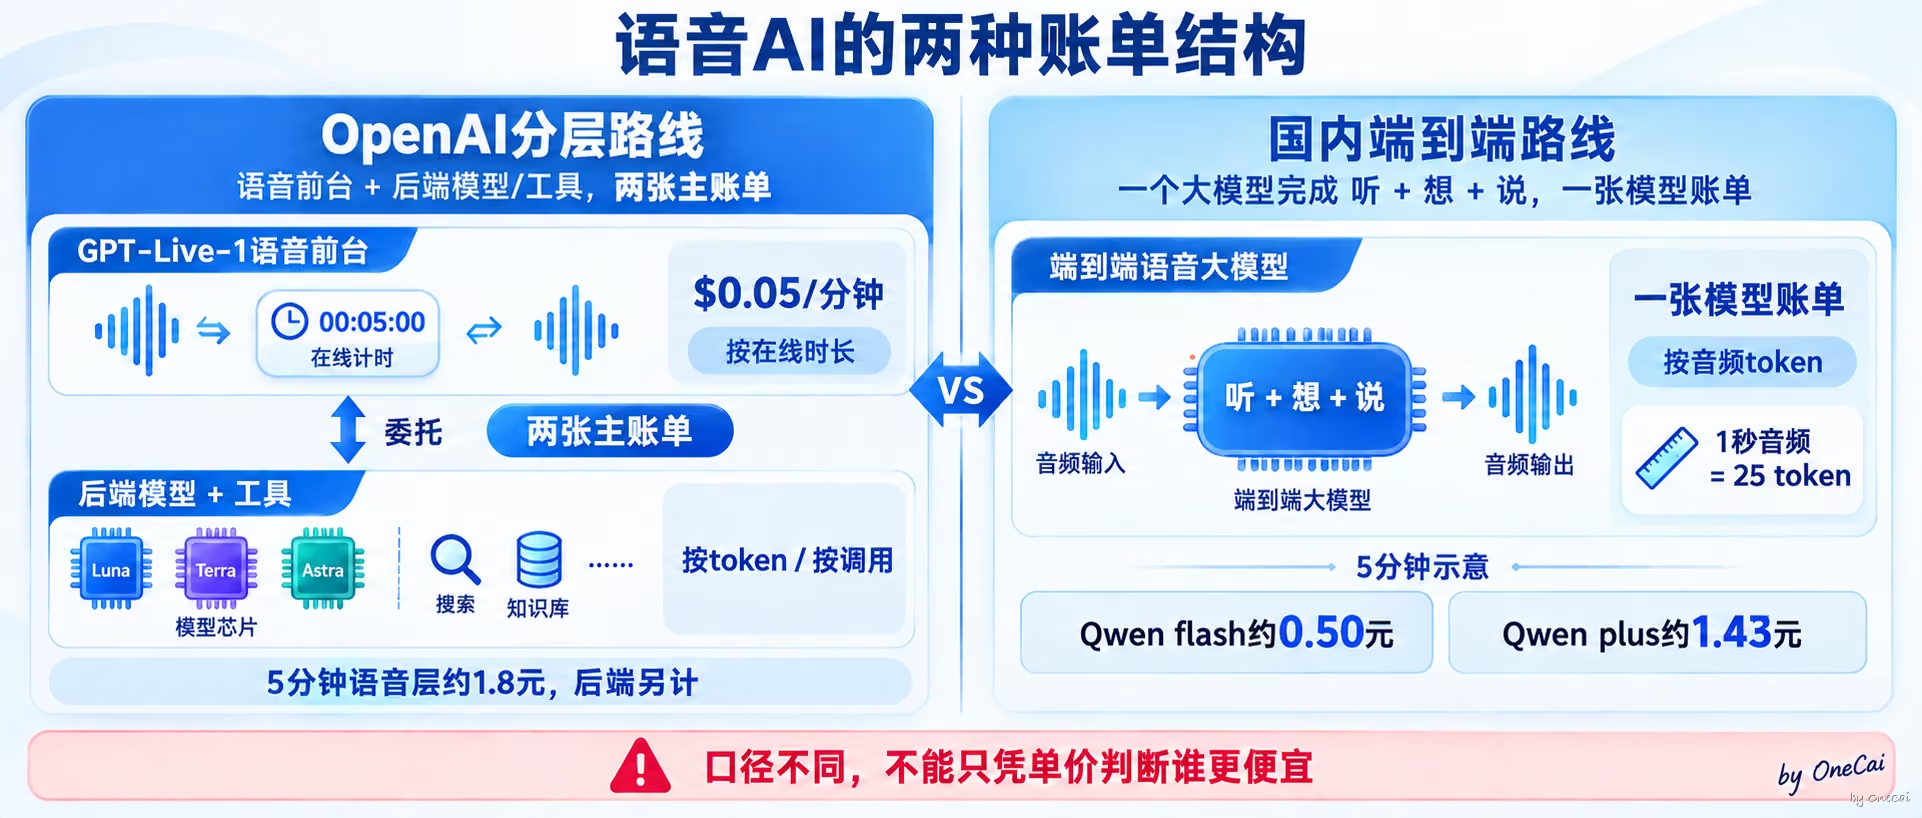
这也解释了为什么两边的“计费单位”不一样。端到端模型的成本随语音量走,按token合理;全双工前台+后端委托的架构,前台是一个始终在线的连接,成本随时间走,按分钟更贴近厂商自己的成本曲线。
顺带一提,国内呼叫中心行业本身就有四种计费口径并存:按坐席、按并发、按分钟、按线路。AI语音进来之后,等于在这四种之外又加了一种“按token”。企业采购时拿到的报价单,很可能是几种口径混在一起的——这一点比OpenAI和国内谁便宜更值得注意。
几条边界要说明。百炼的价格是华北2(北京)地域原价,不含活动折扣和上下文缓存;豆包实时语音模型的价格在火山方舟定价页上,本文没有核到稳定口径,所以只写产品路线不写数字;“用户说2.5分钟、AI说2.5分钟”是示意假设,真实通话里两边的时长比例、以及对话历史是否按轮重复计费,都会改变结果。
七、企业真正该算的是每次成功解决成本
前面六节算的都是API账单。但对企业来说,API最便宜的方案,不一定是最终成本最低的方案。
真正该比较的不是“AI每分钟成本对人工每分钟工资”,而是:
| |
同一通电话有三种结局。一次解决:5分钟内完成查询或操作,没有人工介入,成本就是第三节那张表。转人工解决:AI聊了4分钟没解决,人工再接手6分钟——AI的语音层、线路、后端全部照付,再加人工那6分钟。没解决:第一通结束后用户再次来电,语音层、线路和后端从头再付一遍。
第二和第三种结局下,AI仍可能完成身份核验、信息采集或问题分类,但企业账本里会同时出现AI前置费用和后续人工费用。单看AI调用单价,很容易把这部分重复成本漏掉。
这里有两个经常被混用的指标。一个是自助处理率:多少咨询由AI全程处理,没有转入人工队列。另一个是解决率:多少问题真的处理完了。OpenAI介绍客服平台Ada的案例页里有一组很典型的数据:旧系统自助处理率约70%,解决率只有30%。七成对话没有转人工,但其中不少问题也没有解决;换成新一代系统后,自助处理率相近,解决率提高到60%左右,表现较好的客户超过80%。这是一个文字客服案例,数字不能直接搬到语音上,但它说明了一个关键区别:自助处理率能解释节省了多少人工量,解决率才决定这笔费用有没有换来结果。
之前写Klarna的那篇提到过这家公司采用AI客服的情况。Klarna公布的早期数据是,AI助手处理了约三分之二的客服聊天,重复咨询下降25%。前一个数字不能直接反推出其余对话全部转给人工,后一个数字则与上面公式里的重复来电成本直接相关。这仍是文字客服数据和厂商口径,只能用来解释指标,不能当成语音客服的效果预测。
这里我不虚构人工客服的工资和行业平均解决率,公式给出来,每家企业填自己的数。
全双工的价值也在这个公式里体现。OpenAI发布稿引了Speak的早期评估:GPT-Live-1让学习者思考时被打断的次数减少了近80%。如果一次解决率因此提高,即使每分钟略贵,每次成功解决的成本也可能更低。但要说明,这些是厂商发布稿里的客户案例和内部评测——Speak的80%、2.3万行代码、Tau3第一名,说明的是全双工可能改善交互和维护成本,推导不出所有客服系统都会提升80%的解决率。
企业真正要盯的数据不多:平均会话时长,每通电话的累计输入、缓存输入和输出token,三档模型的路由比例,再加上人工接管率和重复来电率。这几个数凑齐,每次成功解决成本就算得出来。
写在最后
回到标题的问题:0.05美元一分钟,为什么不是最终价格?
因为0.05美元只覆盖实时语音会话。后端模型负责复杂推理,工具负责搜索、知识查询和业务操作,这些费用分别进入另外几张账单。
至于0.05美元在总账里占几成——对简单客服,语音层可能占整通电话的80%;换成Astra处理复杂任务,它降到45%左右;把输入缓存做好,又回到56%。这些比例都来自同一张官方价目表,差别全在开发者怎么组织后端。
国内的端到端模型走的是另一条路:一张账单按token算,推理已经包含在内。两边不能只比单价,得先看账单结构——一层还是两层,按时间还是按内容。
企业最终需要比较的单位,是每次成功解决成本。
一句话收束:语音层是不是大头,取决于后端选谁和缓存做没做对。这两件事都在开发者手里,不在0.05美元的价签上。
下一篇继续拆这个价签上没写的东西:会话按秒计费,用户沉默的那几秒,到底由谁买单?
如果这篇对你有用,点个在看,或者给公众号加个星标,下一篇不会错过。你的语音Agent账单长什么样,欢迎在评论区聊聊。
资料边界说明
本文所有价格核对于2026年9月15日。API和电话线路价格会调整,发布前请再核一遍。
一手官方资料
- OpenAI发布稿《Build more natural voice experiences with GPT-Live-1 in the API》(2026年9月10日):https://openai.com/index/introducing-gpt-live-1-in-the-api/
- OpenAI API定价页(GPT-Live sessions、Flagship models、Tools、Realtime and audio generation models四节):https://developers.openai.com/api/docs/pricing
- GPT-Live-1模型页:https://developers.openai.com/api/docs/models/gpt-live-1
- OpenAI Responses API参考(缓存键、缓存有效期等参数):https://developers.openai.com/api/reference/cli/resources/responses/methods/create
- GPT-Realtime-2.1模型页:https://developers.openai.com/api/docs/models/gpt-realtime-2.1
- Twilio美国Voice定价页(入站、录音、转写、Voice Insights、Conversation Relay):https://www.twilio.com/en-us/voice/pricing/us
- OpenAI客户案例页Ada(旧系统自助处理率约70%/解决率30%,新系统解决率60%至80%以上):https://openai.com/index/ada/
- OpenAI客户案例页Klarna(首月230万次对话、重复咨询下降25%、11分钟→2分钟):https://openai.com/index/klarna/ ——两页均为厂商发布的客户案例,且以文字客服为主,本文只用于说明指标口径,不作为语音客服的效果预测
- 阿里云百炼《模型调用计费》(千问Omni-Realtime价格、“每秒音频对应25个Token”换算规则,页面更新于2026年9月14日):https://help.aliyun.com/zh/model-studio/model-pricing
- 阿里云百炼《Qwen-Omni实时模型》文档(函数调用、联网搜索能力):https://help.aliyun.com/zh/model-studio/realtime
第三方媒体
- 北京商报(新浪财经转载,2026年6月18日):火山引擎上线豆包实时语音模型3.0(Seeduplex)API邀测——本文只引用产品路线,价格未采用
- 合力亿捷、蓝蓝通信等呼叫中心厂商博客(2026年):国内呼叫中心“按坐席/按并发/按分钟/按线路”四种计费口径——行业口径,不作为具体报价依据
新闻由头
- DataNorth《OpenAI launches GPT-Live-1 in the API》(2026年9月11日):https://datanorth.ai/news/openai-launches-gpt-live-1-in-the-api ——用于追踪新闻发布时间;价格、产品能力和本文计算均回到OpenAI官方资料核验。
厂商客户口径(单独标注,不作为普遍结论)
- Speak打断减少近80%、某客户删除2.3万行代码、GPT-Live-1+Astra medium在Tau3排名第一,均出自OpenAI发布稿。
本文示意账单的边界
- 5分钟、10轮、1.5万输入、2000输出、1次网页搜索、2次文件搜索、Twilio美国本地入站,是作者设定的示意场景,不是官方案例,也不是实测账单。
- 缓存表描述稳定运行后的单通成本,主表未计首次缓存写入费,正文另行说明了写入费及其摊销前提。
- 1.5万输入token已包含网页搜索返回内容,工具费中不再重复计算。
- 第六节的人民币换算按发稿日汇率取整,发布前替换为当日汇率;“用户说2.5分钟、AI说2.5分钟”为示意假设;百炼价格为华北2(北京)地域原价,不含活动折扣和上下文缓存。
- 豆包实时语音模型价格未在本文出现:火山方舟定价页为动态渲染页面,本文未核到可引用的稳定口径,发布前如能核实可补入第六节。