本文属于「算力账本」系列。《拥有1P算力,能干点什么?》算的是一套硬件理论上能算多少;这一篇往前推一层:一座数据中心能接住多少电。新闻由头是博通2026财年Q3电话会(9月2日):Anthropic的TPU部署从2026年的1吉瓦扩到2027年的5吉瓦,2028年再增10吉瓦。
Anthropic在2026年4月披露,年化收入已超过300亿美元。博通预计在2027年将部署5吉瓦TPU v8i;按博通给出的每吉瓦半导体内容价值线性外推,背后可能对应1000亿至1500亿美元的长期收入机会,但这不是Anthropic已经披露的合同金额。
“吉瓦”这个单位也出现在其他合作中。OpenAI和英伟达2025年公布的合作意向是“至少10吉瓦”,官方称最终会包含数百万颗GPU,首个吉瓦计划2026年下半年上线。OpenAI自己定制的Jalapeño芯片,博通给出的2027年部署规划是1.3吉瓦。另一份关于DeepSeek数据中心的报道,则用了读者更熟悉的颗数:至少16万颗昇腾950DT。
两类数字放在一起很显眼。有的项目按芯片颗数报道,有的项目直接公布5吉瓦、10吉瓦的容量规划。到了跨越数年和多代硬件的基础设施项目,固定的芯片数量已经很难描述完整边界。
这则新闻中博通电话会里的这些吉瓦是未来的部署规划,不是今天已经通电运行的算力。
带着三个问题往下看:1吉瓦到底能装多少张GPU?5吉瓦意味着多少钱、多少电、多少可用算力?为什么同一个项目按GPU算和按吉瓦算,会得出完全不同的结论?
一、吉瓦、P和token/s,是三本不同的账
之前一篇讲1P算力的时候,我们把“智算中心报的P数”拆成了所有卡峰值算力的总和。吉瓦是另一个方向的单位,它和单位“P”之间没有固定汇率。
吉瓦(GW),1GW=10亿瓦,是功率。功率不是用电量,1吉瓦连续跑一年,是1GW×8760小时=87.6亿度电,写成TWh是8.76TWh。
数据中心公告里的“1吉瓦”可能指四个不同的位置:园区的电网接入容量、数据中心的总设施功率、IT设备的铭牌功率、服务器实际运行功率。冷却、配电和照明都要用电,如果1吉瓦量在园区入口,真正进入服务器的电一定少于1吉瓦。不说清楚在哪个位置量的,两个“1吉瓦”不能直接比。
P(PFLOPS)是芯片理论上每秒能完成多少浮点运算。它取决于精度是FP16还是FP8、报的是稠密还是稀疏、算的是单卡峰值还是整套系统。这些在上一篇拆过,这里不重复。要修正的是我自己先前的一个说法:P不是吉瓦的“输出端”,它是电力转向计算能力的中间层。
token/s才是业务真正得到的东西。用户不买FLOPS,也不买瓦特,买的是每秒能生成多少token、一次训练要多少天、能撑多少并发、每百万token多少钱、服务能不能达到SLA(服务商承诺的可用性和响应速度,达不到要赔)。
这三者的关系画成一条链是这样:
| |
这三者之间不能直接相乘换算。吉瓦需要结合芯片类型、机架功率和PUE才能估计硬件规模;PFLOPS还要结合精度、模型和软件效率,才能接近最终的token吞吐。
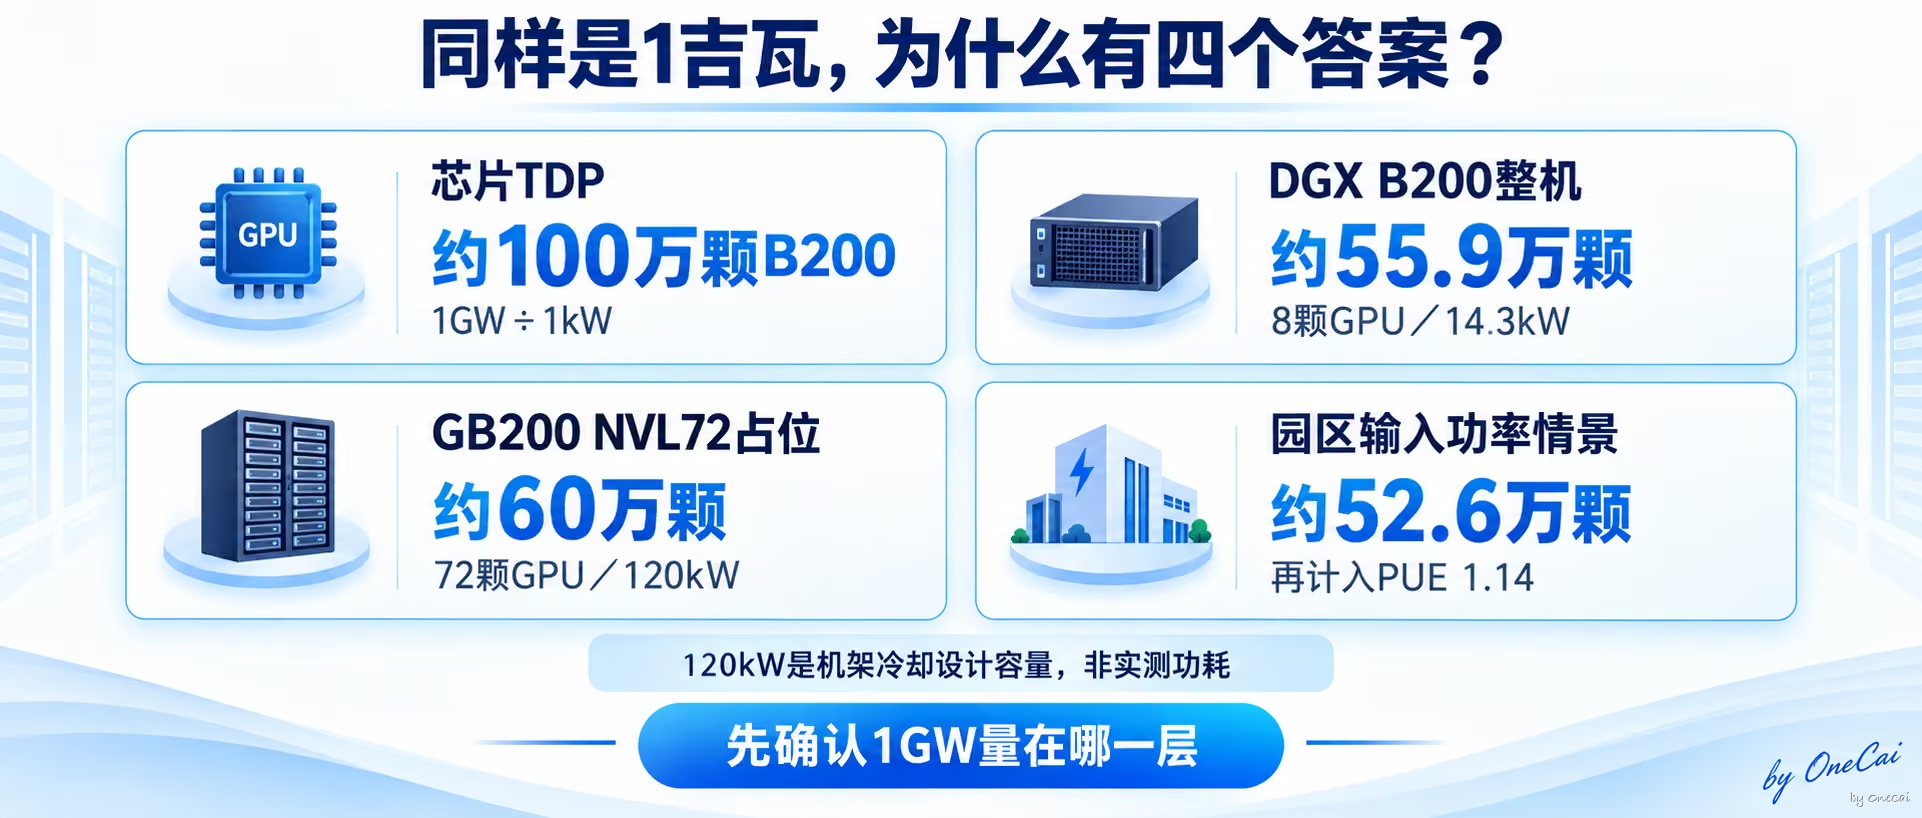
二、1吉瓦到底是多少张B200?同一个问题有四个答案
先把三个容易混的名字分开:B200是一颗独立的GPU;GB200是一颗Grace CPU加两颗Blackwell GPU组成的超级芯片;GB200 NVL72是把36颗Grace CPU和72颗Blackwell GPU装进一个液冷机架的完整系统。
从最直接的除法开始。NVIDIA给B200的最高热设计功耗是1000W。把1吉瓦全部除以单卡功耗:
| |
这个答案数学上没错,工程上几乎没法用。GPU不能单独挂在电网上跑,CPU、内存、网卡、NVSwitch、存储、电源转换和冷却系统都要占功率。
换成完整服务器再算。DGX B200装8颗Blackwell GPU,整机最大功率约14.3kW:
| |
再换成整机架。NVIDIA公开的GB200 NVL72机架冷却设计容量约120kW。它不是整机架的实测运行功耗,只把它近似当作机架功率占位值:
| |
55.9万和60万的差别不只来自系统形态。前者使用DGX B200整机最大输入功率,后者使用NVL72的冷却设计容量,两个分母本身也不是同一种测量口径。
如果公告里的1吉瓦指的是园区总输入功率,还要继续扣掉数据中心自己的消耗。Epoch AI的一吉瓦成本模型采用1.14的PUE,也就是服务器每用1度电,整个园区大约消耗1.14度。把这一假设与前面的120kW占位值组合,1吉瓦园区功率只剩约877MW进入IT设备:
| |
把上面四步整合在一张表中:
| 换算层级 | 算法 | 1吉瓦对应 | 没算进去的 |
|---|---|---|---|
| 芯片TDP | 1GW÷1kW | 约100万颗B200 | CPU、网络、存储、供电、冷却 |
| 完整服务器 | 1GW÷14.3kW×8(DGX B200整机最大功率) | 约55.9万颗 | 外部网络、存储、设施损耗 |
| 整机架占位 | 1GW÷120kW×72(GB200 NVL72) | 约60万颗 | 120kW是冷却设计容量;未计PUE与园区配套 |
| 园区输入功率情景 | 1GW÷1.14÷120kW×72 | 约52.6万颗 | 网络、供电余量、冗余和实际机架功率 |
从100万到52.6万,差了将近一半。100万和55.9万分别是芯片TDP与完整服务器口径;60万和52.6万还使用了120kW冷却容量作为占位假设。它们适合展示口径变化,不能当成同一精度的官方答案。
看到“1吉瓦是多少张卡”,需要先确认这个吉瓦是在变压器入口、数据中心总表,还是服务器机架上量的。换一代GPU、换一种机架或换一个测量位置,答案都会变。
三、Anthropic的5吉瓦,三本账分别是多少
有了换算基准,把文章开头新闻里的数字放进去。
芯片层:两三百万颗GPU的电力规模
用Blackwell做参照,5吉瓦按每吉瓦52.6万到60万颗的两个机架情景计算,大约是263万到300万颗GPU的功率占位。
这里必须还需要注意三点。第一,这是用Blackwell系统做的功率换算,不是TPU v8i的实际颗数。第二,这不代表TPU和GPU性能等价。第三,TPU v8i的单颗功耗、机架结构和部署数量,博通和Google都没有公开。
准确地说,如果用Blackwell机架做参照,5吉瓦大约是263万至300万颗GPU的功率占位。Anthropic规划的是TPU容量,不能据此推断它实际会部署多少颗TPU。
建设层:三个“每吉瓦价格”,算的不是同一层
关于1吉瓦要多少钱,市面上有三个数,如下表:
| 口径 | 每吉瓦 | 5吉瓦线性外推 | 实际代表什么 |
|---|---|---|---|
| 博通半导体内容价值 | 200亿~300亿美元 | 1000亿~1500亿美元 | 博通在XPU及相关半导体上的收入机会,不是整站造价 |
| Bernstein整站估算 | 约350亿美元 | 约1750亿美元 | 一套GB200数据中心的第三方资本开支估算 |
| Epoch AI风格化模型 | 约380亿美元 | 约1900亿美元 | 1吉瓦IT铭牌功率、全部GB200 NVL72、美国超大规模运营商 |
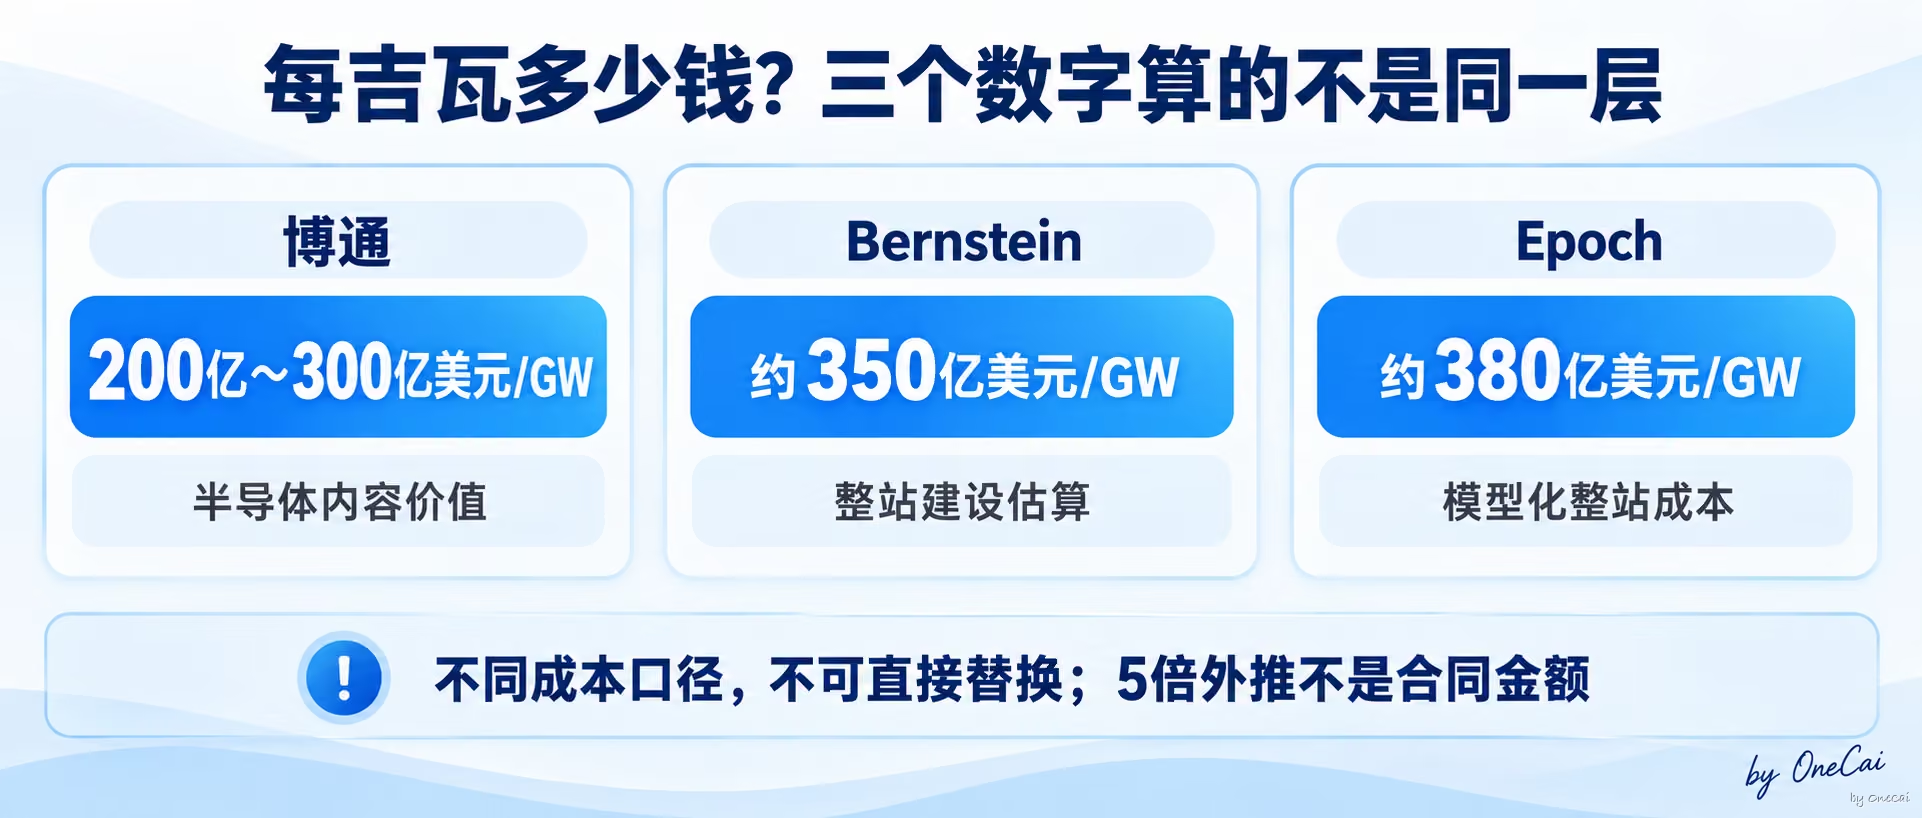
第一个数来自博通CEO Hock Tan在电话会问答里的回答。Bernstein的分析师追问每吉瓦的收入,Tan说博通每吉瓦的内容价值应该维持在200亿到300亿美元,即便每一代新芯片都更强、更贵。注意,这只是博通卖的那一层。
第二个数是Bernstein按GB200机架拆出来的整站成本,每机柜约590万美元,其中硬件340万、物理基建250万。
第三个数来自Epoch AI今年5月发布的一吉瓦数据中心总拥有成本模型。前期资本开支约380亿美元,年运营支出约9亿美元;把资本开支按资产寿命年化后,每年总成本约85亿美元,其中服务器占50亿,也就是六成。这个模型假设IT设备寿命5年、厂房14年。
三个数并列,不选一个当标准答案。它们之间不矛盾,因为算的不是同一层。博通算自己能卖多少,Bernstein算整站要花多少,Epoch算每年摊多少。
还有一个容易被误读的数。今年6月博通和Apollo、Blackstone成立的融资平台AI XPV,首期350亿美元对应Anthropic约1吉瓦的部署。这个数和Bernstein的每吉瓦350亿看起来正好对上,但它是一笔包含机架、租赁和金融安排的融资规模,不能读成“1吉瓦芯片售价350亿美元”。
再加一句必须加的话——5倍线性外推只是为了建立数量级,不是Anthropic的合同金额。大项目可能有规模效应,也可能因为供电、融资和下一代硬件而更贵。
年化层:5吉瓦IT功率满载一年是43.8TWh
如果5吉瓦量在IT设备铭牌功率位置,全年满功率运行的IT用电量是5GW×8760小时=43.8TWh。按1.14 PUE计算,整站用电量还会升至约49.9TWh。这是极端情景,不是实际年用电量。
现实负载会波动。按Epoch模型的71%利用率和1.14 PUE计算,IT设备年用电约31.1TWh,整站约35.5TWh。Epoch模型里1吉瓦的年能源支出约6亿美元,采用的加权工业电价约为8.34美分/度;5吉瓦线性换算接近30亿美元一年。电价、利用率和供电策略都会改变这个数。
2025年全国全社会用电量约10.4万亿度。如果5吉瓦全部建成且IT设备全年按铭牌功率运行,43.8TWh的IT用电量约占全国年用电量的0.42%,含设施损耗的整站用电量约占0.48%;按Epoch模型的71%利用率和1.14 PUE计算,整站用电量约占0.34%。这些都是情景换算,不是Anthropic已经发生的用电量。
一份5吉瓦规划可以换算成数百万颗GPU的功率占位、不同口径下超过千亿美元的建设量级,或者数百亿度的情景年用电量。这三种结果说的是三件不同的事。
四、为什么公司现在报吉瓦,不再只报芯片数量
这是真正的问题。数芯片明明更直观,为什么头部公司集体改口?
合同跨越多代芯片
看这几份合同的时间跨度。OpenAI和英伟达的10吉瓦,首期用Vera Rubin;Anthropic的规划从Ironwood(TPU v7)跨到TPU v8i;OpenAI的Jalapeño后面还有博通说“正在接近流片”的第二代和已在开发的第三代。
同样是1吉瓦,下一代芯片单颗功耗更高、单价更高,能装的颗数更少,但总算力可能更高。Hock Tan在电话会上的解释正是这个逻辑:新一代XPU单价会涨,单颗功耗也会涨,所以每吉瓦能容纳的芯片数减少,最终每吉瓦的半导体内容仍然落在200亿到300亿美元。
用固定颗数描述一份跨三年、跨多代芯片的协议,数字很快会失真。用吉瓦约束基础设施边界,更适合在硬件持续升级的情况下做长期规划,具体型号、价格和采购批次仍然需要继续调整。
芯片到货不等于产能上线
一批卡拿到手,离能用还差一整座数据中心。包括但不限于土地和建筑、电网接入和变压器和备用电源、液冷和热交换、HBM和基板和光通信器件、网络和存储和控制节点、软件调优和故障恢复。
Tan在电话会上说建AI数据中心是一个“多维问题”,土地、电力和厂房会决定产能什么时候上线;他还提到EML和CW激光器供不应求,博通正在继续扩充相关产能。
拆Atlas 950超节点的时候遇到过同一件事:芯片参数只是起点,功率、互联、冷却和软件共同决定系统最终能跑成什么样。那篇看的是一个超节点,这篇把同样的系统工程逻辑放大到一座园区。
只报芯片数量,描述的是一张机器清单;报吉瓦,才把整座数据中心纳入采购口径。
电力比芯片型号更适合长期规划
芯片通常一两年就会迭代,电网接入和数据中心建设往往需要更长的规划周期。
对一家AI公司来说,提出5吉瓦规划,意味着土地、电网、园区规模、融资和云容量都要按这个数量级准备。电话会同时提醒,需求规划并不代表这些条件已经全部落实,最终能有多少容量按期投产仍有不确定性。
“多少张卡”适合盘点已经建成的资产,“多少吉瓦”更适合描述未来几年准备建设的产能。头部公司的算力规划已经不只是一批芯片,还包括一条持续数年的基础设施建设链。
五、规划了5吉瓦,不等于已经拥有5吉瓦算力
一个吉瓦数字,从合同走到token,要下四级台阶。
合同产能。协议、意向书或容量上限里写的吉瓦。它可能包含未来的采购计划、可选而非必选的容量、还没最终签署的意向、以及跨越数年的累计部署。OpenAI和英伟达的10吉瓦,到今天为止就是一份意向书,首个吉瓦还在建设计划里。
建设产能。已经拿到土地、资金、设备合同并进入建设的容量。有合同,不代表电网、建筑、冷却系统已经动工。
通电产能。数据中心已经接入电网,可以向设备稳定送电。厂房建好了、变电设施没到位,GPU一样开不了机。
可用算力。芯片、网络、存储、软件全部到位,能稳定承接训练或推理的容量。这一级还要继续扣:故障与维护、冗余设备、调度碎片、低利用率、通信和数据等待、软件没调优造成的性能损失。
博通电话会给出了更直接的例子。管理层看到六家XPU客户在2027年至2028年合计约30吉瓦的需求,但同时明确表示,这不代表30吉瓦都会在两年内投产。数据中心外壳、电力、设备和交付时间都可能让实际部署低于需求规划。
如果你读过《超分比》那篇,可以把框架接上。当时用“有效算力≈标称P数×可兑现份额×MFU”提醒读者,账面资源还要经过调度与软件效率。放到吉瓦级项目,如果标称P来自规划容量,还要先扣掉尚未通电的部分。它不是严格的工程公式,只是把合同容量到有效算力之间最容易漏掉的一层标出来。
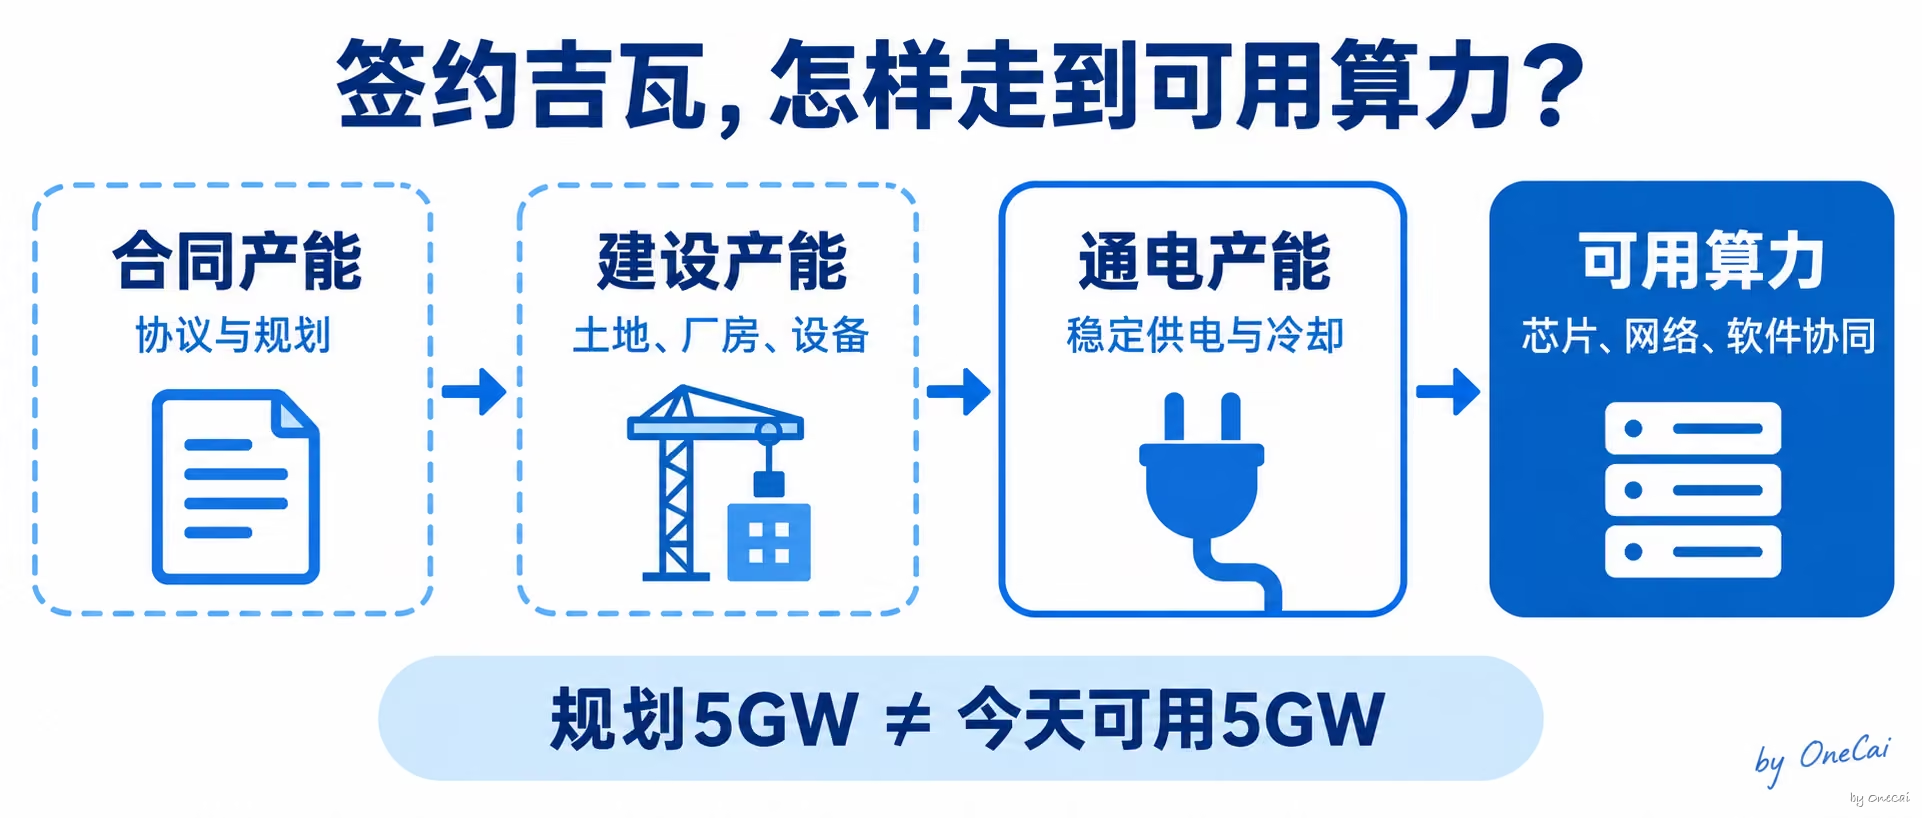
签约吉瓦回答“未来最多能拿到多少容量”,通电吉瓦回答“今天有多少机器能开机”,可用算力才回答“Claude现在能跑多少任务”。
六、回看16万颗950DT:数得最具体,反而最难算
写到这里,很自然会想把前面那个数字也换算一下:16万颗950DT,是多少吉瓦?
据彭博报道,DeepSeek计划在新数据中心部署至少16万颗950DT,园区最终规划约1吉瓦。这些数字来自匿名信源,不是DeepSeek或华为官方确认的采购与建设进度。950DT的单卡功耗和完整机架功率也没有可核实的官方数字;16万颗未必覆盖1吉瓦项目的全部设备或全部建设阶段。
所以两个方向都不能做。不能算“16万颗≈多少吉瓦”,也不能算“1吉瓦≈多少颗950DT”。更不能用1GW÷16万=6.25kW去反推950DT的功耗——那6.25kW里可能包含CPU、内存、网络、电源、冷却,以及项目尚未安装的剩余容量。
这一节不是为了补一个国产卡的数字。它是全文判断的一个反例:卡数看起来比吉瓦具体,但缺了功耗、机架和系统边界,16万颗同样变不成可以比较的算力。
这两个案例强调的是不同约束。950DT报道突出芯片供给,博通披露突出未来电力与园区容量。它们不能直接用来比较项目优劣。
七、吉瓦仍然不是AI公司的成绩单
这个系列写到现在,已经攒了一串“不等于”。把它们排在一起:
- 标称P,不等于有效训练算力;
- 签约吉瓦,不等于已通电吉瓦;
- 通电吉瓦,不等于高利用率;
- 高利用率,不等于更低的每token成本;
- 更大的集群,也不自动等于更强的模型。
那什么才值得盯?我列一份清单:已通电的MW/GW数、实际部署的机架数、PUE和平均利用率、训练MFU和故障恢复时间、推理的token/s和首token延迟、每百万token的真实成本、以及每吉瓦最终能产生多少持续收入。
这些数字,Anthropic、OpenAI和博通目前都没有完整公开。在它们公开之前,吉瓦让算力订单更接近物理世界,却没有让它变成性能指标。它只是把问题从“有多少张卡”,推进到了“能给这些卡供多少电”。
写在最后:结束的不是芯片时代,而是只数芯片的时代
过去我们问,一座集群有多少张H100。现在OpenAI、Anthropic和博通开始谈5吉瓦、10吉瓦。
芯片仍然重要,但一座百万卡集群的边界已经不能由芯片数量单独决定。土地能不能批下来,电网什么时候接通,厂房和液冷能不能按期完成,HBM、基板、光模块和机架能不能一起到位,任何一项都可能让规划中的5吉瓦停在纸面上。
所以,数芯片的时代没有结束。结束的是看到“百万张GPU”,就以为已经得到百万张GPU算力的算法。
和P一样,吉瓦也是账面数字。标称P不等于实测P,签约吉瓦也不等于通电吉瓦。最终需要看的,是有多少容量真正通电,并稳定地变成可以交付的token。
下一篇接着算:一家年化收入300亿美元的公司,怎么撑得起年化几百亿美元的算力——答案是“租”。
如果这篇让你下次看到“X吉瓦”时多问一句是签约还是通电,欢迎点个在看。你所在的公司或机构,算力预算是按卡数批,还是按电力批?也欢迎在评论区聊聊。
参考资料
- 博通2026财年Q3电话会(9月2日召开,Motley Fool第三方转录):https://www.fool.com/earnings/call-transcripts/2026/09/09/broadcom-avgo-q3-2026-earnings-call-transcript/
- 博通、Apollo和Blackstone关于AI XPV平台的官方公告:https://investors.broadcom.com/news-releases/news-release-details/broadcom-apollo-and-blackstone-establish-landmark-strategic
- Anthropic官方公告《扩大与Google和博通的合作》(2026年4月6日):https://www.anthropic.com/news/google-broadcom-partnership-compute
- OpenAI与NVIDIA系统合作官方公告:https://openai.com/index/openai-nvidia-systems-partnership/
- Epoch AI《一吉瓦AI数据中心的总拥有成本》(2026年5月14日):https://epoch.ai/data-insights/ai-datacenter-cost-breakdown
- NVIDIA DGX B200规格页:https://www.nvidia.com/en-us/data-center/dgx-b200/
- NVIDIA HGX B200单卡TDP(产品碳足迹说明):https://images.nvidia.com/aem-dam/Solutions/documents/HGX-B200-PCF-Summary.pdf
- NVIDIA GB200 NVL72产品页:https://www.nvidia.com/en-us/data-center/gb200-nvl72/
- NVIDIA关于GB200 NVL72的120kW机架冷却设计容量:https://developer.nvidia.com/blog/?p=90182
- Investing.com转述Bernstein每吉瓦成本分析(2025年11月):https://www.investing.com/news/stock-market-news/how-much-does-a-gw-of-data-center-capacity-actually-cost-4314046
- 2025年全国全社会用电量(国家能源局数据,中国政府网转载):https://english.www.gov.cn/archive/statistics/202601/17/content_WS696b548ec6d00ca5f9a08a0e.html
- 彭博关于DeepSeek拟采购至少16万颗950DT及约1GW园区规划的报道(可访问转载,匿名信源):https://economictimes.indiatimes.com/tech/artificial-intelligence/deepseek-plans-big-huawei-ai-chip-order-to-power-new-data-center/articleshow/133776211.cms
资料边界说明:
第一层(官方原始材料):Anthropic、OpenAI和博通的合作公告,NVIDIA的硬件规格与冷却设计资料,国家能源局公布的全国用电量。
第二层(电话会转录与机构研究):博通管理层的1/5/10吉瓦规划、每吉瓦200亿~300亿美元内容价值及建设瓶颈,依据Motley Fool对官方电话会的第三方转录;Epoch AI的一吉瓦成本模型是风格化研究,不代表具体项目。
第三层(媒体转述):Bernstein的每吉瓦整站成本估算经Investing.com转述;DeepSeek拟采购16万颗950DT及园区约1吉瓦来自彭博匿名信源,双方尚未公开确认。
第四层(本文情景换算):四种GPU数量、5吉瓦线性成本外推及年用电量均为按已列条件计算的示意值,不是Anthropic实际采购量、合同金额或已发生用电量。
口径说明:博通电话会中的Anthropic部署吉瓦数是前瞻规划,不代表已通电运行的算力;120kW是NVIDIA公布的机架冷却设计容量,不是实测功耗;950DT相关数字仅作口径对比,未推算其功耗或实际部署数量。价格与规格信息查证于2026年9月16日。