9月17日的华为HC全联接大会2026上,大屏打出昇腾960超节点的参数——单个超节点最多4096张昇腾卡,峰值算力8 EFLOPS FP8、16 EFLOPS FP4,HBM总容量1PB。华为把它描述成一套“物理上由多台机器组成、逻辑上却像一台计算机”的系统,业界首个用上NPO近封装光学的超节点。
有人可能问了:这不就是4096张卡凑一块儿吗?说得再直白点——华为是不是造出了一张由4096颗芯片拼成的巨型算力卡?
这篇想拆的,正是那个“凑”字,和那张并不存在的“巨卡”。之前几篇聊过“卡数×单卡算力≠有效算力”,这次往下再追一层——4096张卡分布在不同服务器、不同机柜里,凭什么能被叫做“一台计算机”?答案不在某一个漂亮数字上,而在于它要一层一层地搭:NPO只是最底下那一层,接上光纤,只是把路修通了。
8 EFLOPS,是一台机器,还是4096台机器的总和?
解释NPO之前,先看清楚“一台计算机”这个说法要跨过多少道坎。把4096张卡真放到一起,默认状态其实是这样的:
- 它们不在同一块主板上,卡与卡之间的数据传输,天生就比芯片内部计算慢得多;
- 任意一张卡、一个光引擎、一条链路,都可能出故障;
- 不同卡拿到的数据、分到的任务、通信的先后顺序,还得保持一致。
只把这4096张卡接上一张高速网络,它更像4096台联网的计算机,而不是一台。要让它在逻辑上收敛成“一台”,至少要解决四层问题,自下而上叠起来:
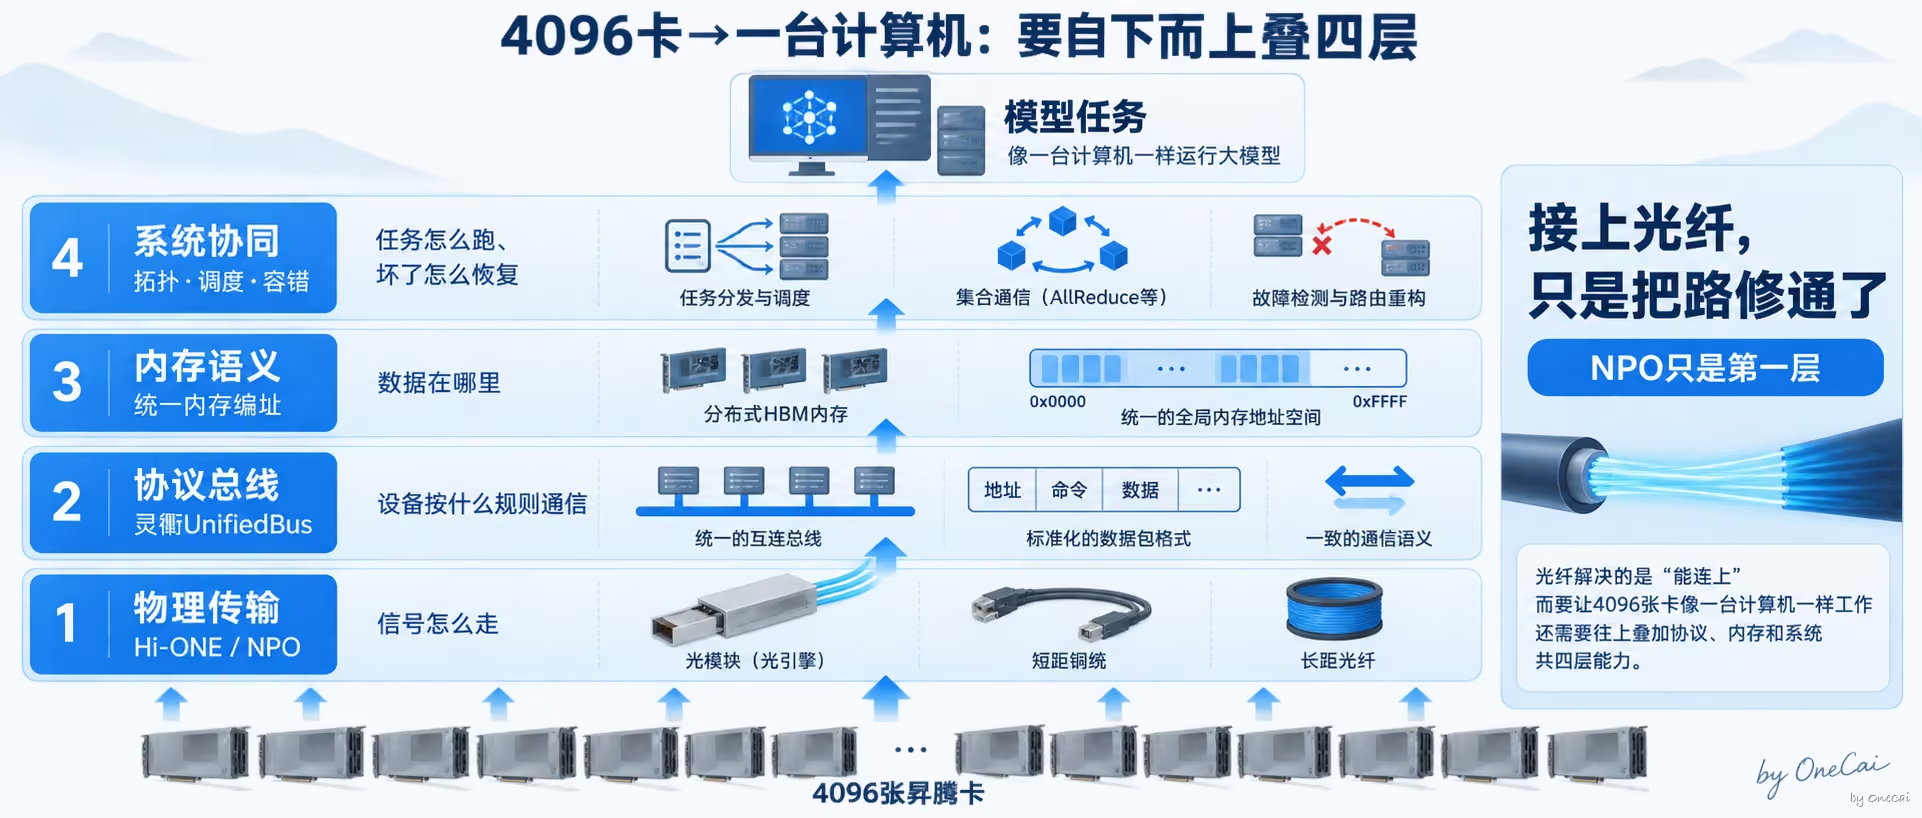
- 第一层,物理传输:信号怎么又快又省地跨过机柜——这一层是Hi-ONE/NPO。
- 第二层,协议总线:这些设备按什么规则识别、寻址、访问彼此——这一层是灵衢UnifiedBus。
- 第三层,内存语义:分散在各卡上的内存,能不能被软件当成同一片空间——这一层是统一内存编址。
- 第四层,调度与容错:模型任务怎么切、数据放哪张卡、坏了怎么恢复——这一层是拓扑、并行策略、集合通信和故障恢复。
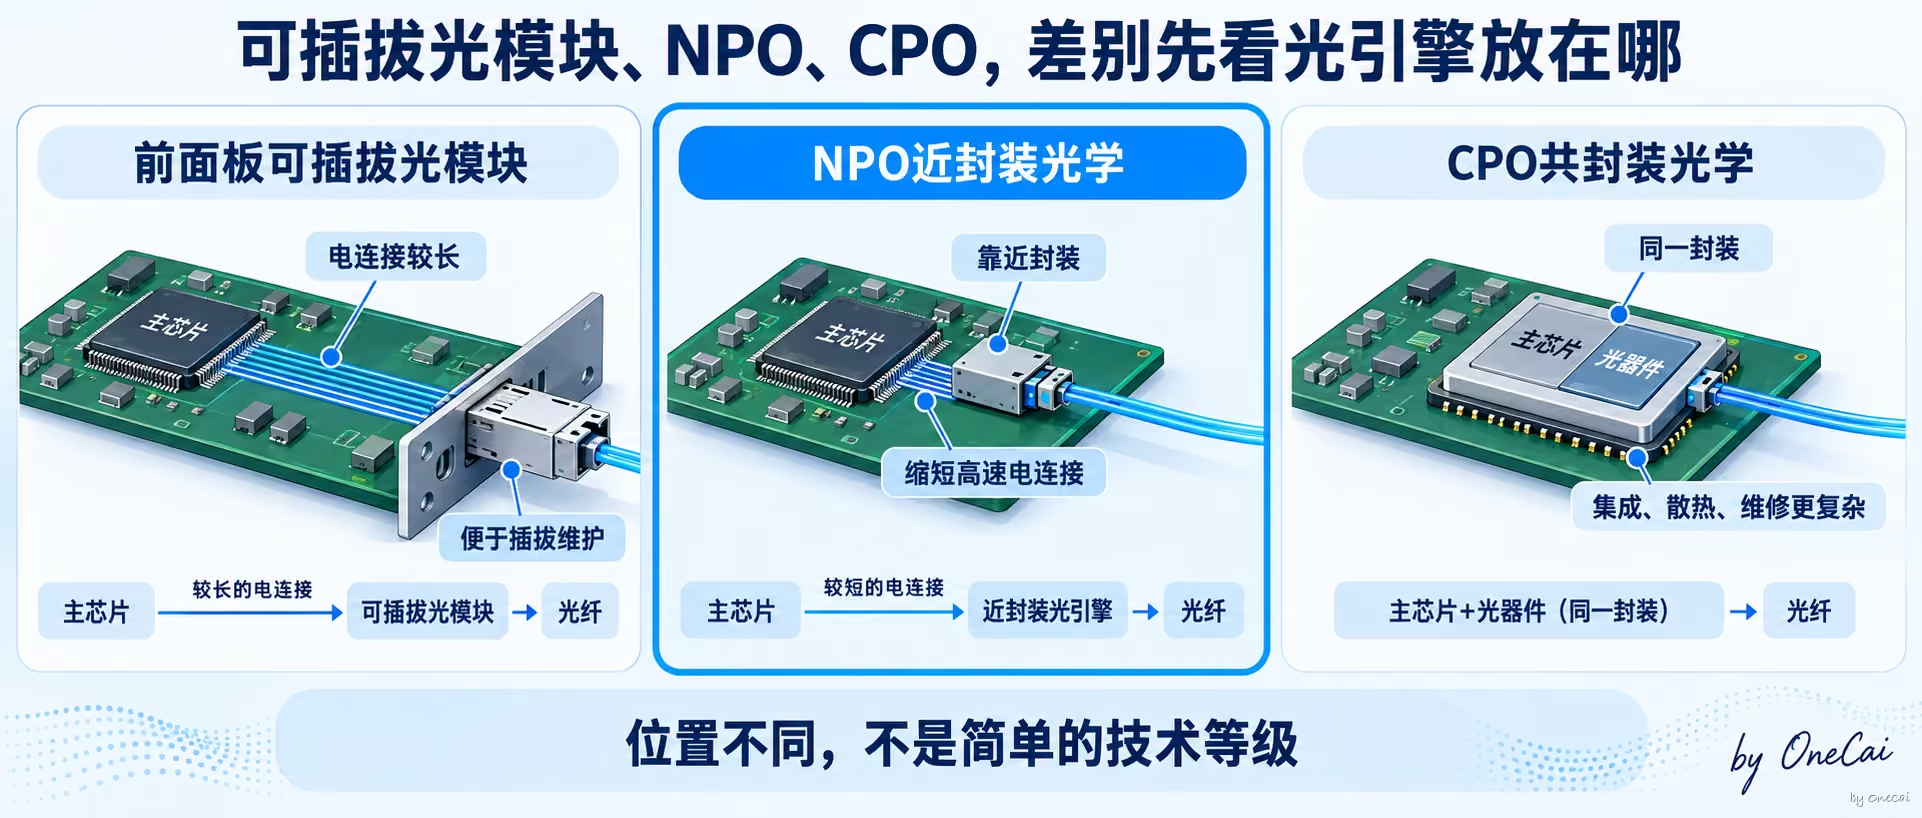
NPO是“近封装光学”(Near-Packaged Optics)的一种物理封装形态,不是一种协议。它常被拿来和CPO(共封装光学)比——区别只在光引擎放哪儿:NPO放在主芯片封装的旁边几厘米,CPO直接塞进同一个封装里。这是位置之争,不是谁比谁高级——OIF的共封装技术框架也是按器件位置来界定近封装与共封装,而非排成一条由低到高的技术等级。所以,凡是把这次的新闻写成“昇腾960用上光协议”的,第一步就说岔了。
下面一层一层看,每一层都分三件事讲清楚:华为说了什么、能从中推出什么、又不能推出什么。
第一层 · 物理传输:NPO解决“信号怎么走”,不负责让卡理解彼此
Hi-ONE和NPO待在整套系统的最底层——物理传输层。卡的数量从几百堆到几千,卡间的高速电信号要走的距离越来越远,铜缆的损耗、补偿电路、功耗、端口密度、布线散热就一起顶上来。NPO的思路是把“电转光”这一步挪到主芯片边缘几厘米处,短距离仍走电、长距离交给光,绕开铜缆的物理天花板。用一个类比:这相当于把市区里越修越堵的电线,改成从家门口就接上的光纤专线。
华为这次给出的数字是新一代NPO光引擎Hi-ONE单引擎传输容量7.2T、内置36个通道、单通道200Gbps,华为称其为业界首个具备量产能力、传输能力最大、唯一实现内置光源的NPO产品;技术上把DSP功能集成进交换机ASIC、移除了光引擎里的独立DSP,链路时延从100纳秒压到10纳秒,互连功耗降低约60%。最直观的一组对比是昇腾960超节点用约5500个Hi-ONE,替代了原本需要的约4.8万颗800G可插拔光模块,功耗降低超过550千瓦。
能推出的判断:当卡数进入几千这个量级,互联已经不是配角,而是决定超节点能建多大的天花板本身。缩短高频电连接、把长距离交给光,为“把更多卡组织进一个域”创造了物理条件。这一步做不好,后面三层都无从谈起。
不能顺手推出的结论,得拦住几个:
- “降550千瓦”是两套互联方案之间的功率差,不是整座数据中心省了550千瓦,更不能据此算“每个Token省了多少电”;
- 7.2T是单引擎容量,不能直接当成每张昇腾卡可以独占的带宽;
- “业界首个量产”“传输能力最大”“唯一内置光源”都是华为的厂商声明,正文得保留归属,不能改写成经过独立验证的行业结论;
- 最要紧的一条:“具备量产能力”不等于“4096卡的昇腾960超节点已经大规模交付”。华为另一份材料的口径里,基于NPO的Atlas 960系统仍处于测试阶段。
不过话说回来,该给的敬意得给足。在单芯片制程被卡脖子的前提下,还能把“业界首个量产NPO”这条最硬的路先趟通,是真功夫。内置光源、把DSP从光引擎搬进交换机ASIC、用5500个Hi-ONE把原本上万颗光模块的活计收进近封装——这些都不是PPT上的漂亮词,而是要在良率、散热、可靠性上一颗一颗啃下来的工程硬骨头。当很多人还在争论“要不要上光、上CPO还是NPO”,华为已经把它做成了能装进超节点、敢标“量产”的实物。更难得的是那份把竞争维度从“单卡强不强”整体挪到“系统连得好不好”的判断力和定力——这一步棋,无论最终成绩单如何,都配得上一句漂亮。也正因为它下得这么重,才更值得我们把它拆开看清楚:这份漂亮,究竟兑现在了哪一层。
光进铜退不是华为独家的故事。英伟达在2025年就发布了Quantum-X(InfiniBand,2026年上半年)和Spectrum-X(以太网,2026年下半年)两款共封装光学(CPO)交换机,用微环调制器把互连功耗压下来,博通、AMD、IBM也各自在推光互联。有意思的是,这恰好把前面那句“NPO是位置之争”落到了实处:华为押的是NPO(近封装),英伟达在交换机上押的是CPO(共封装)——两家龙头在“光引擎放哪儿”上做了相反的选择。所以这篇要讲的不是“华为发明了光互联”,而是“华为把光互联用在了超节点互联这一层,赌的是这条路线”。
第二层 · 协议总线:灵衢UnifiedBus解决“大家按什么规则通信”
物理链路只负责把信号送到,协议才决定设备怎么识别、寻址、访问彼此。灵衢UnifiedBus干的不是“把电换成光”,而是把NPU、CPU、内存、SSD、网卡、交换设备纳进同一套互联体系。华为把它概括成协议归一、内存语义、平等互联。
一个克制的类比。NPO铺好了高速公路,UnifiedBus规定车辆身份、目的地址和通行规则。只有路、没有规则,4096张卡照样无法协同完成一次模型计算。
为什么这层不可省?传统AI集群里,卡内互联、机间网络、存储网络、CPU访问,可能各用各的链路和协议,一次数据搬运要经过多次转发和协议转换——路径越长、层级越多,通信时延和软件协调成本就越难压。统一协议减少的,正是这些转换与协调。而它和第一层的关系可以一句话收住:NPO负责信号怎么传,UnifiedBus负责这些信号表达什么,两者合起来,就是华为说的“近铜远光+统一互联”。
华为这次也给灵衢配了成套的分层设备,覆盖柜内、跨柜、集群三级。柜内用灵衢互联刀片做到“零电缆”,华为称一个4096超节点因此省下约196公里铜缆;跨柜的灵衢交换设备有176个端口、每端口1.6T、单机280T全光互联,两层CLOS组网撑起4096卡,RTT时延低至2微秒;再往集群外扩,UBG交换机以1024的大Radix扇出去够百万卡规模。这套“从单柜到百万卡”的分层体系,也顺带回答了第一层的Hi-ONE最终插在哪儿——光引擎是这条总线的物理载体,而不是它的替代品。
所谓“4096卡像一台计算机”,不能全记在NPO头上。华为自己的口径也是“灵衢+统一内存编址+Hi-ONE”三者共同构成超节点——把功劳单独派给光互联,是最常见的误读。
不同设备间是否采用完全一致的内存语义、一次跨节点访问要过几级交换、拥塞与重传怎么处理、真实大模型负载下协议开销占多大比例——公开资料不足,以官方演讲稿为准。还有一条绕不开的线:统一协议的另一面是生态绑定,灵衢的核心IP握在华为手里,而目前多家云厂商在互联上更倾向以太网路线——“统一”到什么范围、由谁来定义,本身就是接下来值得盯的地方。
第三层 · 内存语义:统一编址让卡看到同一片空间,但1PB不是一张卡的本地显存
“一台计算机”最关键的一步变化,是软件不必再把每台服务器都当成完全独立的孤岛。统一内存编址,让分散在不同卡上的HBM进入同一套地址体系。
但这句话极容易被误读。昇腾960超节点“1PB HBM”,指的是4096张卡的HBM总容量,它不等于任意一张卡都能以本地HBM的速度访问全部1PB空间。
| 概念 | 它回答的问题 |
|---|---|
| 总容量 | 整套系统一共有多少HBM |
| 统一编址 | 不同设备能否用同一套地址体系找到数据 |
| 访问带宽 | 单卡或一组卡每秒能读多少数据 |
| 访问时延 | 本地访问 vs 跨节点访问,各要等多久 |
统一地址空间降低的是“软件管理分布式内存”的复杂度,但数据放在哪儿依然要紧:访问本地HBM、访问同机柜里邻卡的HBM、跨多级交换访问远端HBM,成本不可能天然一样。
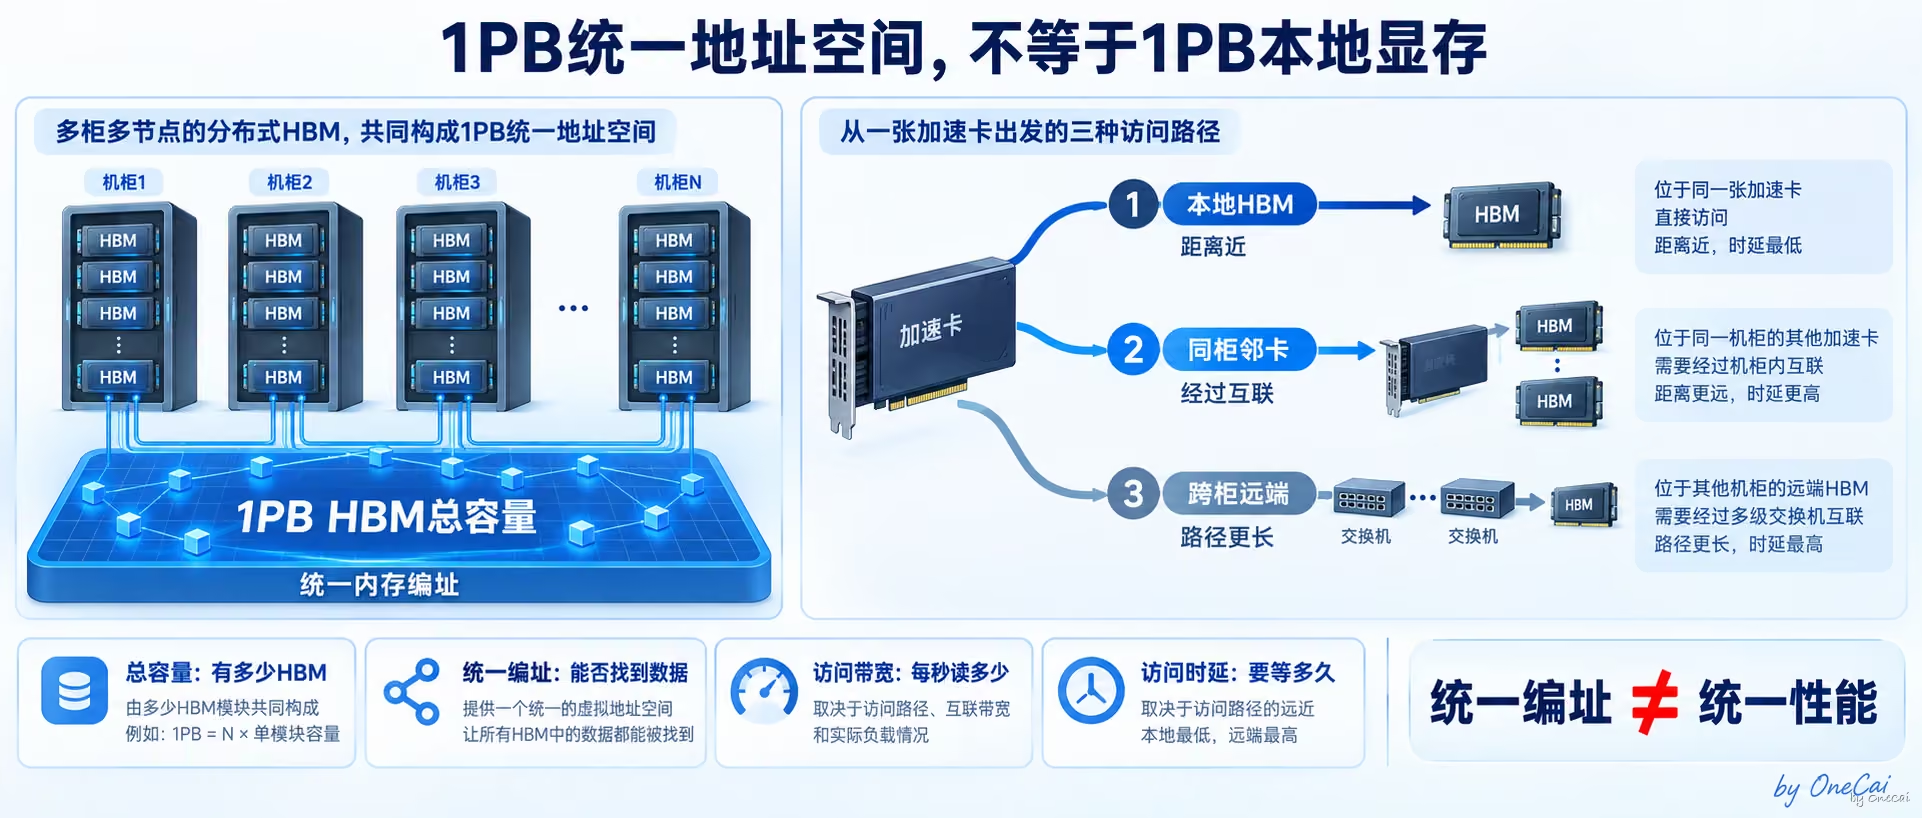
举个能落地的场景是一个塞不进单卡HBM的大模型,参数、激活值、KV Cache必须分散到不同卡上。统一编址能降低资源分割的复杂度,但模型并行策略仍要尽量少走远距离访问。这就给下一层留了问题——地址能找到数据之后,谁来决定模型怎么切、数据放哪张卡、通信什么时候发生?
1PB空间的具体一致性模型、本地与各级远端访问的时延差与有效带宽、故障后地址映射如何恢复、哪些访问由硬件完成、哪些仍靠软件运行时——公开资料都还不够。所以正文用“统一编址/统一地址空间”,慎用“4096张卡共享同一块内存”这种说法。
第四层 · 拓扑、调度、集合通信、故障恢复:决定这台大机器能不能持续跑满
前三层解决的是“能不能访问”,模型训练还要解决“怎样访问才不会让大部分卡一直干等”。这一层包含四组能力:拓扑(卡、交换设备、光引擎怎么连),并行策略(数据并行、张量并行、流水线并行怎么组合),集合通信(AllReduce、AllGather、All-to-All这些操作怎么映射到真实链路),以及故障恢复(某张卡或某条链路失效后,任务怎么隔离、重调度、续训)。
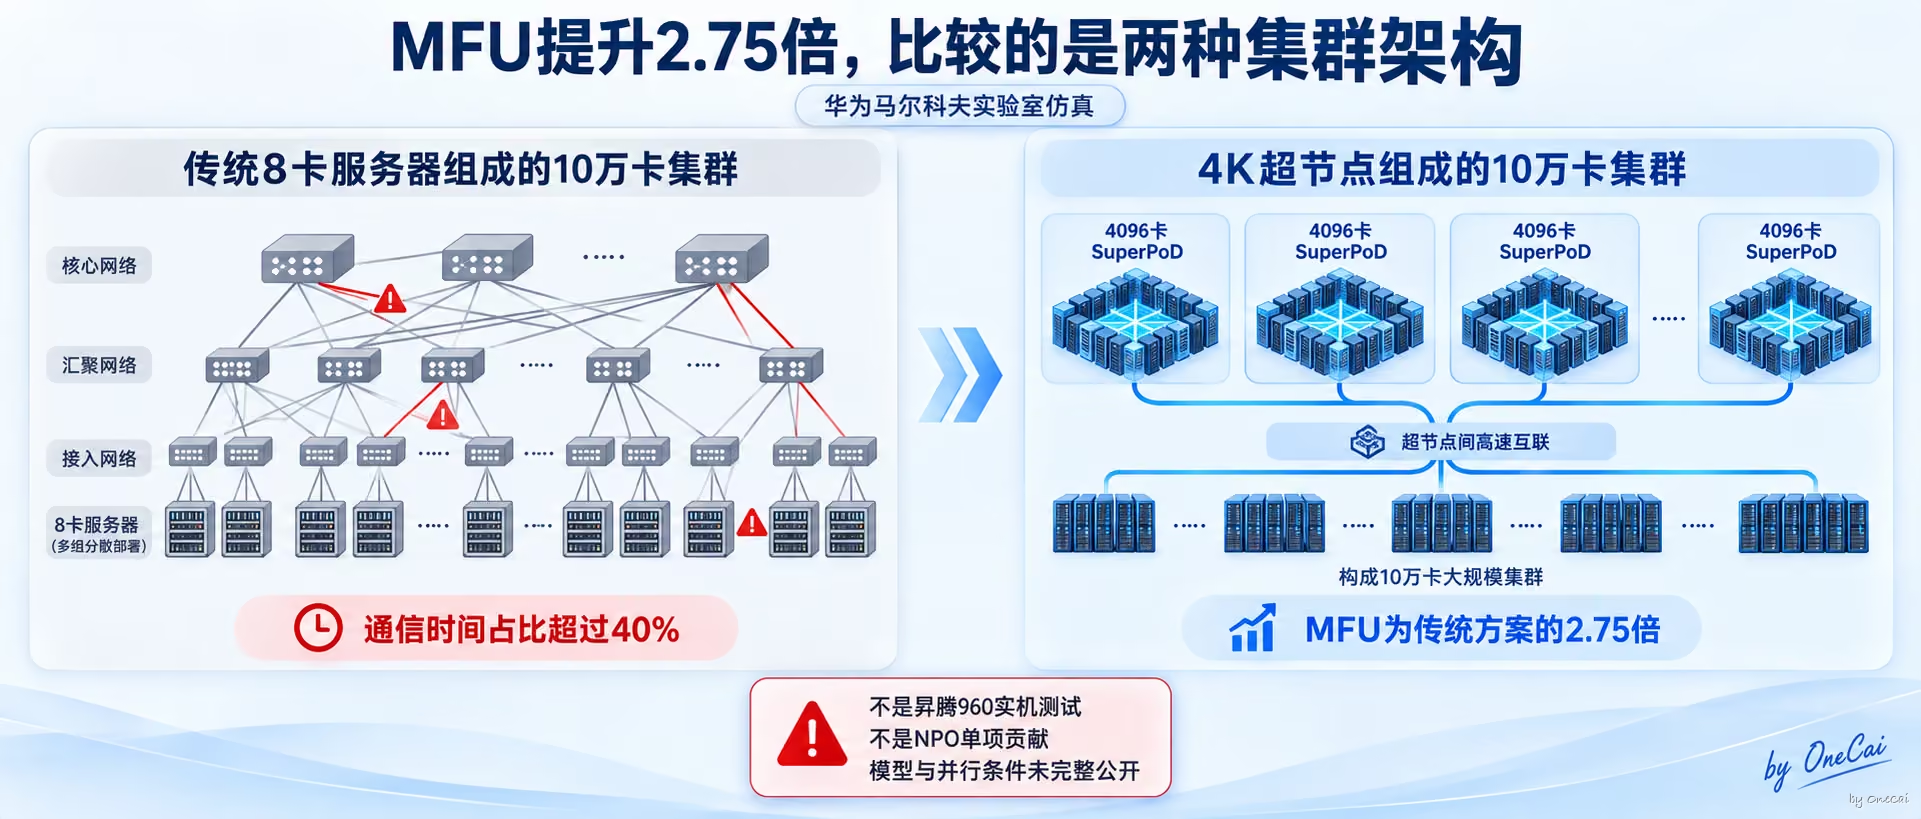
“MFU提升2.75倍”这个数字,应该放在这一层来读。华为披露了一组架构仿真:同样是十万卡集群,由4K超节点组成的方案,相比由8卡服务器组成的方案,MFU(模型浮点算力利用率)提升2.75倍,而传统架构的通信时间占比超过40%。这个数字能说明华为想通过“扩大紧耦合域”把通信开销压下去,但必须同时写清它的边界:
- 这是华为马尔科夫实验室的仿真结果,不是昇腾960超节点的实机测试;
- 比较对象是两种十万卡集群架构,不是NPO的单项贡献——拓扑、统一编址、集合通信实现、编译器和调度软件都会影响最终MFU;
- 有报道也点明,这类数据来自华为自测或仿真,未经第三方验证;模型、并行策略、软件版本、故障条件均未完整公开。
“系统可用度99.8%、无故障运行时间提升一倍”同理。可以把它当成设计目标来写,但不宜换算成“一年停机多少小时”,因为目前缺统计周期、缺“计划内维护是否计入”、缺故障定义、缺测试负载、也缺“单卡故障与系统不可用”之间的判定关系。这里正好回扣之前那篇“掉卡”:当4096张卡组成一个故障域,重点已经不只是单张卡会不会坏,而是坏了之后能不能绕行、隔离、恢复。
对比英伟达:4096该和72比,还是和576比?
这一节只想说明一件事:比较超节点之前,得先对齐“哪一层才算一台机器”。
按NVIDIA官方口径,GB200 NVL72是一个72卡的NVLink域,被官方描述为“acts as a single, massive GPU”(像一颗巨大的GPU那样工作);NVLink Switch System提供130 TB/s的GPU间通信带宽,一个满配机架在同一个NVLink域内共约13.5TB HBM3e,机架FP4约1.44 EFLOPS、FP8约0.72 EFLOPS。有意思的是,“最大的NVLink域”“像一台计算机”这套修辞,和华为“逻辑一台计算机”是同一个话术模板。
“NVL72可扩展至576”并不准确。更严谨的说法是——GB200 NVL72是一个72卡NVLink域;8个NVL72机架可以组成576卡的SuperPOD,但跨机架走的是InfiniBand计算网络,和单机架内的NVLink域不是同一个互联边界。早期英伟达技术博客确实把第五代NVLink说成最多支持576卡,但当前产品文档把NVL72明确定义为72卡域,正文应以当前产品架构为准,旧说法放注释,两种口径别混用。
| 项目 | 昇腾960超节点 | GB200 NVL72 | GB200 SuperPOD |
|---|---|---|---|
| 紧耦合规模 | 最大4096卡 | 72卡NVLink域 | 8×NVL72=576卡 |
| 域内互联 | 灵衢UnifiedBus+Hi-ONE NPO | 第五代NVLink | 机架内NVLink,跨机架InfiniBand |
| 内存口径 | 1PB HBM总容量 | 约13.5TB HBM3e(单域) | 多机架总量,≠单一72卡域 |
| 算力口径 | 8 EFLOPS FP8 | 约0.72 EFLOPS FP8 | 按机架数叠加 |
| 资料状态 | 测试及后续交付阶段 | 已有正式产品资料 | 参考架构 |
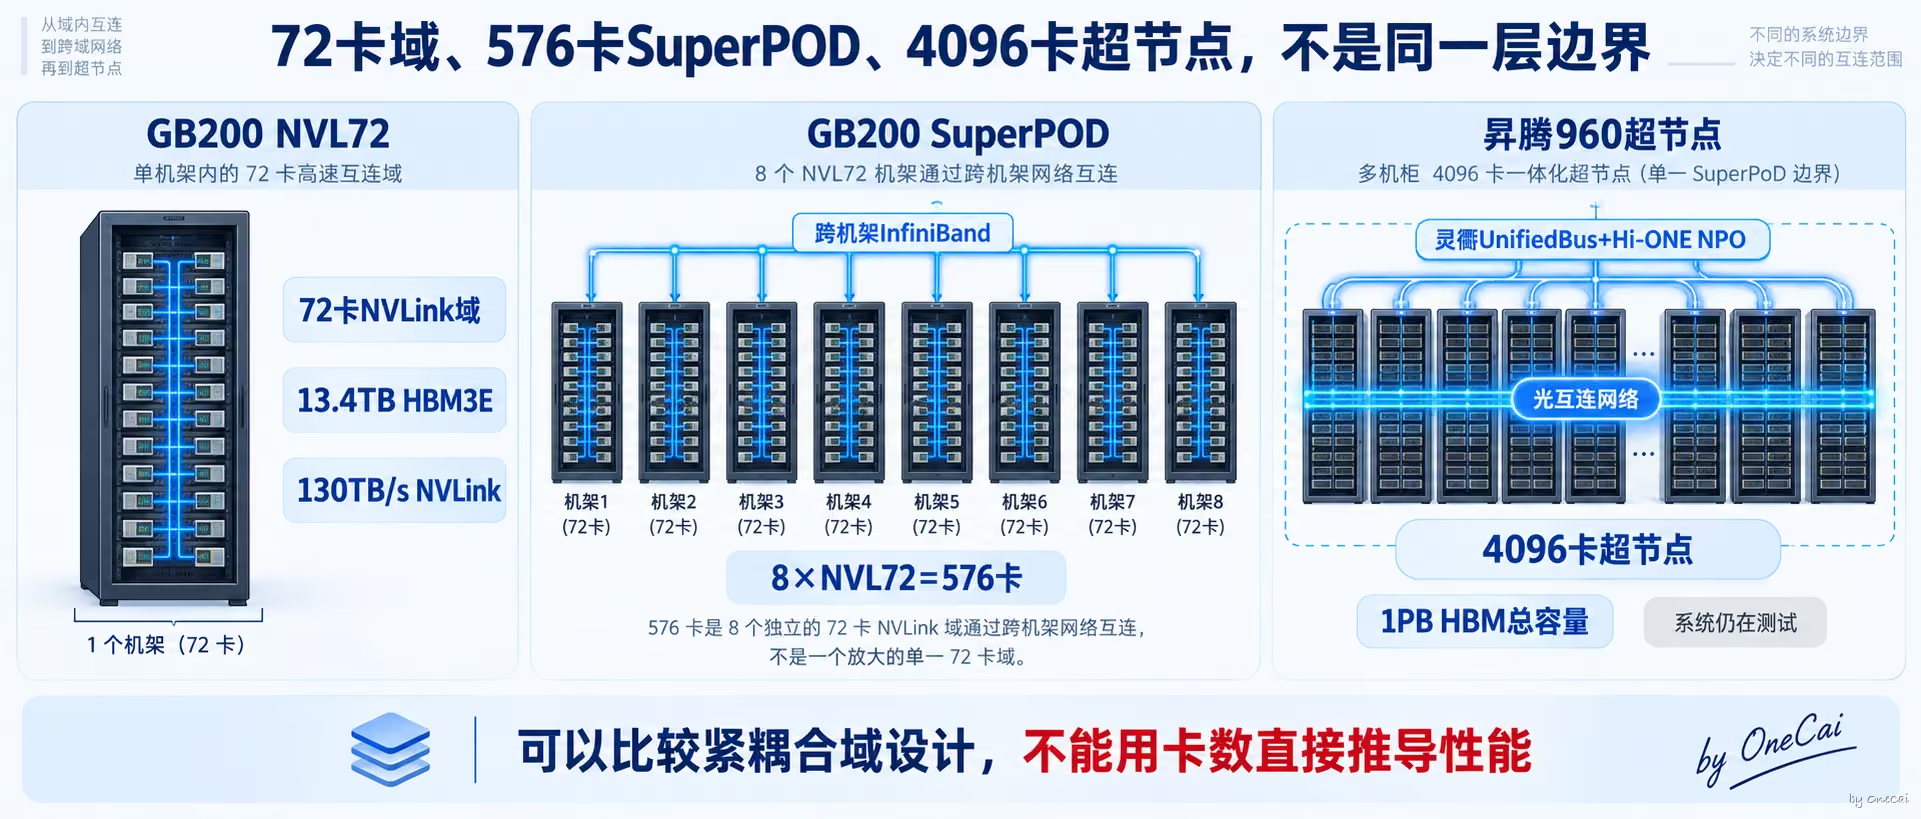
所以,4096和72可以拿来比“单个紧耦合域的设计目标”,但绝不能只用卡数判性能。4096对72,卡数差约57倍,若照此推出“性能强57倍”,就又掉进了之前那篇“6.7倍”里说过的除法陷阱。要真比,至少还得对齐单卡算力、计算精度以及是否用稀疏口径、单卡与全系统内存带宽、域内任意两卡的通信能力、集合通信性能、软件生态、实测吞吐,以及产品状态和交付时间。
还有一层时间错位要说明。GB200 NVL72是英伟达当前已量产的形态,而昇腾960要到2027年才上市,那时英伟达的同代产品是Rubin Ultra(NVL576、Kyber机架,路线图指向2027年下半年)——单机架塞进576个计算die、功耗约600千瓦,路线图算力约15 EFLOPS FP4、5 EFLOPS FP8(均为英伟达路线图口径,未量产)。这里有个坑:英伟达从Rubin代起改了计数方式,“NVL576”数的是die、不是整颗GPU或封装,别和华为的“卡”直接相减。真要放到2027年看,对照其实是“4096张昇腾卡的超节点”对“576个die的单机架”:一个靠数量加光互联在机柜之间铺开,一个靠单die做强、再高密度封进一个机架——这正是“以系统补单卡”和“以单卡打天下”两条路线的正面相遇。
而且,两家其实把“光”用在了不同的层:华为把NPO光互联直接带进scale-up的超节点互联(4096卡跨柜靠光连起来),英伟达当前的scale-up(NVL72的NVLink)仍以铜为主,先把CPO光学用在了scale-out的Quantum-X/Spectrum-X交换机上。谁的路线更划算,不是发布会能定的,还得等2027年两边的实测扩展效率摆出来。
8 EFLOPS离有效算力,还差哪些成绩单?
四层都搭好,也只能说明系统具备了“扩大紧耦合计算域”的条件。8 EFLOPS FP8仍然是峰值算力,不是训练或推理里能持续跑出的有效算力。要判断这4096张卡是不是真像一台计算机在工作,还得等这些数据出来:同模型、同精度下的实测MFU;训练与推理的Token/s;不同并行策略下的扩展效率;128卡、1024卡、4096卡的强扩展与弱扩展曲线;集合通信带宽与尾延迟;长时间训练的故障率和恢复时间;含计算、互联、冷却的整机功率;以及最终的单位Token能耗与成本。这份清单,正是留给MFU那篇旧文和后续收官篇去逐项验的活——这里只点到为止。
结尾:光把规模上限推远了,能不能成一台计算机,还看另外三层
把这台“计算机”拆开看:NPO让高速信号能用更低的互联功耗跨过机柜,把4096卡的物理连接变得可行;UnifiedBus给了统一的通信规则;统一内存编址让软件看到一片连续的资源空间;拓扑、调度和故障恢复再把模型任务映射到这些资源上。缺其中任何一层,4096张卡都只是一份更长的设备清单。
也正因如此,昇腾960最值得盯的,从来不是8 EFLOPS这个峰值数字,而是2027年上市之后——它能不能在4096卡规模下,交出实测MFU、扩展效率、长期可用度和每Token能耗。那几张成绩单出来,才谈得上这台“逻辑计算机”到底有多像一台计算机。
把竞争单位从“一颗芯片”改写成“一台计算机”,是华为这几年最一致的动作;而它成不成,最后还是那句老话——不是“能不能连起来”,而是连起来之后,有效算力兑现了多少。
旁栏:芯片就绪 ≠ 超节点上市,“4096卡”也不是旧路线图的缩水版
这次的口径容易和2025年的路线图搅在一起,单独拎出来说清。
2025年全联接大会徐直军给的路线图:昇腾960芯片原计划2027年第四季度上市;当时规划的Atlas 960 SuperPoD支持15488卡、FP8算力30 EFLOPS、FP4算力60 EFLOPS、内存4460TB、互联带宽34PB/s,计划2027年第四季度上市。作为对照,同期的Atlas 950 SuperPoD是8192卡、8 EFLOPS FP8。
2026年这次的最新口径:昇腾960DT提前至2027年第一季度就绪(比原计划提前三个季度)、960PR2027年第三季度;这次正式发布的是4096卡、8 EFLOPS FP8的NPO昇腾960超节点,风冷、液冷版分别计划2027年Q2、Q3上市;基于NPO的Atlas 960系统目前仍在测试。
两点必须讲清:
- 不能笼统写“昇腾960超节点2027年才上市”就完事,也不能把4096卡这套直接说成15488卡那套的“缩水版”——两者的产品层级和组合关系,华为尚未完整说明,稳妥的写法是“4096卡NPO方案处于测试及后续交付阶段,完整节奏待华为进一步说明”。
- 有个细节反而值得单独点出来:4096卡的昇腾960超节点,FP8总算力8 EFLOPS,和2025路线图里8192卡的Atlas 950总FP8算力持平——卡数减半、总算力不变,这正是“昇腾960单卡性能翻番”最干净的一次实证,也再一次说明“卡数×单卡≠总算力”。
另外,华为披露的“昇腾超节点累计部署超1000套、客户超370家”“昇腾950已规模商用”,说的是既有超节点(910C/950那一代),不是刚发布的960。
资料来源
(发布前请以华为官方与NVIDIA官方页面核定具体数字,下列为查证入口)
- 华为全联接大会2026 · 汪涛主题演讲稿(昇腾960超节点、Hi-ONE、MFU仿真、可用度等口径)
- 华为昇腾960超节点发布稿
- 华为Peerium计算架构发布稿(基于NPO的Atlas 960系统在测试中)
- 华为杨超斌 · 灵衢互联新计算架构演讲(灵衢分层设备:柜内刀片省196公里铜缆、跨柜176端口×1.6T/280T单机、RTT 2微秒、UBG 1024 Radix扇出)
- 华为全联接大会2025 · 徐直军主题演讲稿(Atlas 950/960 SuperPoD路线图:8192卡/15488卡、30 EFLOPS等)
- NVIDIA官方 · GB200 NVL72产品页(72卡NVLink域、130 TB/s、约13.5TB HBM3e)
- NVIDIA官方 · DGX SuperPOD(GB200)参考架构(8×NVL72=576卡、跨机架InfiniBand)
- NVIDIA官方 · Rubin / Rubin Ultra路线图(NVL144、NVL576/Kyber机架,2026–2027,未量产,路线图口径)
- NVIDIA官方 · Spectrum-X / Quantum-X硅光CPO交换机(2026年上半年/下半年,佐证“光进铜退是全行业方向”)
- OIF关于NPO/CPO封装形态的技术材料(区分近封装与共封装)
- 交叉印证:全联接大会2026现场报道(腾讯、网易、凤凰、新浪等)
资料边界说明: 本文涉及的昇腾960超节点规格、Hi-ONE指标、“MFU提升2.75倍”、“降550千瓦”、“可用度99.8%”等,均来自华为公开披露或其实验室仿真,不等同于独立第三方实测;相关产品2027年才上市,最终规格、上市时间与实际性能都可能变化。英伟达GB200相关数据来自NVIDIA及集成商公开资料;Rubin、Rubin Ultra及硅光CPO交换机为英伟达尚未量产的路线图口径,供应链媒体转述的数字更需以发布时的官方页面为准。文中对2025年路线图与2026年最新发布的对照、以及中美两条路线的对照,仅为公开信息整理,不构成性能排名或投资建议。