价格与产品状态核对时间:2026年9月21日。动态价格以智谱BigModel开放平台最新页面为准。
9月18日,智谱上线GLM-5.3-FlashX,最高输出速度200 tokens/s,约为GLM-5.3-Flash的5倍。报道的重点都落在“更快”上。
除了更快,还应该看看价格表的形状。如果FlashX只是让生成这一步变快,最符合直觉的定价应该是输出token涨价,而输入和缓存——它们跟“吐字快不快”没关系——维持原价。
实际不是这样。对着官方价目表逐行看会发现,输入0.8元→2元,缓存命中0.23元→0.57元,输出2.8元→7元。三条价格线,几乎一起乘了2.5。 这怎么连一个还没开始生成、只是被读进去的输入token,以及连一个命中缓存、根本没重算的token,都跟着涨了1.5倍。
这说明FlashX的2.5倍,不是“按你省下的每一秒”精确计费,而是给整个服务档拍了一个统一倍率。 “为速度付费”这个说法,在计费结构上就站不住——你为很多跟速度无关的东西,也一起多付了钱。
所以这篇要问的,不是“快了多少”,而是这2.5倍,到底在给什么定价?
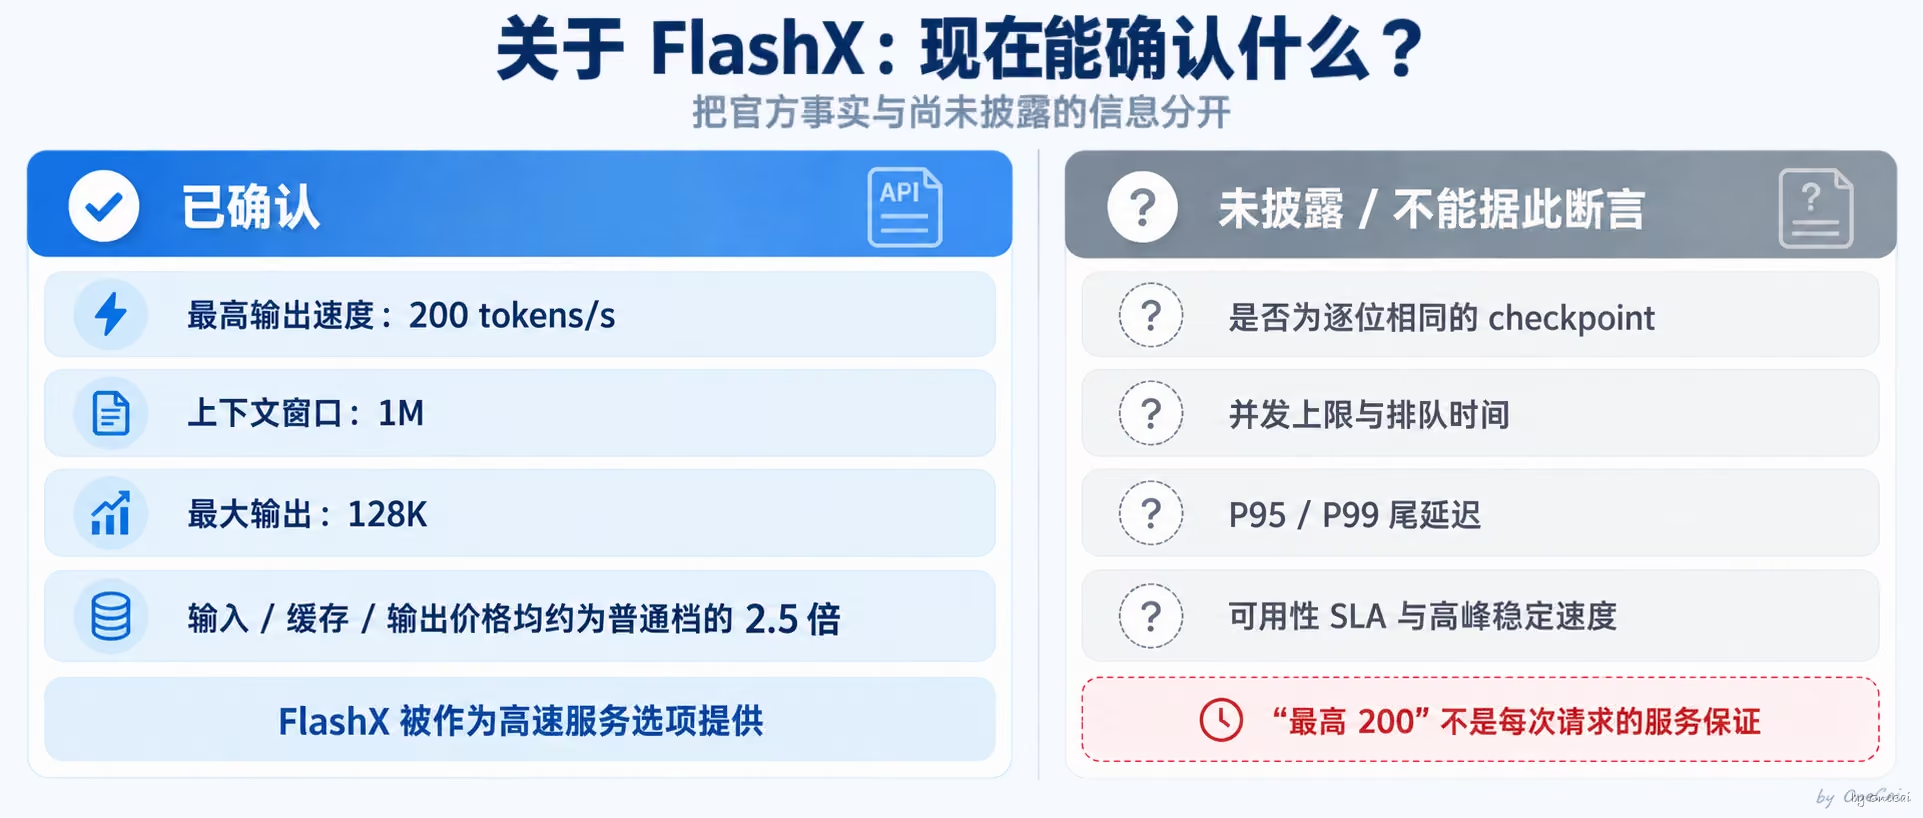
先说清能比什么、不能比什么。FlashX没有单独发布的开源权重,也没有随之公布任何新的能力评测;智谱把它和Flash放在同一个模型页面,共用1M上下文、128K最大输出和相同的输入模态,只是模型代码不同,Vercel的上线说明也把它称作GLM-5.3-Flash的“高速服务选项”。所以能确认的是它把速度当卖点,而不是一次已被验证的能力升级;但这些信息还不足以证明两档跑的是逐位相同的checkpoint,也不保证同一句提示会得到一字不差的答案。至于并发和尾延迟稳不稳、200 tokens/s能不能拿满——官方都没给,后面每用到一次都会标出来,不替智谱脑补。
我之前写过模型能力分档、缓存计费和峰谷定价——厂商在给能力定价、给Token结构定价、给交付时段定价。FlashX加的是最直白的一种:同一套能力,摆出普通档和高速档两个价,让你自己挑速度。
一、先把已经确认的差别列出来
按9月18日公开的国内价格表,两档服务的差别如下:
| 项目 | GLM-5.3-Flash | GLM-5.3-FlashX |
|---|---|---|
| 模型代码 | glm-5.3-flash | glm-5.3-flashx |
| 上下文窗口 | 1M | 1M |
| 最大输出 | 128K | 128K |
| 输入模态 | 文本、图片、视频、文件 | 文本、图片、视频、文件 |
| 输入价 | 0.8元/百万tokens | 2元/百万tokens |
| 缓存命中输入 | 0.23元/百万tokens | 0.57元/百万tokens |
| 输出价 | 2.8元/百万tokens | 7元/百万tokens |
| 公开速度口径 | 由“5倍”反推的比较基线约40 tokens/s | 最高200 tokens/s |
表里有两个边界需要提前说明。约40 tokens/s只是根据“最高200 tokens/s、约为普通版5倍”反推出来的比较基线,不是普通Flash全天稳定速度。200 tokens/s同样是最高值,不是每次请求都能拿到的服务保证。
另外,智谱没有公开FlashX的并发上限、排队时间、P95/P99延迟或可用性SLA。现在可以比较价格和最高输出速度,不能据此宣称FlashX在高峰期一定不卡,或者高并发一定更稳。
二、200 tokens/s不等于全部等待时间
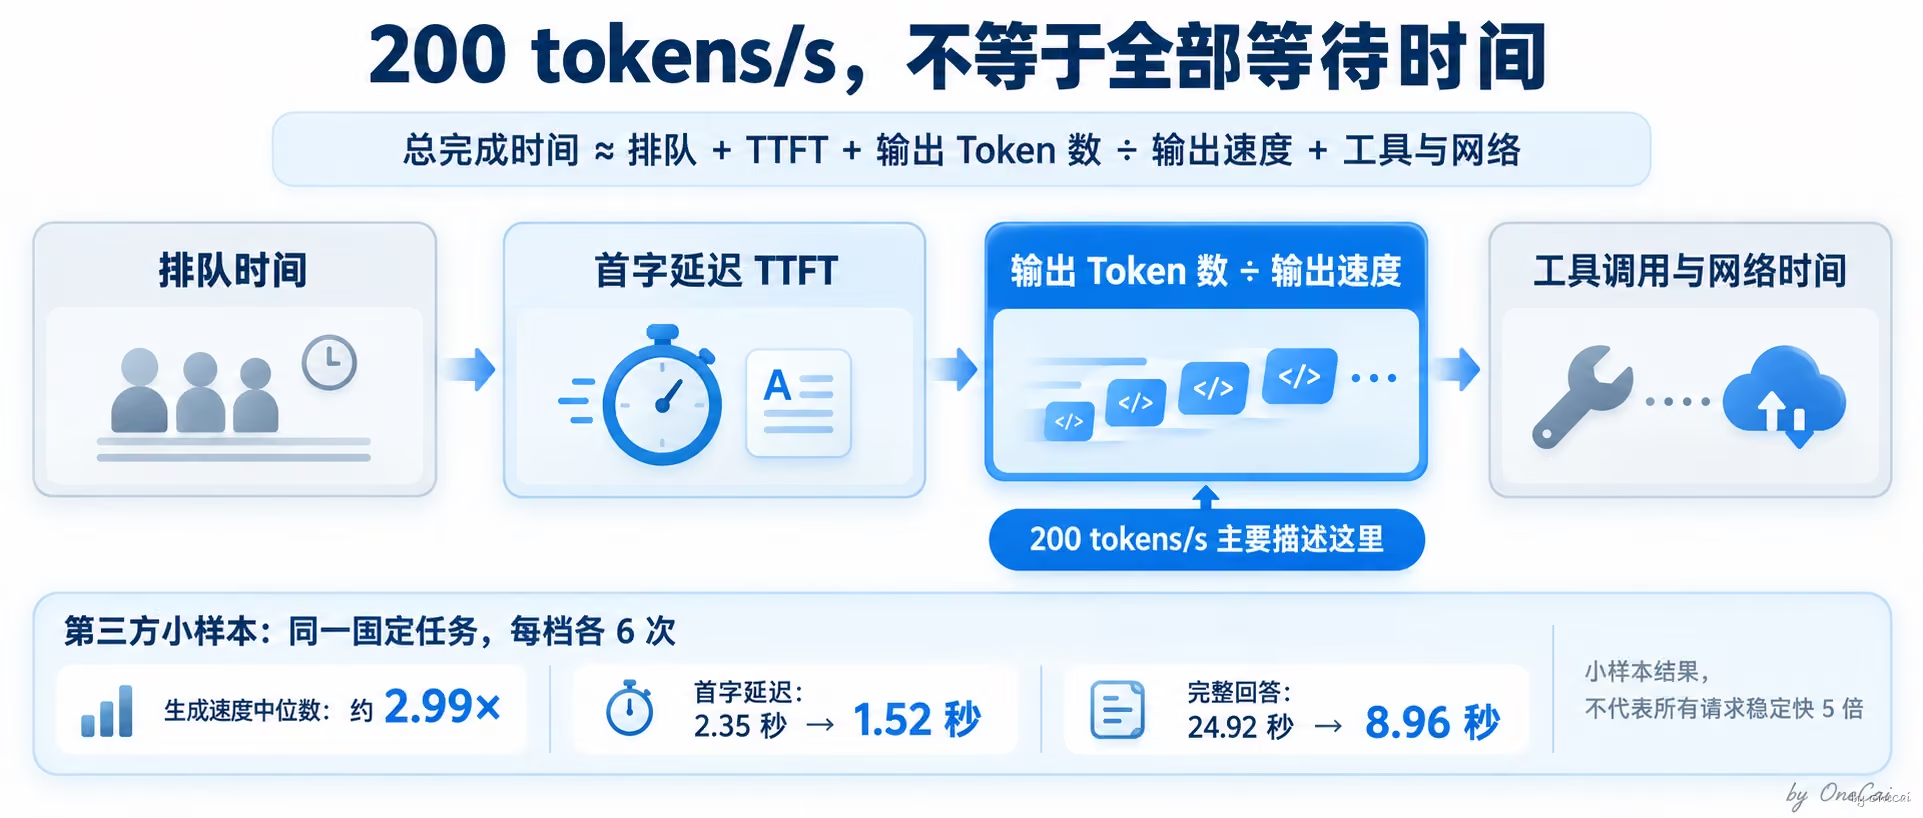
用户看到的等待时间,大致由四部分组成:
| |
200 tokens/s主要描述开始生成后的输出速率。在长回答里,这一项会明显影响完成时间;而在短回答、长输入或多工具Agent里,排队、首字延迟和外部工具可能占掉更多时间。
一组第三方小样本测试能说明这种差别。测试者让Flash和FlashX交替执行同一个固定输出任务,每档各跑6次。FlashX的生成速度中位数约为普通Flash的2.99倍,首字延迟从2.35秒降到1.52秒,完整回答时间从24.92秒降到8.96秒。这个结果证明同一任务里确实能感受到提速,但不能把它扩大成“所有请求稳定快5倍”。测试提示词、时间段、推理强度和流式统计方式都会改变结果。
所以,这张价目表卖的是一个高速服务档,最终省下多少等待时间,仍要回到自己的请求链路里测。
三、这2.5倍能不能反推出成本?
开头那个反常——只有输出变快,输入和缓存却跟着涨——这一节把它说透。三条价格线一起乘2.5,意味着这不是“按每个阶段省了多少秒”精算出来的价,而是给整个服务档拍的一个统一倍率。既然是统一倍率,它就不能倒过来当成“成本涨了2.5倍”的证据。
厂商为什么这样定价,公开资料没有给出成本表,能看到的只有技术方向。智谱为GLM-5.3-Flash搭建了专用推理引擎,并公开介绍了张量并行、W8A8量化、混合缓存量化和Encode、Prefill、Decode分离调度等做法。这些技术可以改善推理效率,但智谱没有说明FlashX相对普通Flash具体调整了哪几项,也没有公布两档服务的batch大小、资源分配和调度优先级。
因此,不能从2.5倍价格反推出硬件成本也增加了2.5倍,更不能把差价直接解释成小批处理、资源预留或利润。价格首先是产品规则,成本只决定这条规则能不能长期维持。
四、多花的钱买到了什么
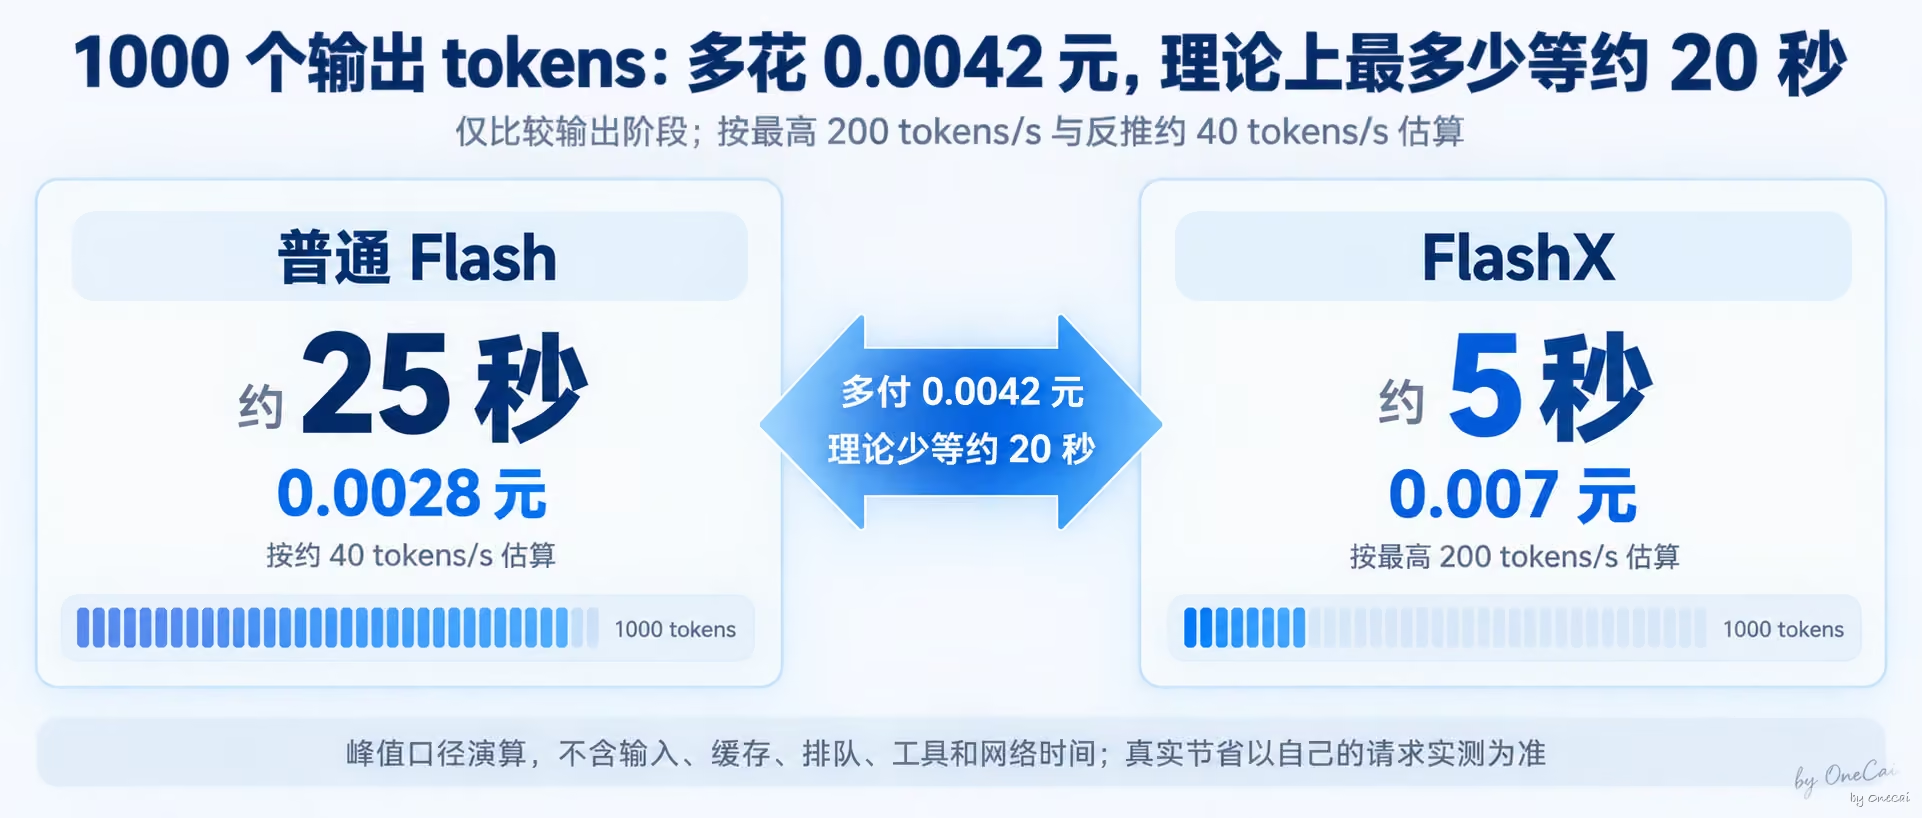
只看输出部分,账很好算。假设一次任务生成1000个输出tokens,暂时不计输入费用:
| 普通Flash | FlashX | |
|---|---|---|
| 输出费用 | 0.0028元 | 0.007元 |
| 按40/200 tokens/s估算的生成时间 | 约25秒 | 约5秒 |
在这组厂商口径下,多花0.0042元,最多可以少等约20秒。这里用的是“最高200、反推40”这套峰值口径,和第二节那组实测(完整回答24.92秒→8.96秒,约3倍而非5倍)对不上是正常的——峰值口径只用来看“速度换价格”的理论交换比,真实节省要以实测为准。这个演算隔离了速度与输出价格,只用于看二者的交换关系,不是一张真实账单。真实调用还要加上输入、缓存、排队和工具时间,实际速度也未必达到峰值。
对单次调用来说,几厘钱的差价很小。调用量上去后,判断标准就不再是“2.5倍贵不贵”,而是缩短的时间能不能转成业务价值。
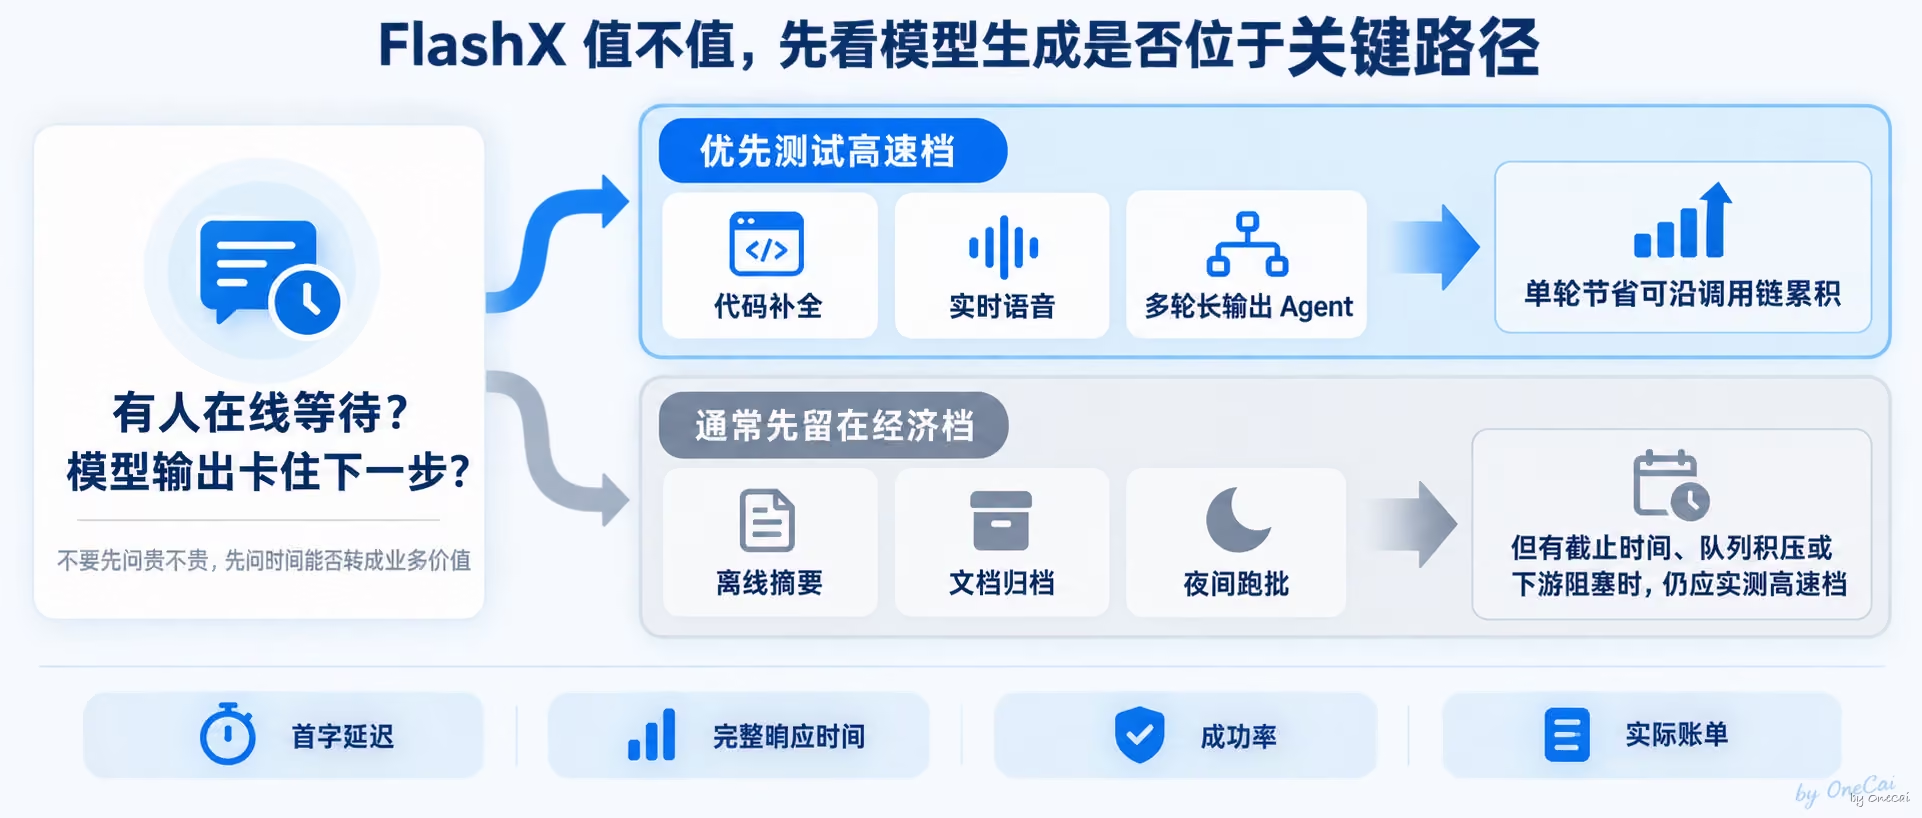
代码补全、实时语音和长输出Agent更可能受益。代码补全要求结果及时出现,语音交互不能长时间停顿,多轮Agent还要等上一轮输出完成才能进入下一步。只要模型生成确实位于关键路径,单轮节省的时间就会沿调用链累积。
离线摘要、文档归档和夜间跑批通常更看重总成本。不过“离线任务不需要速度”也不能说死。任务有交付截止时间、队列正在积压,或者更快完成能释放下游资源时,高速档仍可能有价值。
上线前最好在自己的代表任务上同时记录四组数:首字延迟、完整响应时间、成功率和实际账单。官方最高速度只能帮助筛选候选模型,不能代替这组实测。
五、API正在从模型价目表变成服务价目表
按服务速度分档并不是行业第一次。OpenAI已经提供Default、Flex、Priority和Batch等处理层级,不同层级对应不同的处理方式、交付时间和价格。FlashX值得关注,是因为它把普通档与高速档直接做成两个模型代码,速度和价格差异一眼就能看见。
把几篇价格文章放在一起,大模型API已经出现了几条彼此独立的计费维度:
- 模型能力决定基础单价;
- 缓存命中、输入和输出决定Token结构;
- 峰谷和Batch决定什么时候交付;
- FlashX这类高速档决定以什么速度交付。
开发者面对的不再只是“选哪个模型”,还要给任务分流。有人在线等待、模型输出位于关键路径的请求,可以测试高速档;能排队、能批量、对截止时间不敏感的任务,继续留在经济档。
写在最后
GLM-5.3-FlashX目前能够确认的价值,是最高输出速度达到200 tokens/s。它没有公开并发SLA,也没有公布高峰期尾延迟,更没有一张可以把2.5倍价格拆成硬件、调度和利润的成本表。
这并不妨碍它成为一个清晰的产品信号:模型能力、Token用量和交付速度正在被拆成不同的价格维度。以后比较两个API,只看输入价和输出价会越来越不够,还要把首字延迟、完整响应时间、任务成功率和人工等待一起放进账本。
FlashX值不值,最后取决于一个具体问题:在你的任务里,模型生成到底占了多少时间?