本文属于「术语解构」系列。数据核验于2026年9月29日,厂商规格、社区实测和作者估算分开标注,边界见文末。
9月28日,极摩客发布了一台叫EVO-X5 Pro的迷你主机,官方管它叫“桌面AI超算”。192GB内存,早鸟价6599美元,按当天汇率约4.4万元。宣传页上最显眼的一句是离线运行最高320B参数的大模型。同一天,铭凡用同一颗芯片的MS-S1 MAX-P495在国内开卖,限时价51999元。
看到320B这个数,我第一反应是拿笔算了一下,320B × 4bit ÷ 8 = 160GB。翻到规格表,“GPU最多可动态分配内存”那一行,写的也是160GB。
先别急着说严丝合缝。这两个160的口径并不一样。前一个是按十进制字节算出来的权重体积,160GB约等于149GiB;后一个是厂商写在规格表里的内存容量,官方没有进一步说明它对应多少可用字节。两个数字可以拿来判断“已经逼近容量边界”,却不能直接相减,算出一个精确余量。
再往下看一行,内存带宽273GB/s。这个数比较熟悉,24GB的MacBook也是273GB/s。
一台4万多块、192GB内存的机器,和一台24GB的笔记本,往外生成token的那根水管一样粗。那多花的钱到底买到了什么?“能跑320B”又是什么意思?
这篇拆三本账:装得下吗,跑多快,以及为什么它确实有能用的场景。
一、先把宣传语读完整
同一颗AMD锐龙AI Max+ PRO 495,三家的说法不太一样:
- 极摩客:最高支持320B参数的离线推理,后面紧跟一句,实际兼容性和性能取决于所选模型、软件、量化方式、负载和系统配置。
- AMD官方博客的脚注:495最多可分配160GB专用图形内存,能运行4bit量化下300B以上参数的模型。
- CHUWI同芯片产品:4bit量化下最多300B。
有个细节挺有意思。极摩客自己在发布稿里写了,这台机器最初的设计目标是300B,开发后期经过调优才提到320B。它9月中旬的预热文章,标题里写的也还是300B。
300B和320B只差20B,按理想4bit换算是10GB十进制数据。对一台图形内存额度标称160GB的机器,这不是可以忽略的差别;至于它具体吃掉了多少可用余量,还要看量化格式、容量口径和运行时开销。
以后看到任何“能跑XXB”的宣传,可以先追问四件事:
| 看到“能跑XXB”时要追问 | 它决定什么 |
|---|---|
| 是Dense还是MoE?每个token激活多少参数? | 生成速度,可能相差一个数量级 |
| 用什么量化格式?实际几bit? | 权重体积多大,能不能装下 |
| 权重加载后还剩多少可用内存? | 上下文能开多长,能不能并发 |
| 固定上下文、固定推理后端下,实测多少token/s? | 能不能进入日常工作流 |
目前,三家都没有公开具体模型名、量化文件、上下文长度和实测速度。现有公开信息能支持的结论是,某种配置下,320B模型可以被加载并运行。它还不足以回答速度、上下文和稳定性。
二、第一本账:192GB,真正能给模型用的有多少
192GB要拆三层看。整机的CPU、GPU、NPU共用一个内存池,这就是统一内存。厂商写明最多160GB可以动态分配给GPU,剩下的留给操作系统和CPU。模型加载进来以后,还要为推理框架、计算缓冲区和KV Cache腾地方。
然后是“4bit”这个词。开头算式里的4bit是理想值。常见量化格式还要保存缩放系数等元数据,有效位宽通常比名字上的数字大。llama.cpp量化工具给出的参考中,Q4_K_M大约落在4.8到4.9bit,Q3_K_M大约在3.8到3.9bit,具体体积会随模型结构变化。
把这些位宽放到320B上,先只算权重,不假装知道机器最终会显示多少可用空间:
| 量化格式 | 每参数有效位宽 | 权重体积,十进制 | 换算成二进制约为 | 能说明什么 |
|---|---|---|---|---|
| 理想4bit | 4.0bit | 160GB | 149GiB | 与160GB图形内存标称值非常接近,实际余量未知 |
| Q4_K_M | 约4.8–4.9bit | 约192–196GB | 约179–183GiB | 超过160GB图形内存额度,不能完整放入该分配区 |
| Q3_K_M | 约3.8–3.9bit | 约152–156GB | 约142–145GiB | 理论权重小于160GB标称值,仍需预留运行时空间 |
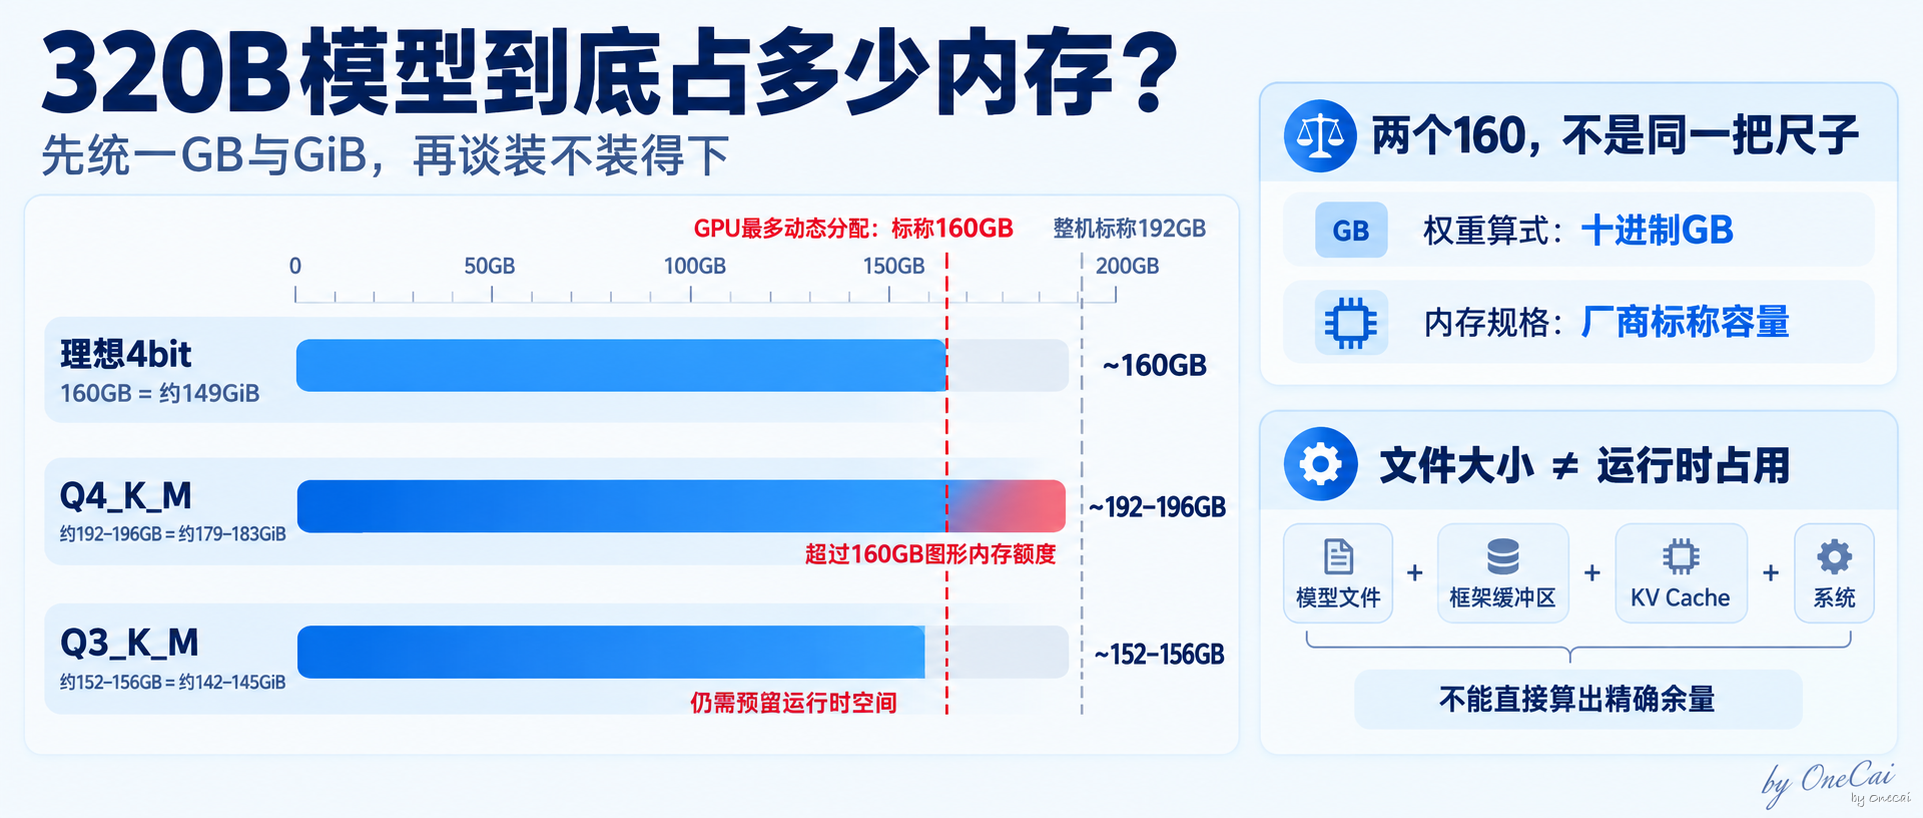
这张表刻意没有“剩余多少GB”一栏。厂商没有公布160GB分配上限的精确字节口径,更没有公开320B演示所用的模型文件和加载后占用。把十进制权重体积直接从内存标称值里扣掉,会得到一个看起来很精确、实际上口径不统一的答案。
Q3_K_M有个现实参照。Qwen3-235B-A22B的社区Q3_K_M文件为104.72GiB,反推下来每参数约3.8bit。不过,GGUF会混用不同精度的张量,同一个量化名字落到不同模型上,体积会有出入,不能据此断言任何320B模型做成Q3_K_M都会得到同一个文件大小。
如果限定在160GB图形内存分配区,采用常见GGUF K量化并给运行时留空间,Q4_K_M大概率装不下,Q3级格式更稳妥。但这仍是按公开格式做的推算。厂商也可能用了其他4bit格式、共享内存调用或针对特定MoE模型的推理方案。在演示模型和配置公开之前,“只能用3bit”说得太满。
模型权重装进去以后,另一块大开销是KV Cache。
我在《KV Cache:每读1个token,就要交一笔“显存税”》那篇里讲过,模型每读一个token,都要保存它在各层注意力计算中的K和V。上下文越长,这块缓存越大。
目前我找不到极摩客320B演示模型的公开配置,不能替它编一个KV Cache数字。这里用结构公开的Qwen3-235B-A22B看数量级。它有94层,4个KV头,每个头128维。按16bit保存,每个token的KV Cache约为:
2(K和V)× 94 × 4 × 128 × 2字节 ≈ 19万字节
8K上下文约1.6GB,32K约6.3GB,开到配置文件里的原生上限40960个token,约7.9GB。实际占用还会受缓存精度、推理框架和并发数影响,不少框架也能把KV Cache压到8bit甚至4bit。
社区在上一代128GB的395机器上加载过Qwen3-235B-A22B的Q3_K_M。模型文件是104.72GiB,测试记录显示,运行时占用了123GB可用内存中的约121到122GB,只剩1到2GB。这里保留测试者的原始单位,不把GB和GiB混在一起。测试者也提醒,长对话可能会爆内存。
文件多大,和跑起来要多大,是两个数。
因此,“能跑320B”至少还缺三个条件——实际量化格式、加载后的内存占用、演示时的上下文长度。若限定在160GB图形内存额度、使用常见K量化并预留运行时空间,Q3级方案更容易实现;厂商是否用了这条路线,目前没有公开答案。
三、第二本账:装进去以后,一秒生成多少token
大模型生成文字,是一个token接一个token地解码。在本地单用户、常规自回归推理下,可以近似理解为:每生成一个token,都要从内存流式读取参与这一轮计算的主要权重。计算单元再快,数据送不到也只能等。
因此,生成速度可以先用一个朴素公式估上限:
生成速度上限 ≈ 内存带宽 ÷ 每个token需要读取的权重字节数
把三台设备摆在一起看:
| 设备 | 内存容量 | 标称带宽 |
|---|---|---|
| 极摩客EVO-X5 Pro | 192GB | 273GB/s |
| NVIDIA DGX Spark | 128GB | 273GB/s |
| MacBook Pro M4 Pro | 24GB | 273GB/s |
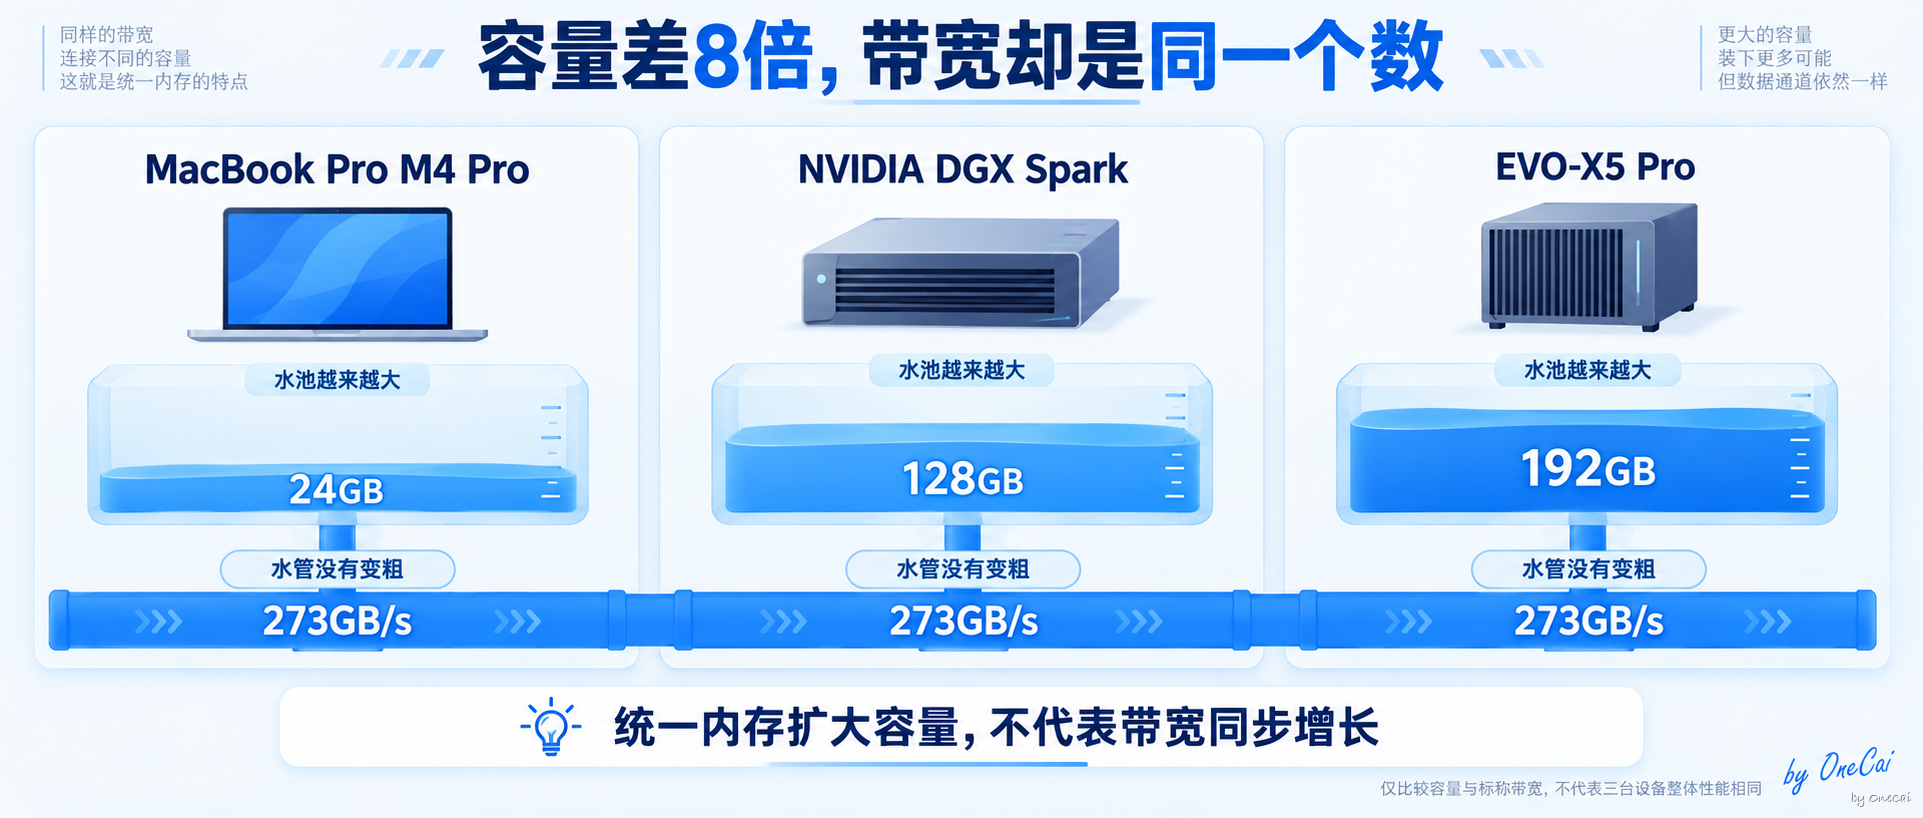
三台机器的水管一样粗,水池大小不同。
这不代表它们性能一样,GPU架构、计算单元和软件栈都会影响速度。表格能说明的是,EVO-X5 Pro增加了容量,标称带宽没有按同样的比例上涨。实际有效带宽通常还低于标称值,社区在上一代395上测到的可用带宽约230GB/s,标称值是256GB/s。
这根水管实际能流过多少水,在MacBook上测了一次。
模型是Qwen3.8-27B,IQ4_XS量化,文件14.62GiB,约15.7GB。工具是llama.cpp的llama-bench,和后面引用的395社区测试使用同一套指标。这个模型含线性注意力层,但不是MoE,生成时仍会用到全部权重。若把模型文件大小当作每个token所需读取字节数的代理,理论上限约为:
273 ÷ 15.7 ≈ 17.4 token/s
实测生成速度为12.69 token/s。按文件大小反推,等效权重吞吐约为199GB/s,相当于标称带宽的73%左右。这里的199GB/s不是硬件工具测出的实际内存带宽,只是一种便于比较的估算,模型文件里的元数据、计算和调度开销都被一起折算进去了。
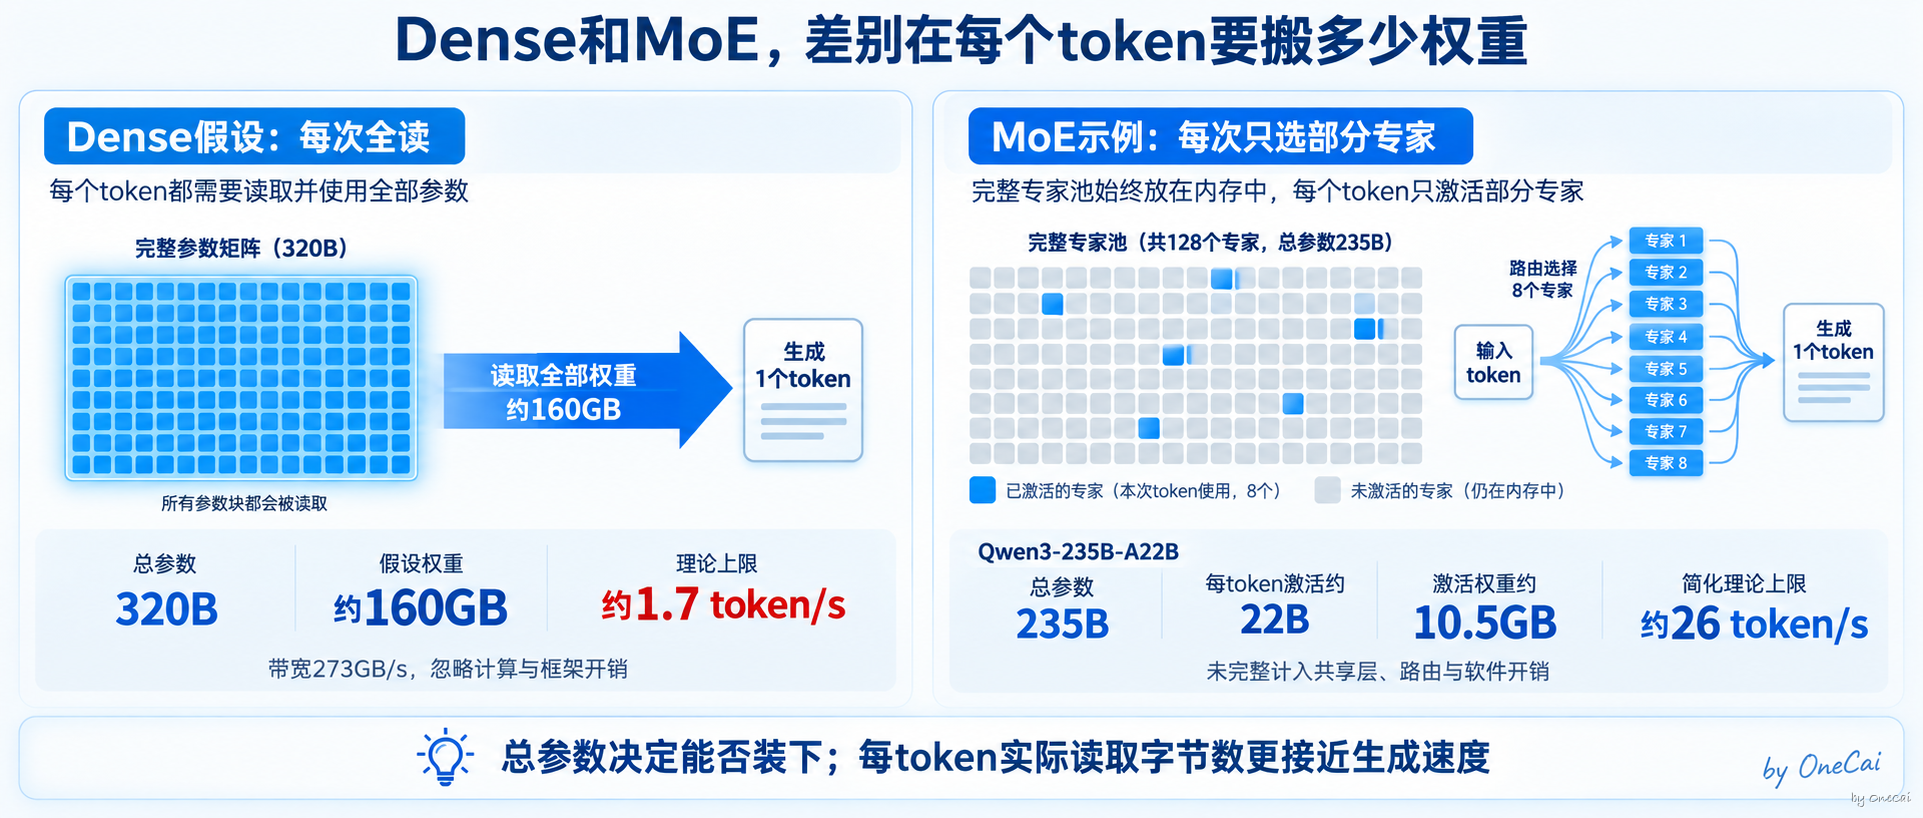
假如一个320B模型是Dense结构,而且量化后权重正好为160GB十进制,那么忽略计算和框架开销时,生成速度上限约为:
273 ÷ 160 ≈ 1.7 token/s
这是Dense假设下的算术,不是EVO-X5 Pro实测。对常规单批次解码来说,实际速度通常还会低于这个理想值,也不能把token直接换成汉字,说成“一秒只能吐1.7个字”。
生成之前还有一段等待。模型要先处理完整输入,这一步叫预填充(prefill),它更依赖计算能力,不能只看内存带宽。
同一份社区测试里,上一代395运行Qwen3-235B-A22B的Q3_K_M,两个推理后端的结果正好反过来:
| 推理后端 | 预填充 | 生成 |
|---|---|---|
| Vulkan | 约101 token/s | 约17.2 token/s |
| ROCm HIP | 约170 token/s | 约14.3 token/s |
一个读输入更快,一个生成更快。按这组速度线性外推,输入1万token的长文档,首个token要等约1分钟到1分半。这是从512 token测试推出来的数量级,不是长上下文实测;上下文变长以后,缓存、调度和算子表现都可能变化。
笔记本电脑运行27B模型时,预填充是118 token/s。按同样方法外推,处理1万token也要接近一分半。两个模型不同,不能拿结果直接排名,但这足以说明,几百B模型的交互体验不能只看生成速度。
一台机器快不快,至少要同时报告预填充、生成、上下文长度和推理后端。少一个条件,数字就很难复现。
四、第三本账:MoE为什么更适合这类机器
如果故事停在Dense假设下的1.7 token/s,这台机器很难进入日常工作流。几百B级开放权重模型中,MoE已经是一条常见路线。
Dense模型每个token都要调动全部参数。MoE把参数拆成很多个专家,每个token只挑一部分参与计算。Qwen3-235B-A22B有128个专家,每个token激活8个;总参数是235B,每个token的激活参数约22B。
大内存可以把全部专家留在本机,稀疏激活让每一步只搬动其中一部分数据,这正好贴合大容量、中等带宽的硬件。
用同一个公式做粗略估算。22B按3.8bit计算,激活权重约10.5GB,对应的理想上限是:
273 ÷ 10.5 ≈ 26 token/s
这个算法没有把共享注意力层、路由和其他非专家参数完整算进去,所以26 token/s只能看作乐观上限。它仍然说明了一件事——同样是两三百B总参数,Dense和MoE每步需要搬动的数据可能相差一个数量级。
上一代395的两份社区记录,也能看到软件栈的影响:
- 一份公开测试仓库把模型完整放进GPU,Vulkan后端生成约17.2 token/s。回复300个token需要17到21秒。
- 另一位测试者使用同样的Q3_K_M,只测到7.8 token/s。
第一组17.2 token/s约为简单带宽上限的七成,MacBook实测也碰巧落在73%左右。但两台机器、两个模型和两套软件环境远不足以归纳出“统一内存机器通常都有七成效率”,这里最多把它当作两个可供参照的样本。
第二组为什么慢了一倍?测试记录写得很清楚,模型95层里只有80层放进GPU,其余层经过一条约85GB/s的数据通道。更早的时候,ROCm默认只允许GPU使用约61GB内存,测试者修改内核参数后才放开到约90GB。
同样的硬件,软件配置已经足以让速度相差一倍。买回这类机器以后,驱动、后端和内核参数都可能进入成本清单;内存从128GB加到192GB,不会自动抹平这些差异。
再往上一档,Qwen3.5-397B-A17B已经超出单机容量。社区用两台395通过RPC联跑,生成约11.76 token/s,证明多机路径可以工作。不过,同一项目也记录了部分输入形状和较长上下文下的RPC不稳定问题。它更像可行性验证,还不是开箱即用的生产方案。
这又回到我在《本地模型别只看总参数:稠密和稀疏差别很大》讲过的判断:参数量不等于算力。总参数先决定权重能不能装下;在MoE单token解码里,激活权重字节数和有效带宽与生成速度的关系更直接。粗略写成公式就是:
生成速度上限 ≈ 有效带宽 ÷ 每个token实际读取的权重字节数
用“激活参数×有效位宽÷8”可以做第一步估算,但共享层、路由、缓存和软件开销仍要单独考虑。宣传语给出的总参数很重要,只是它一个数字还不足以描述速度。
五、4.4万块买到的到底是什么
这台机器真正的价值,是能把几百B级的MoE模型完整留在一个盒子里。一张RTX 5090有32GB显存,要容纳150GB以上的权重,需要多张卡、能插下它们的主机、电源和散热,还要处理模型切分。统一内存把这套容量压进了一台迷你主机。数据不出门,断网也能运行,极摩客还称机器通过了7×24小时连续运行验证。
Mac Studio、多GPU工作站和上一代Strix Halo已经能做大内存本地推理,EVO-X5 Pro带来的变化,是把192GB统一内存放进x86迷你工作站这一形态。对涉密资料、内部代码和需要常驻的本地Agent来说,它多提供了一种选择,前提是使用者愿意调软件栈。
如果期待的是和ChatGPT一样顺手的交互体验,这4万多块可能会让人失望。云端服务可以调动批处理、推测解码、缓存和成规模的并行资源,单台桌面机器只能覆盖其中一部分。EVO-X5 Pro容量很大,273GB/s的带宽仍然限定了单用户解码的上限。
也别急着拿6599美元除以某家API的每百万token价格,算一个“几年回本”。没有EVO-X5 Pro的真机吞吐、功耗和实际任务数据,这两个价格缺少共同的比较基线。4.4万元主要买到的是容量、控制权和离线能力,不是已经被证明更便宜的token。
写在最后
开头那两个160GB都没有骗人,一个来自权重的理想4bit算式,一个来自厂商的内存规格。问题出在把不同口径的数字当成同一把尺子,再顺手算出“零余量”。
现有公开资料足以说明,统一内存让几百B级模型进入了单机迷你工作站。它没有告诉我们具体320B模型的量化格式、上下文长度和速度,更没有证明4万元买来的是云端服务那样的交互体验。
这类机器可以记住一句话,统一内存拆掉的是独立显存的容量墙,没有同步拆掉带宽墙。
顺便说个小细节。这台主打离线运行大模型的机器,限量30台超级早鸟版的赠品,是Z.AI三个月Coding Plan,一份云端编程订阅。我就不替厂商解释了。
下一篇我来算另一笔账,为什么192GB让这类迷你主机一下贵到四五万元,多出来的64GB内存到底值多少钱。
资料边界说明
本文资料核验日期为2026年9月29日。产品价格、汇率、驱动和推理软件仍可能变化,文中的社区成绩与作者实测只对应各自列出的硬件和配置。
一手官方资料
- 极摩客EVO-X5 Pro官方发布页(192GB LPDDR5X-8533、273GB/s、最多160GB图形内存、320B表述及免责条件、300B原设计目标、7×24运行验证、价格与早鸟赠品):https://www.gmktec.com/blogs/news/gmktec-evo-x5-pro-officially-launched-192gb-of-memory-amd-ryzen%E2%84%A2-ai-max-pro-495-and-offline-320b-ai
- 极摩客9月15日预热文章(标题为300B):https://www.gmktec.com/blogs/news/gmktec-evo-x5-pro-the-next-generation-agentic-pc-with-192gb-memory-and-local-300b-ai
- AMD官方博客(Ryzen AI Max PRO 400系列规格,脚注GRHP-01关于160GB和4bit量化300B以上参数的表述):https://www.amd.com/en/blogs/2026/amd-powers-next-generation-agent-computers-with-new-ryzen-ai-hal.html
- CHUWI UniBox AI495 Pro官方页面(同芯片192GB内存、160GB图形内存、273GB/s、4bit下最高300B):https://store.chuwi.com/pages/unibox-ai495-pro
- Qwen3-235B-A22B模型配置文件(94层、4个KV头、128维、128个专家、每token激活8个、原生上下文40960):https://huggingface.co/Qwen/Qwen3-235B-A22B/raw/main/config.json
- llama.cpp量化工具文档(各K-quant格式的有效位宽):https://github.com/ggml-org/llama.cpp/tree/master/tools/quantize
- Apple 2024年10月30日M4 Pro与M4 Max发布新闻稿(M4 Pro内存带宽273GB/s):https://www.apple.com/newsroom/2024/10/apple-introduces-m4-pro-and-m4-max/
- NVIDIA DGX Spark官方规格页(128GB LPDDR5x统一内存、273GB/s;官方称可推理最高200B参数模型):https://www.nvidia.com/en-us/products/workstations/dgx-spark/
第三方媒体
- IT之家:极摩客EVO-X5 Pro发布及人民币换算:https://www.ithome.com/1/007/863.htm
- IT之家:铭凡MS-S1 MAX-P495国内售价:https://www.ithome.com/1/007/787.htm
社区实测,均为上一代Ryzen AI Max+ 395,并非495
- strix-halo-llm-perf测试记录(Qwen3-235B-A22B Q3_K_M:文件104.72GiB,运行时占用123GB可用内存中的121–122GB;Vulkan预填充101 token/s、生成17.2 token/s;ROCm HIP预填充170 token/s、生成14.3 token/s;300 token回复约17–21秒;长对话可能爆内存):https://github.com/visorcraft/strix-halo-llm-perf/blob/main/BENCHMARKS.md
- strix-halo-llm-perf双机结果(Qwen3.5-397B-A17B,ROCm+RPC约11.76 token/s;项目同时记录了部分输入形状和较长上下文下的稳定性问题):https://github.com/visorcraft/strix-halo-llm-perf
- Strix-Halo-Models(Qwen3-235B Q3_K_M约7.8 token/s,95层中80层放入GPU,约85GB/s数据通道;ROCm默认GPU内存约61GB,修改内核参数后约90GB):https://github.com/apellegr/Strix-Halo-Models
- strix-halo-windows-llm-bench(实际可用带宽约230GB/s):https://github.com/ihanesman/strix-halo-windows-llm-bench
作者实测
- 设备:MacBook Pro M4 Pro,24GB统一内存,iogpu.wired_limit_mb=21504
- 模型:unsloth/Qwen3.8-27B-GGUF,IQ4_XS(4.25bpw),文件14.62GiB,参数27.32B;该模型含线性注意力层,属混合结构,但不是MoE,生成时仍会用到全部权重
- 工具:llama.cpp llama-bench,Metal后端,源码编译(build 526c43b),2026年9月29日测试;Homebrew版(ggml 0.10.0)无法加载该模型
- 结果:pp512 118.29±5.62 token/s,tg128 12.69±0.51 token/s,重复3次
- 理论上限17.4 token/s、效率约73%、等效权重吞吐约199GB/s,均为作者按模型文件大小推算,不是硬件带宽测量值
作者推算,不是EVO-X5 Pro实测
- 320B在不同有效位宽下的理论权重体积;GB与GiB分别列出,不用它们计算精确剩余空间
- Qwen3-235B-A22B的KV Cache占用,按官方配置和16bit缓存计算;实际占用还受缓存精度、框架和并发影响
- Dense假设下1.7 token/s、MoE简化假设下约26 token/s,均为单用户、忽略部分计算和软件开销的带宽上限
- 1万token输入的首个token等待时间,由512 token测试线性外推,不是长上下文实测
- 以上估算只用于判断数量级,不代表EVO-X5 Pro的实际表现