本文是上下文这条线的第四篇。《上下文窗口:标称1M的token,为什么32K就开始变笨》讲的是能力上限,《KV Cache:每读1个token,就要交一笔“显存税”》讲的是硬件上限,《长上下文是不是越贵越好?》讲的是哪些任务值得为长上下文买单。这一篇补上最后一条:价格门槛,再把几条线落到一个具体问题上——到底该设多长。
前几篇的评论区里,有三个问题适合放在一起回答:
“实战中到底推荐设置多长,性价比最高?”
“DeepSeek V4、Gemini 3.5这些最新模型,上下文设多长能保证效果?”
“Qwen3.6-35B接近200K时开始无限重复。”
背后是同一个困惑——模型已经支持几十万、上百万token,是不是把窗口开大、材料放全,就能少操心?
先看一笔账。调用阿里云百炼的qwen3.6-plus,输入25万token、计费输出固定为2万token:0.25×2元+0.02×12元=0.74元;输入加到30万,输出不变:0.30×8元+0.02×48元=3.36元。通过两个比较发现,材料只多塞了20%,账单变成原来的4.5倍。
原因是跨过了256K这道计价门槛,整次请求的输入、输出都换了单价。这笔账用的是百炼华北2(北京)地域的实时调用价格,不含缓存折扣和免费额度;换一个输出长度,倍数也会跟着变。
所以这篇不给一个适用于所有模型的标准答案。我们看三条线:模型能不能用好这些材料、云端请求会不会跨过涨价线、本地机器装不装得下。先保留完成任务所需的证据,确认窗口和内存容纳得下,再判断增加的费用是否值得。下面这张起点表和检查方法,都按这个顺序来。
一、“设多长”,其实是三件事
很多人问“上下文该设多长”,混在一起的其实是三个数字。
第一件,模型官方支持的最大窗口。规格页上的262K、1M,是接口允许处理的上限。这个窗口里,输入、输出、思考过程往往要一起分,不能把它全当成能上传材料的容量。
第二件,每次请求实际带进去多少token。系统提示词、你的问题、附件原文、聊天历史、工具返回的结果,都算输入。输入费用按实际计费token数和适用单价计算,此外还要计输出、工具等费用。效果也取决于模型这一次实际看到了什么。
第三件,本地软件里配置的上下文容量。num_ctx、max-model-len这类设置,决定一次会话最长能走多远,也影响预留多少内存。不同软件有的预先分配、有的按需分配,这个数字不完全等于已经占用的内存。
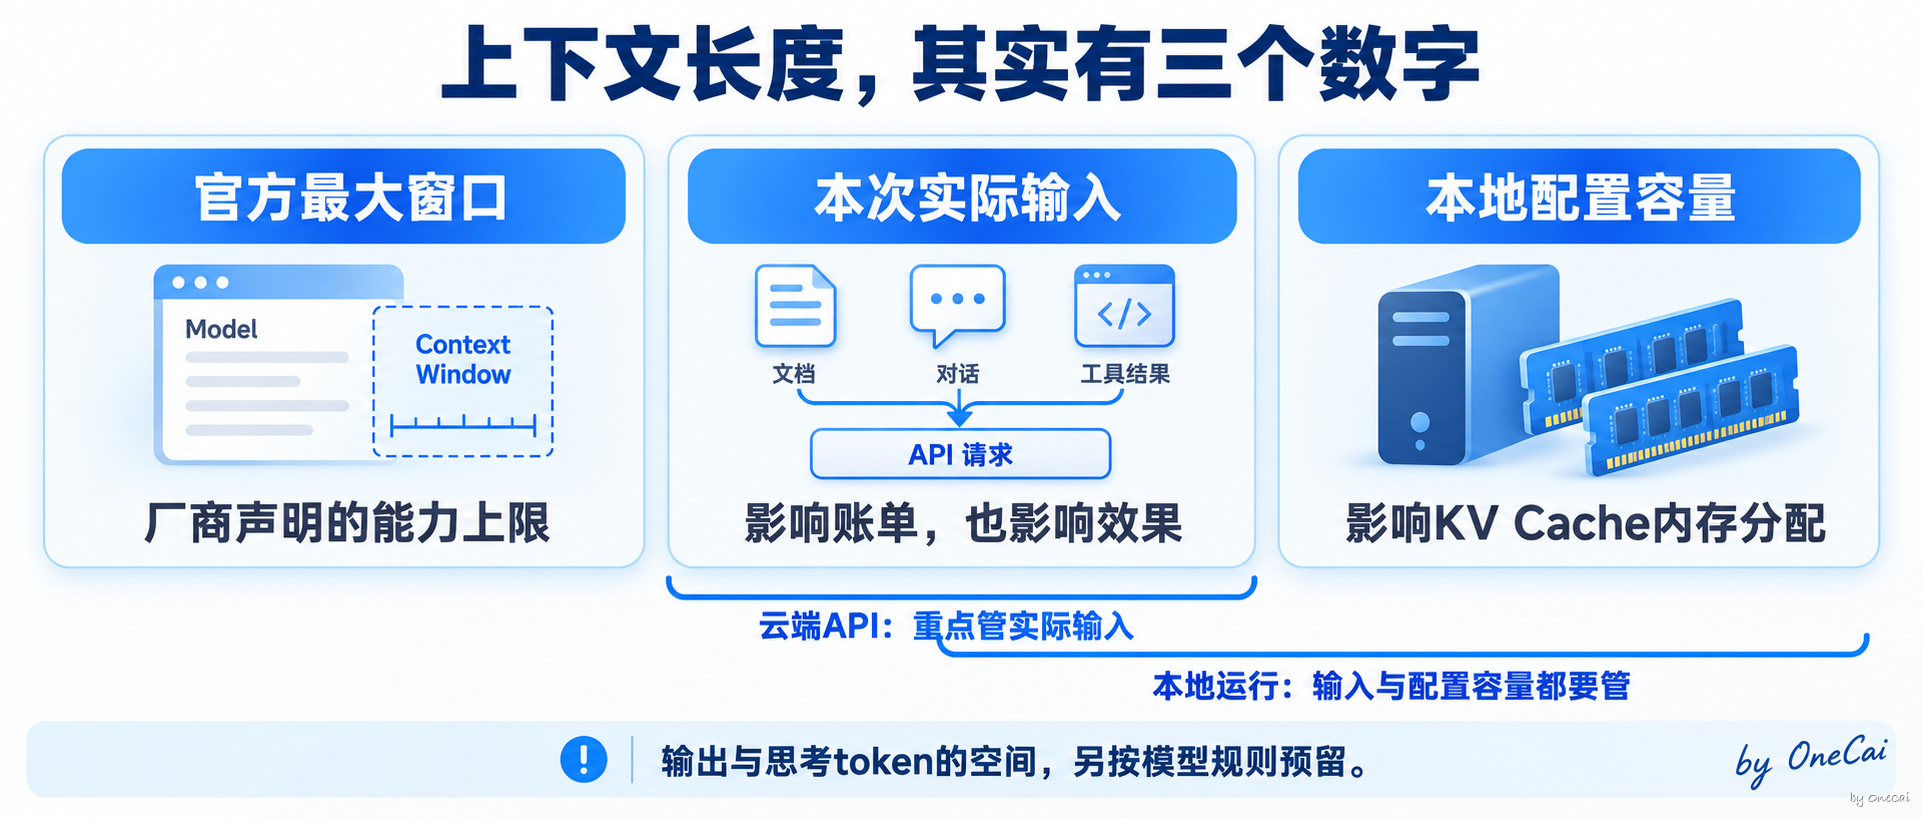
用云端API的人,日常主要管第二件。窗口标着100万,你每次带进去3万,输入费用就按这次的实际计费token算,不会因为窗口上限是100万就收满100万。
本地部署的人,第二、三件都要管:材料不能超过窗口,配置也不能挤掉机器的运行余量。
还有一个容易忽略的细节,同一份材料,换一个模型,token数可能就变了。Anthropic说明,Claude 4.7及之后的模型采用新分词器,同样的文本相比旧分词器大约多出30%的token,实际增幅取决于内容。文件没有变长,只是拆分文本的方法不同。所以后面讲的“涨价线”,都是按各家自己的token数算的,不能拿一家算出的数,直接套另一家的门槛。
二、先从这张表开始
| 任务 | 起点 | 什么时候加长 | 检查什么 |
|---|---|---|---|
| 改代码、复杂推理 | 必要输入先控制在32K以内 | 缺跨文件依赖、缺关键条件 | 能不能通过测试,有没有漏约束 |
| 查资料、找条款 | 按需放宽到128K,不必预先塞满 | 需要跨章节核对 | 引用准不准,有没有漏项 |
| 长文总结、全文比较 | 先整理必要材料,留意计价门槛;无分档时按任务决定 | 任务确实需要全文前后联系,且增加费用可以接受 | 有没有遗漏,有没有混淆来源 |
| 多轮Agent | 定期压缩、移出无用历史 | 后续步骤要用前面的证据 | 旧信息是否在干扰当前任务 |
| 本地24GB Mac | 按模型核算(见第六节) | 材料超过窗口,且内存还有余量 | 有没有持续swap,有没有截断,输出空间够不够 |
这是我的起点假设,不是测出来的最佳值。它依据的是后面几节的公开资料,以及我6月那次本地测试暴露出的容量问题。这篇没有新增实测,也不做2026主流模型的最优配置评选。
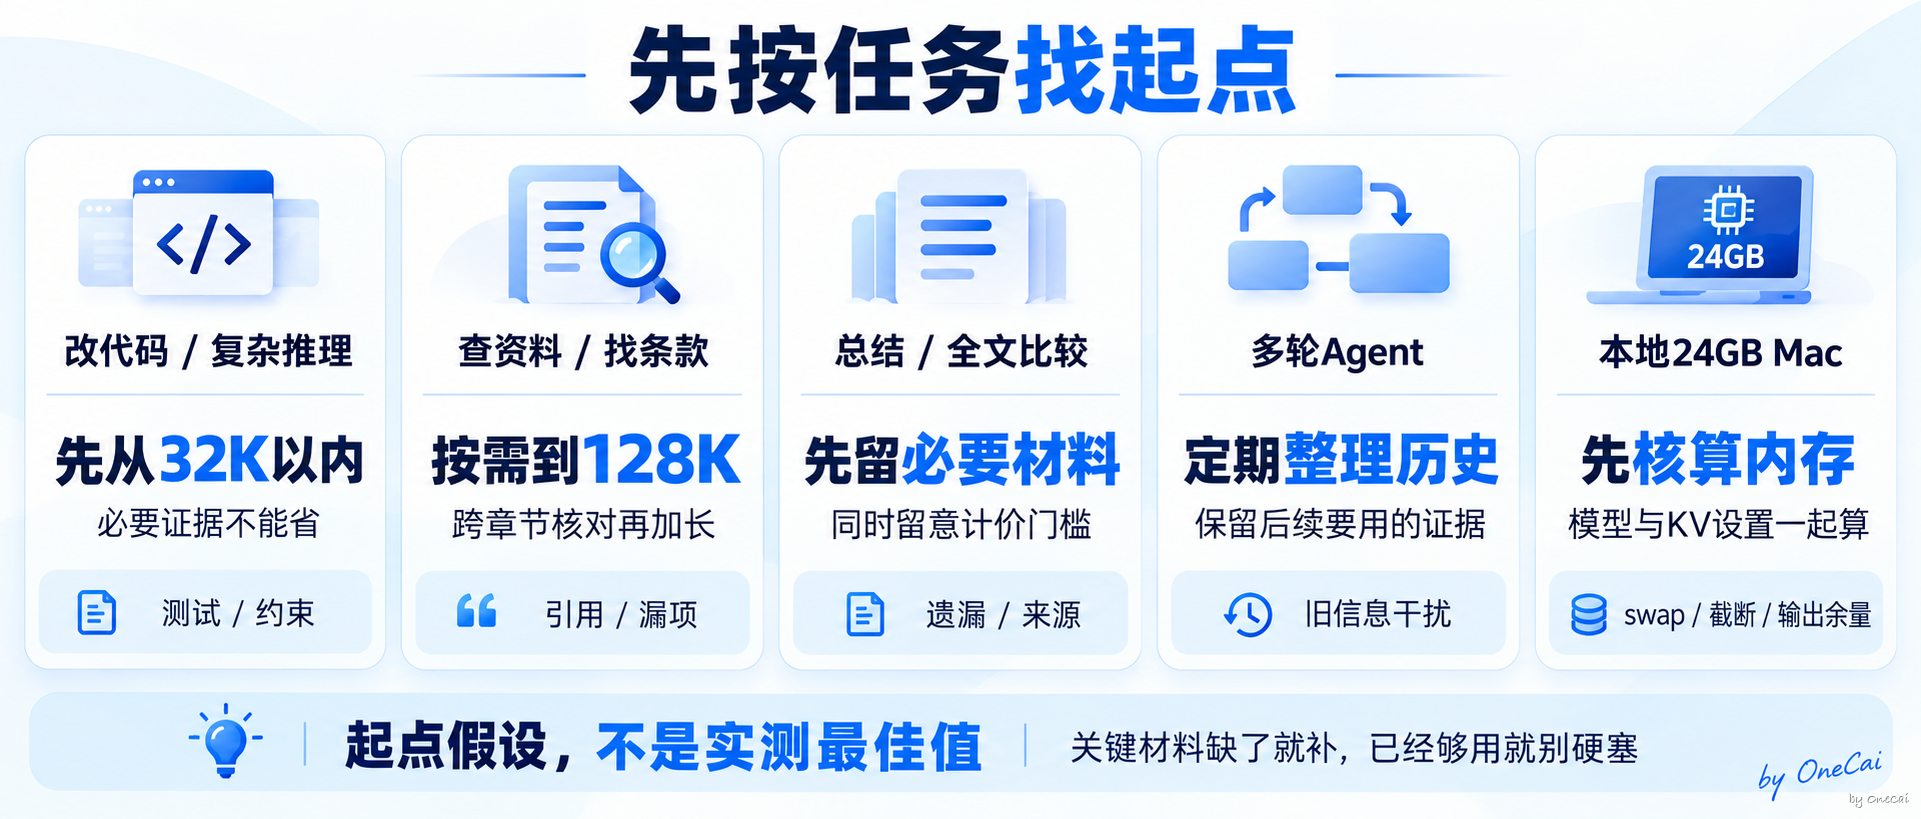
32K不是推理能力的分界线,128K也不是检索可靠的保证。它们的作用是让你从一个能检查的配置出发:缺了关键材料就补,已经够用就别为了填满窗口继续加。
反过来也一样,如果任务就是要比较两份完整的合同,不能为了守住32K把另一份删掉。起点表要服从任务。
三、放得下,不等于用得好
把同一份年报交给模型,可以问三个难度完全不同的问题:
- 找一个数字:“第三季度的研发费用是多少?”——定位,取出来,结束
- 核对矛盾:“管理层讨论、财务附注、风险提示三处对研发费用的说法不一致,原因是什么?”——要同时找出三处,分清季度和累计、调整前和调整后的口径
- 做判断:“据此看,公司的研发投入真的下降了吗?”——还要把数字和口径连起来,判断证据够不够,避免把统计口径的调整当成经营变化
第一件是“找得到”,第二件是“对得上”,第三件是“想得清”。
我们经常看到的MRCR长上下文成绩,主要回答的是检索能力。它包含多目标检索和相似内容区分,比找一个数字复杂,但不能直接保证整份材料的核对和判断都能做对。
2026年的新数据确实好看。OpenAI在GPT-6 Astra的发布页上公布了MRCR v2(8根针)的成绩:
| 上下文区间 | GPT-6 Astra | GPT-5.6 Sol |
|---|---|---|
| 256K–512K | 100.0% | 91.5% |
| 512K–1M | 96.3% | 73.8% |
在这项厂商评测中,512K–1M区间的报告成绩从73.8%提高到96.3%。表注也写得清楚:取各推理强度中的最高成绩,评测环境可能和日常使用不同。这个分数不能直接当成处理任意百万token材料的成功率。
DeepSeek官方模型卡上的数字,把“推理强度”这件事说得更直白:
| DeepSeek V4-Pro | 不思考 | High | Max |
|---|---|---|---|
| MRCR 1M | 44.7 | 83.3 | 83.5 |
| CorpusQA 1M | 35.6 | 56.5 | 62.0 |
同一张厂商评测表中,V4-Pro的MRCR 1M成绩,Max模式为83.5,不思考模式为44.7。模型名称和窗口长度相同,运行档位仍会影响结果。官方API目前默认开启思考,但开启思考不等于采用Max配置,更不保证复现Max成绩。
再看第二行。CorpusQA 1M是长语料问答评测;把它类比成前面的核对任务,只是帮助理解,不能把两者视为同一种测试。DeepSeek列出的V4-Pro Max成绩为62.0,Claude Opus 4.6 Max为71.7,Gemini 3.1 Pro High为53.8。比较时,模型名称后面的配置也要一起保留。
两点提醒:这些都是厂商自己公布的数据;DeepSeek和OpenAI的表格口径也不一样,不能混成一张排名。
《上下文窗口》那篇里讲过的NoLiMa、RULER,测的是上一代模型,不能直接替2026年的新模型下结论。但它们说明了一个至今成立的道理:“找得到”进步了,不代表“对得上”“想得清”同步进步了。
所以我的判断是:先列出任务需要哪些证据,再决定带多少材料。模型支持多长,给不了任务做对的保证。
四、涨价线是账单拐点,不是性价比拐点
这是这篇最硬的一部分,因为它不需要实测,各家官方价格页上白纸黑字写着。
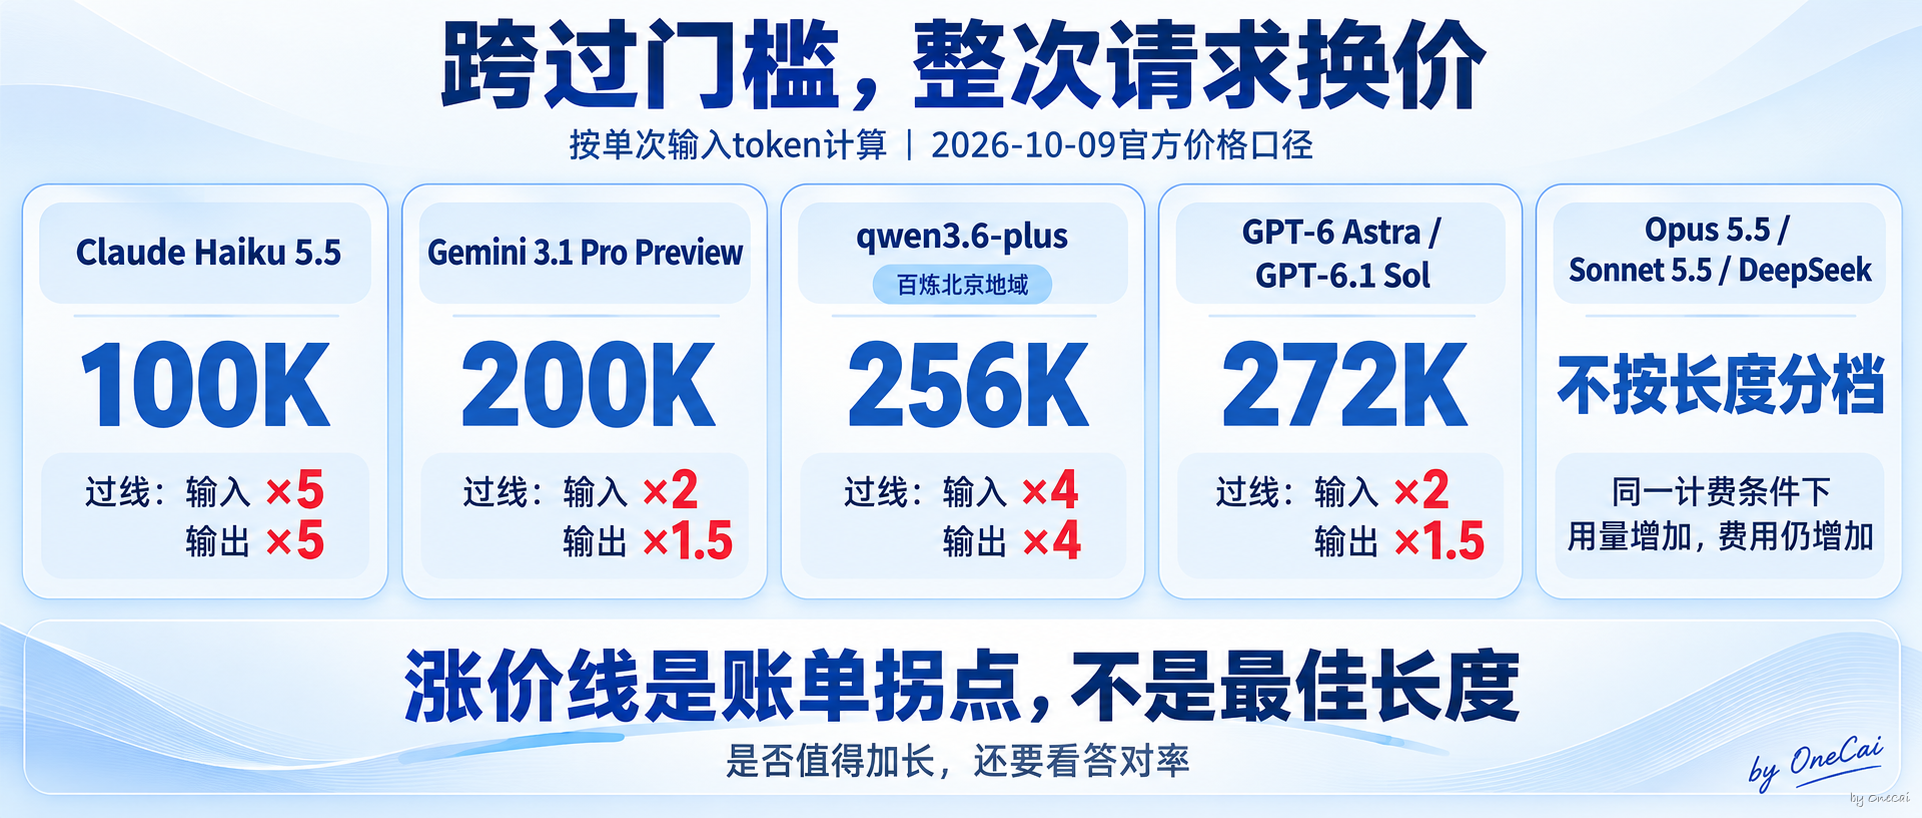
以下是2026年10月9日查询的厂商直连API标准实时调用价格(每百万token)。地域、缓存、Batch、加速模式都可能改变价格:
| 模型 | 涨价线(单次输入) | 门槛以内价格(输入/输出) | 过线后 |
|---|---|---|---|
| GPT-6 Astra | 272K | $10 / $50 | 整次请求输入和缓存×2、输出×1.5 |
| GPT-6.1 Sol | 272K | $2 / $10 | 同上 |
| Gemini 3.1 Pro Preview | 200K | $2 / $12 | $4 / $18 |
| qwen3.6-plus(百炼北京地域) | 256K | 2元 / 12元 | 8元 / 48元 |
| Claude Haiku 5.5 | 100K | $0.10 / $0.50 | $0.50 / $2.50 |
| Claude Opus 5.5、Sonnet 5.5 | 不分档 | $4/$20、$2/$10 | 全窗口同价 |
| DeepSeek(flash、V4-Pro) | 不分档 | 按模型、高峰/低谷、是否命中缓存 | 不按长度加价 |
三个值得停下来看的地方:
第一,涨价线按输入计算,跨过去之后整次请求一起换价。这不是水电费那种只对超出部分加价的算法。以Astra和6.1 Sol为例,输入27.2万还是原价;多1个token,这一整次请求的输入和输出全部按高价算。
第二,qwen3.6-plus过线后输入、输出单价都变成4倍。Haiku 5.5则变成5倍。实际账单上涨多少,还取决于输入增加了多少,以及输出有多长。
第三,一个反常识的地方:Claude的旗舰Opus 5.5全窗口同价,涨价线反而出现在最便宜的Haiku 5.5身上,而且只有100K。便宜模型的“便宜”,是有长度前提的。
把规则代进去,算几笔账。统一假设计费输出为2万token、输入都不命中缓存,不含工具费和免费额度:
| 模型 | 较短输入的费用 | 较长输入的费用 | 输入多了 | 账单变成 |
|---|---|---|---|---|
| GPT-6 Astra | 输入27.2万:约$3.72 | 输入28万:约$7.10 | 2.9% | 约1.9倍 |
| GPT-6.1 Sol | 输入27.2万:约$0.74 | 输入28万:约$1.42 | 2.9% | 约1.9倍 |
| qwen3.6-plus | 输入25万:约0.74元 | 输入30万:约3.36元 | 20% | 约4.5倍 |
| Claude Haiku 5.5 | 输入10万:约$0.02 | 输入12万:约$0.11 | 20% | 约5.5倍 |
不分档的Opus 5.5,输入从25万到30万,账单从约$1.40到约$1.60。输入费用随长度按比例增加,固定输出费用不变。
这些是按官方单价做的计算,不是实测账单,也不是“哪个模型完成同一个任务更便宜”的排名。另外,思考模型的推理token按输出计费,你看到一段两千字的回答,实际计费的输出可能远不止这些。
涨价线是账单的拐点,不是性价比的拐点。
在调用模式、缓存情况和输出长度等条件相同时,跨过去,账单会变贵。划不划算,要看多塞进去的那部分材料有没有让任务更容易做对。多带的5万token如果正好是那份关键的补充协议,翻一倍也值;如果只是几万token重复的日志,就该先整理日志。哪些任务算真需求,在《长上下文是不是越贵越好?》那篇中有四个自查问题,可以直接拿来用。
Agent用户最容易在不知不觉中跨线。你这一轮只问了一句话,但工具可能把之前的对话、代码片段、执行结果一起送回模型。决定档位的是这一轮的完整输入,不是你新打的那句话。好在每次请求单独计价,第15轮跨线,不会让前14轮被追溯加价。
OpenAI在Astra发布页介绍过Codex的新做法,那就是上下文快满时,模型跨窗口记笔记、检索旧内容,而不是一遍遍压缩成摘要。这说明**整理历史本身就是工作流程的一部分。《KV Cache》那篇讲过同样的道理,新草稿要记“状态”,不要抄“流水账”。
**不分档,也不等于长上下文免费。**单价不变,输入费用照样随token数线性增长。同一批材料反复用,可以靠缓存省钱,但缓存命中只是便宜了,这些token并没有从窗口里消失。缓存和错峰的细账,见《Prompt Caching》和DeepSeek错峰定价那两篇。
五、评论里点名的几个模型
DeepSeek V4:先确认你用的是哪个版本。截至查询日,官方API的deepseek-flash对应V4.1-Flash,V4-Pro对应V4-Pro-0813,窗口都是1M,最多输出384K,不按长度分档,但还要区分高峰和低谷、缓存是否命中;低谷价是高峰的一半。长窗口不额外加单价,更多输入仍会增加费用。第三节的高分对应High或Max思考配置,不能把开启思考当成复现成绩的保证,思考token也要计入输出费用。
Gemini 3.5:Flash和Pro不能混着算。截至10月9日,Gemini开发者API的价格页上没有3.5 Pro,3.5系列能查到的是Flash和Flash-Lite,标准价格都不按长度分档。200K这道线属于Gemini 3.1 Pro Preview,不能套在3.5 Flash身上,也不能套用到消费端会员。网上有文章说3.5 Pro已经高价发布,官方页查不到,这里不采信。
Qwen3.6-35B接近200K时无限重复:长度是线索,原因还要排查。这个模型原生窗口是262,144token,用YaRN可以扩到约101万。200K还在原生窗口以内,单凭这条留言,说明不了是超了窗口。
我的排查顺序:
- **算清实际占用。**输入、历史、输出预算加起来是多少?Qwen官方建议大多数任务设置32,768token的输出长度。这是输出预算建议,可以按任务调整;200K输入再加上输出预算后,还要核对提示词、模板和历史是否已经包含在输入计数里。
- 看是不是开了不必要的YaRN。Qwen官方说明,主流框架实现的都是静态YaRN,扩展倍数固定,可能拖累短文本的表现,建议只在确实需要超长上下文时才开
- 核对采样参数。Qwen官方给出的办法是按需调高presence_penalty(0到2之间)来减少无尽重复,但也提醒,调得太高可能出现中英混杂、性能略降。注意:通用思考任务中,35B-A3B推荐1.5,27B推荐0**;精确代码任务**中,两者的思考模式推荐值都是0。参数要按模型和任务选,不能只按是否开启思考来套。
- **核对聊天模板、量化文件和推理软件版本。**一次只改一个变量,才能缩小范围
这几条是排查方向,不是对那位读者机器的诊断。你如果排查出了结果,欢迎回来告诉我。
六、本地机器:内存账要拆开算
在云端,长上下文让你多付钱、多等待;在本地,它还要占用你的内存。
总内存需求 ≈ 权重 + KV Cache及其他状态 + 运行开销 + 系统余量
要给出可复现的内存结论,需要写明模型文件、量化格式、运行软件和版本、K/V缓存类型,以及并发数。下面先分清旧记录和理论计算。
拿我自己这台M4 Pro、24GB的MacBook Pro举例。按《别再被模型名劝退了(下)》里的做法抬高GPU内存上限后,我当时按20–21GB安排模型相关内存。这是旧记录中的预算条件,不是所有24GB Mac都能照搬的稳定上限。
6月那次12个本地模型的比较中,有一条失败记录和这篇直接相关:
deepseek-r1-distill-qwen-32b-mlx:上下文超限(31439 > 16384)
那次的任务是总结一本书,输入被计算为31,439token,配置的窗口只有16,384token。这条记录证明的是**:当时那份输入超过了当时配置的窗口。**它不能单独证明16K最稳,也不能证明更长窗口一定跑不起来。原来评论区那句“本地24GB设16K最稳”,应当收回到具体模型和配置上理解。
换成Qwen3.6-27B,容量账也会改变。旧记录中使用的IQ4_XS权重约14–15GB,曾在这台机器上运行过;这个记录不包含本文64K或128K配置的稳定性验证。下面按官方架构计算缓存,先假定只有一个会话。
- 64层按3层线性注意力加1层全注意力排列,重复16次,逐token保存传统K/V的全注意力层共16层。
- 另外48层线性注意力维护递归状态。其基本状态大小不随历史长度线性增加,但运行时还可能有状态快照、工作区等开销。
- 全注意力层的KV头数为4,每头维度256。
FP16下,全注意力层每token的KV占用=2×16×4×256×2字节=65,536字节=64KiB。
按同样的口径,Qwen3-32B为256KiB/token。因此,Qwen3.6-27B这部分随token增长的KV,占用是前者的四分之一**。这个比例不代表模型总缓存或整机内存也减少到四分之一。**
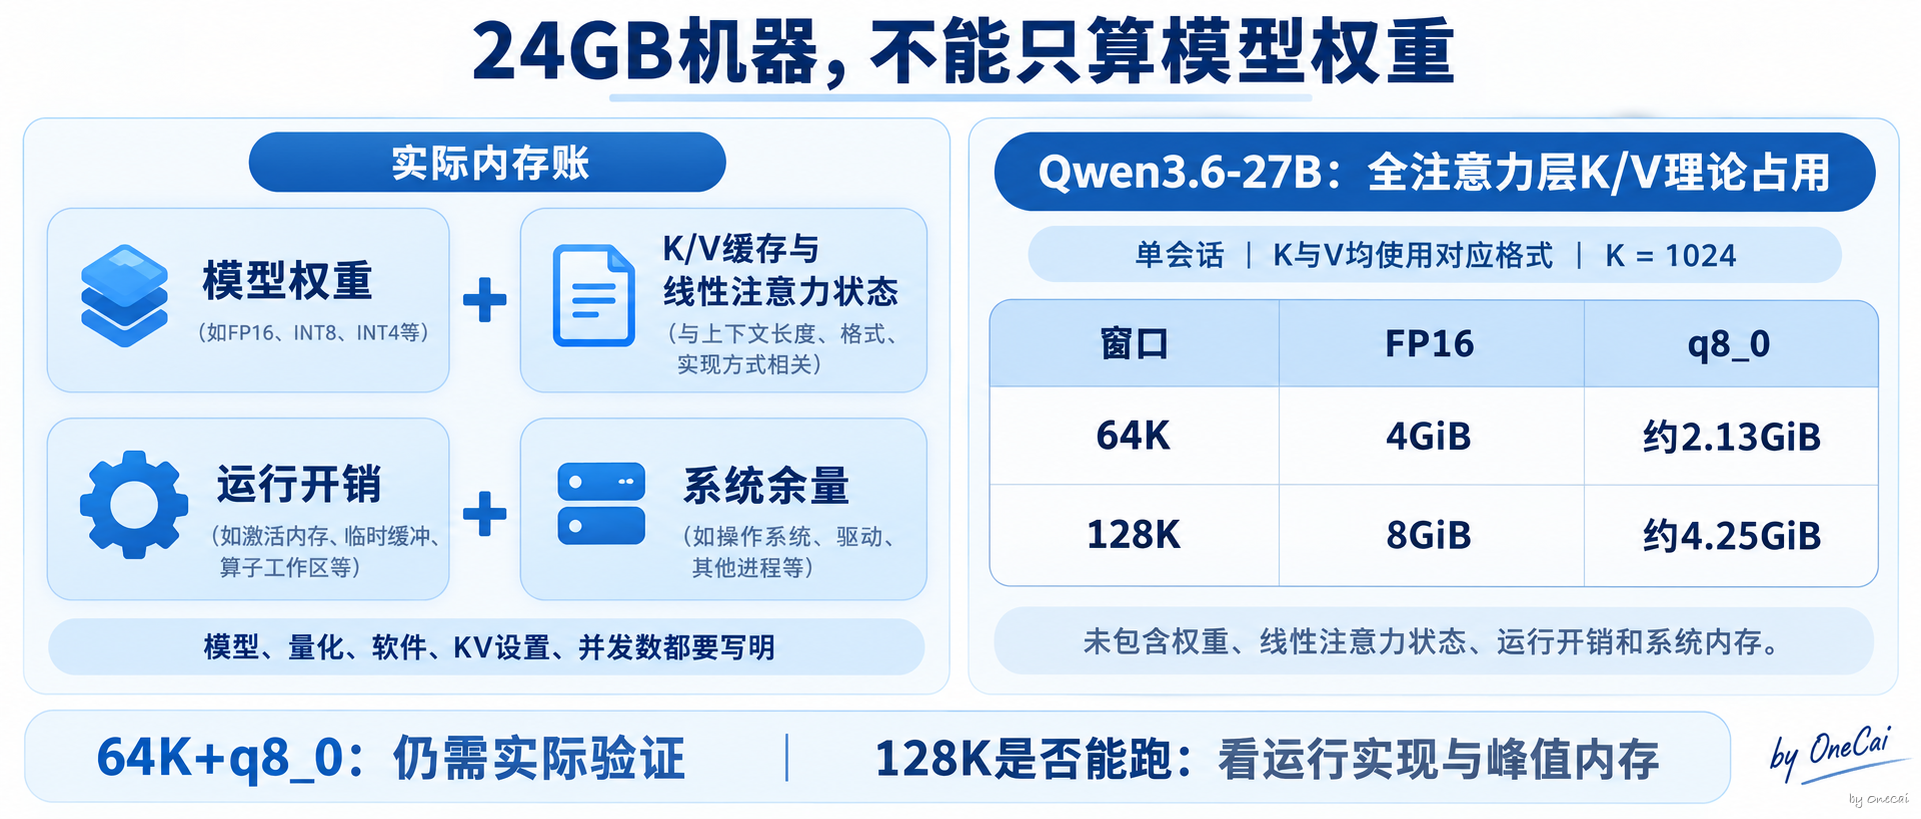
下面的K按1024计算,GiB为二进制容量单位。表格只计算单会话全注意力层的K/V,不含权重、线性注意力状态、工作区和系统余量。
| 上下文容量 | FP16 K/V | 理想8-bit K/V估算 | q8_0 K/V估算 |
|---|---|---|---|
| 16K=16,384token | 1GiB | 0.5GiB | 约0.53GiB |
| 32K=32,768token | 2GiB | 1GiB | 约1.06GiB |
| 64K=65,536token | 4GiB | 2GiB | 约2.13GiB |
| 128K=131,072token | 8GiB | 4GiB | 约4.25GiB |
Q8不能简单理解为每个值恰好占1字节。比如常见的q8_0,每32个值还保存一个2字节的缩放因子,所以上表比理想8-bit稍大。使用这列估算的前提,是运行软件支持给该模型的K和V都使用q8_0;其他格式和实现需要另算。
再看那本书**。31,439是旧模型的输入计数,换成Qwen3.6后必须重新计数。**如果暂时沿用这个数字作粗估,再按Qwen官方建议设置32,768token输出预算,合计为64,207token,距离65,536还有1,329token。这个余量是否够容纳模板和提示词,要看旧计数包含了哪些内容,不能直接宣布64K一定装得下。
32,768也是建议的输出上限,不是总结一本书必须生成这么多。任务只需要较短回答时,可以减少输出预算,同时检查有没有过早截断。
内存预算也要先统一单位。原来的20–21GB预算、14–15GB权重是约数,不能直接与上表的GiB精确相加。以十进制GB粗估,64K的FP16 K/V约4.29GB,q8_0约2.28GB;后者能留下更多空间**。因此,64K加q8_0可以作为待验证配置,不能据此认定已经稳定可用。**
Qwen官方还建议,为保留复杂任务的思考能力,上下文配置尽量维持至少128K。它没有要求每次都输入128K材料,也没有说所有24GB机器都开不了128K。按上表,128K的FP16 K/V约8.59GB,加14–15GB权重,已超过这里的20–21GB预算;q8_0 K/V约4.56GB,加权重后约18.56–19.56GB,剩余空间很紧。是否能运行,还取决于线性状态、运行开销和实际软件支持**,目前不能下“128K做不到”的结论。**
真正尝试长窗口时,需要同时看运行峰值、活动监视器里的内存压力和持续swap,以及首字等待时间。容量估算能排除明显装不下的配置,却给不了生成速度和回答质量的保证。
如果当前配置无法承受任务,可以分段处理并保留带出处的中间结果,或者在适合的任务里关闭思考模式,换小一点的模型,转到云端。关闭思考可能减少生成过程占用的空间,但不能让超长输入自动装进短窗口。
七、怎么找到自己的那一档
这篇没有替你做实测,但你可以拿手头的任务做一次小检查。
**1. 选一个有标准答案的真实任务。**改代码看测试过没过;找条款提前列出必须找到的条目;做总结列出必须包含的信息和不能写错的出处。只看回答流不流畅,很难发现漏了什么。
**2. 固定其他条件。**模型版本、提示词、推理强度、输出上限,全部固定。
**3. 从能装下必要材料的短档开始,逐档加长,每档跑几次。**记下答对几次、漏了什么、等了多久、花了多少钱;本地再看内存压力、swap和有没有截断。
**4. 加长时分两组做。**一组只补任务确实需要的证据,看结果有没有变好;另一组关键证据不变,只往里加无关内容,看模型会不会被带偏。这样才不会把“缺材料导致的错”和“材料太杂导致的错”混在一起。
5. 选能稳定达标、等待和费用都能接受的最短那一档。
如果长上下文确实让任务做对了,就留着它;如果只是让账单变长了,就回去整理材料。
写在最后
把三条线放在一起:
- 能力线:复杂任务先保留必要证据、清理无关内容,再检查遗漏和错误;厂商成绩要连同推理档位一起看
- 价格线:涨价线在100K、200K、256K、272K不等,查清楚你用的那家在哪
- 硬件线:按模型架构、缓存格式和运行软件核算内存,不能仅凭权重装得下就判断长窗口可用
窗口和内存限制决定能不能装下,涨价线提醒你费用如何变化**。先确认必要材料够用、容量足够,再判断增加的费用和等待时间是否值得。**
我自己会这么用:代码和推理,必要输入先压在32K以内;检索按需放宽;全文任务先看清计价门槛;本地部署先把权重、缓存、输出空间和系统余量算清楚。这些是开始干活的配置,不是质量承诺。
窗口是厂商给的上限,涨价线是厂商给的账单提示,真正该用多长,只有你的任务能回答。
资料边界说明
价格、窗口和部署建议按2026年10月9日查询的官方页面整理,模型价格调整频繁,请以各家官方页面当日信息为准。账单算例是作者按官方单价计算的,任务起点是作者的假设;OpenAI、DeepSeek的跑分是厂商公布的结果,不是本文亲测,也不能直接相互排名。
一手官方资料
OpenAI API定价页(GPT-6 Astra、GPT-6.1 Sol、GPT-6 Luna的短上下文/长上下文价格)
OpenAI GPT-6 Astra、GPT-6.1 Sol模型页(272K规则原文)(1)、OpenAI GPT-6 Astra、GPT-6.1 Sol模型页(272K规则原文)(2)
OpenAI GPT-6 Astra发布页(MRCR v2 8-needle成绩,表注说明为各推理强度下的最高分;Codex跨窗口笔记机制)
Anthropic Claude定价页(长上下文定价说明、Haiku 5.5的100K分档、新分词器约多30% token)
Qwen3.6-35B-A3B官方模型卡(原生窗口、静态YaRN对短文本的影响、presence_penalty建议、128K建议、输出长度建议)
Qwen3.6-27B官方配置文件,用于核对层数、KV头数与头维度
GGML量化格式定义,用于计算q8_0每32个值的缩放因子开销
第三方资料
- “Gemini 3.5 Pro已发布”的说法见于部分第三方博客,与Google官方定价页不符,本文不采信
本号实测与计算
- 24GB Mac本地测试记录(31439 > 16384失败案例、Qwen3.6-27B IQ4_XS可运行):来自本号6月28日《12个本地模型,同一份提示词,谁能扛住24GB的内存墙?》,属于作者既有记录,本文不作新的稳定性验证;不用于证明64K或128K配置的稳定性,也不用于证明最佳配置
- 第四节的账单按官方单价计算;第六节的缓存表按官方架构参数与GGML量化格式计算,只涵盖明确列出的缓存部分,均未经本文实测